# ViTMAE
[ViTMAE](https://huggingface.co/papers/2111.06377) es un modelo de visión auto-supervisado que se preentrena enmascarando grandes porciones de una imagen (~75%). Un codificador procesa los parches de imagen visibles y un decodificador reconstruye los píxeles faltantes a partir de los parches codificados y los tokens de máscara. Después del preentrenamiento, el codificador puede reutilizarse para tareas posteriores como la clasificación de imágenes o la detección de objetos, superando con frecuencia a los modelos entrenados con aprendizaje supervisado.
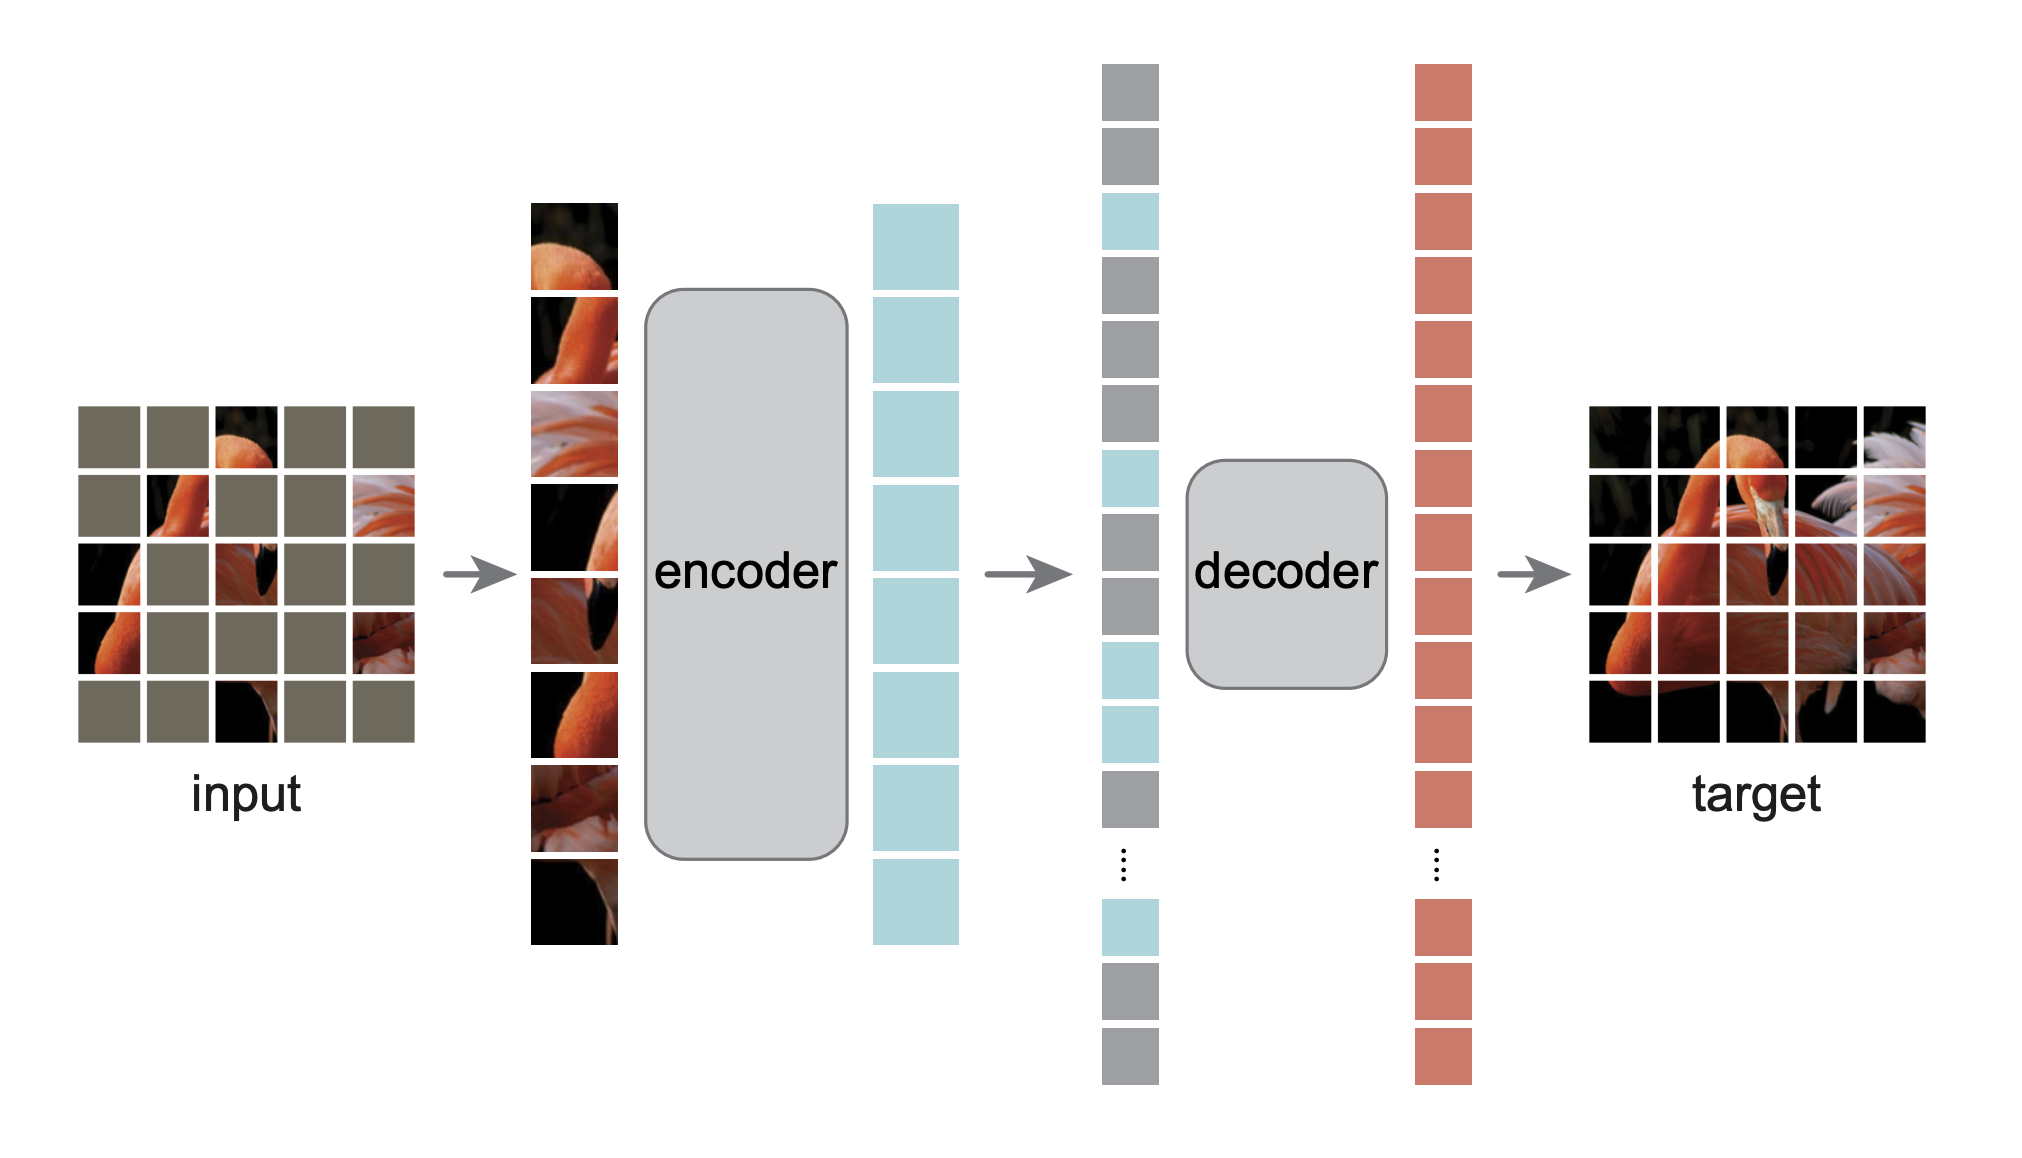 Puedes encontrar todos los puntos de control originales de ViTMAE en la organización [AI at Meta](https://huggingface.co/facebook?search_models=vit-mae).
> [!TIP]
> Haz clic en los modelos ViTMAE en la barra lateral derecha para ver más ejemplos de cómo aplicar ViTMAE a tareas de visión.
El siguiente ejemplo demuestra cómo reconstruir los píxeles faltantes con la clase [ViTMAEForPreTraining](/docs/transformers/v5.23.0/es/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
```python
import requests
import torch
from PIL import Image
from transformers import ViTImageProcessor, ViTMAEForPreTraining
url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"
image = Image.open(requests.get(url, stream=True).raw)
processor = ViTImageProcessor.from_pretrained("facebook/vit-mae-base")
inputs = processor(image, return_tensors="pt").to(model.device)
inputs = {k: v.to(model.device) for k, v in inputs.items()}
model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base", attn_implementation="sdpa", device_map="auto")
with torch.no_grad():
outputs = model(**inputs)
reconstruction = outputs.logits
```
## Notas
- ViTMAE se utiliza típicamente en dos etapas. Primero, un preentrenamiento auto-supervisado con [ViTMAEForPreTraining](/docs/transformers/v5.23.0/es/model_doc/vit_mae#transformers.ViTMAEForPreTraining) y, a continuación, se descarta el decodificador y se ajusta el codificador. Después del ajuste fino, los pesos pueden integrarse en un modelo como [ViTForImageClassification](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTForImageClassification).
- Use [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) para la preparación de la entrada.
## Recursos
- Consulte este [cuaderno](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/ViTMAE/ViT_MAE_visualization_demo.ipynb) para aprender a visualizar los píxeles reconstruidos de [ViTMAEForPreTraining](/docs/transformers/v5.23.0/es/model_doc/vit_mae#transformers.ViTMAEForPreTraining).
## ViTMAEConfig[[transformers.ViTMAEConfig]]
#### transformers.ViTMAEConfig[[transformers.ViTMAEConfig]]
```python
transformers.ViTMAEConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, qkv_bias: bool = True, decoder_num_attention_heads: int = 16, decoder_hidden_size: int = 512, decoder_num_hidden_layers: int = 8, decoder_intermediate_size: int = 2048, mask_ratio: float = 0.75, norm_pix_loss: bool = False)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/configuration_vit_mae.py#L24)
**Parámetros:**
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `12`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
intermediate_size (`int`, *opcional*, valor predeterminado `3072`) : Dimensión de las representaciones MLP.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La probabilidad de dropout para todas las capas completamente conectadas en los embeddings, el codificador y el pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-12`) : El epsilon utilizado por las capas de normalización de capas.
image_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `224`) : El tamaño (resolución) de cada imagen.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opcional*, valor predeterminado `16`) : El tamaño (resolución) de cada parche.
num_channels (`int`, *opcional*, valor predeterminado `3`) : El número de canales de entrada.
qkv_bias (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe añadir un sesgo a las consultas, claves y valores.
decoder_num_attention_heads (`int`, *opcional*, valor predeterminado `16`) : Número de cabezas de atención para cada capa de atención en el decodificador del Transformer.
decoder_hidden_size (`int`, *opcional*, valor predeterminado `512`) : Dimensión de las representaciones ocultas.
decoder_num_hidden_layers (`int`, *opcional*, valor predeterminado 8) : Número de capas ocultas en el decodificador.
decoder_intermediate_size (`int`, *opcional*, valor predeterminado `2048`) : Dimensión de las representaciones MLP.
mask_ratio (`float`, *opcional*, valor predeterminado 0.75) : La proporción de tokens enmascarados en la secuencia de entrada.
norm_pix_loss (`bool`, *opcional*, valor predeterminado `False`) : Indica si se debe entrenar con píxeles normalizados (véase la Tabla 3 del artículo). El uso de píxeles normalizados mejoró la calidad de la representación en los experimentos de los autores.
Esta es la clase de configuración para almacenar la configuración de un ViTMAEModel. Se utiliza para instanciar un modelo Vit Mae según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [facebook/vit-mae-base](https://huggingface.co/facebook/vit-mae-base)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import ViTMAEConfig, ViTMAEModel
>>> # Initializing a ViT MAE vit-mae-base style configuration
>>> configuration = ViTMAEConfig()
>>> # Initializing a model (with random weights) from the vit-mae-base style configuration
>>> model = ViTMAEModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## ViTMAEModel[[transformers.ViTMAEModel]]
#### transformers.ViTMAEModel[[transformers.ViTMAEModel]]
```python
transformers.ViTMAEModel(config: ViTMAEConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L614)
**Parámetros:**
config ([ViTMAEConfig](/docs/transformers/v5.23.0/es/model_doc/vit_mae#transformers.ViTMAEConfig)) : Configuración del modelo.
El modelo Vit Mae básico que emite estados ocultos sin ningún cabezal específico en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.ViTMAEModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L628)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor). Consulte [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obtener más detalles (`processor_class` utiliza [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) para procesar las imágenes).
noise (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Se utiliza principalmente con fines de prueba para controlar la aleatoriedad y mantener la reproducibilidad
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar las codificaciones de posición preentrenadas. Esto se utiliza principalmente para emplear el modelo en imágenes de mayor resolución.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
**Devuelve:** `ViTMAEModelOutput` o `tuple(torch.Tensor)`
Un `ViTMAEModelOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([ViTMAEConfig](/docs/transformers/v5.23.0/es/model_doc/vit_mae#transformers.ViTMAEConfig)) y las entradas.
El método forward de [ViTMAEModel](/docs/transformers/v5.23.0/es/model_doc/vit_mae#transformers.ViTMAEModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **mask** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Tensor que indica qué parches están enmascarados (1) y cuáles no (0).
- **ids_restore** (`torch.LongTensor` de forma `(batch_size, sequence_length)`) -- Tensor que contiene el índice original de los parches enmascarados (barajados).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import AutoImageProcessor, ViTMAEModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEModel.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
```
## ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
#### transformers.ViTMAEForPreTraining[[transformers.ViTMAEForPreTraining]]
```python
transformers.ViTMAEForPreTraining(config: ViTMAEConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L691)
**Parámetros:**
config ([ViTMAEConfig](/docs/transformers/v5.23.0/es/model_doc/vit_mae#transformers.ViTMAEConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El transformer del modelo ViTMAE con el decodificador en la parte superior para el preentrenamiento auto-supervisado.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.ViTMAEForPreTraining.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, noise: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool | None = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/vit_mae/modeling_vit_mae.py#L790)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`, *opcional*) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener usando [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor). Consulte [ViTImageProcessor.__call__()](/docs/transformers/v5.23.0/es/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) para obtener más detalles (`processor_class` utiliza [ViTImageProcessor](/docs/transformers/v5.23.0/es/model_doc/vit#transformers.ViTImageProcessor) para procesar las imágenes).
noise (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Se utiliza principalmente con fines de prueba para controlar la aleatoriedad y mantener la reproducibilidad
interpolate_pos_encoding (`bool`, *opcional*, valor predeterminado `False`) : Si se debe interpolar las codificaciones de posición preentrenadas. Esto se utiliza principalmente para emplear el modelo en imágenes de mayor resolución.
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
**Devuelve:** `ViTMAEForPreTrainingOutput` o `tuple(torch.Tensor)`
Un `ViTMAEForPreTrainingOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([ViTMAEConfig](/docs/transformers/v5.23.0/es/model_doc/vit_mae#transformers.ViTMAEConfig)) y las entradas.
El método forward de [ViTMAEForPreTraining](/docs/transformers/v5.23.0/es/model_doc/vit_mae#transformers.ViTMAEForPreTraining) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`) -- Pérdida de reconstrucción de píxeles.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, patch_size ** 2 * num_channels)`) -- Logits de reconstrucción de píxeles.
- **mask** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Tensor que indica qué parches están enmascarados (1) y cuáles no (0).
- **ids_restore** (`torch.LongTensor` de forma `(batch_size, sequence_length)`) -- Tensor que contiene el índice original de los parches enmascarados (barajados).
- **hidden_states** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplos:
```python
>>> from transformers import AutoImageProcessor, ViTMAEForPreTraining
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read())).convert("RGB")
>>> image_processor = AutoImageProcessor.from_pretrained("facebook/vit-mae-base")
>>> model = ViTMAEForPreTraining.from_pretrained("facebook/vit-mae-base")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> loss = outputs.loss
>>> mask = outputs.mask
>>> ids_restore = outputs.ids_restore
```