# GLPN
Il s'agit d'un modèle récemment introduit, de sorte que l'API n'a pas encore été testée de manière exhaustive. Il est possible que des bugs ou de légères modifications cassantes subsistent et devront être corrigés à l'avenir. Si vous remarquez un comportement inattendu, veuillez ouvrir un [Github Issue](https://github.com/huggingface/transformers/issues/new?assignees=&labels=&template=bug-report.md&title).
## Aperçu
Le modèle GLPN a été proposé dans [Global-Local Path Networks for Monocular Depth Estimation with Vertical CutDepth](https://huggingface.co/papers/2201.07436) par Doyeon Kim, Woonghyun Ga, Pyungwhan Ahn, Donggyu Joo, Sehwan Chun et Junmo Kim. GLPN combine le mix-Transformer hiérarchique de [SegFormer](segformer) avec un décodeur léger pour l'estimation de la profondeur monoculaire. Le décodeur proposé offre de meilleures performances que les décodeurs précédemment proposés, avec une complexité de calcul considérablement réduite.
L'abstract de l'article est le suivant :
*L’estimation de la profondeur à partir d’une image unique est une tâche importante qui peut être appliquée à divers domaines de la vision par ordinateur, et qui a connu un essor rapide avec le développement des réseaux de neurones convolutifs. Dans cet article, nous proposons une nouvelle structure et une stratégie d’entraînement pour l’estimation de la profondeur monoculaire afin d’améliorer davantage la précision des prédictions du réseau. Nous déployons un encodeur transformer hiérarchique pour capturer et transmettre le contexte global, et concevons un décodeur léger mais puissant pour générer une carte de profondeur estimée tout en tenant compte de la connectivité locale. En construisant des chemins connectés entre les caractéristiques locales multi-échelles et le flux de décodage global grâce à notre module de fusion de caractéristiques sélective proposé, le réseau peut intégrer les deux représentations et récupérer les détails fins. De plus, le décodeur proposé montre de meilleures performances que les décodeurs précédemment proposés, avec une complexité computationnelle considérablement réduite. En outre, nous améliorons la méthode d’augmentation spécifique à la profondeur en exploitant une observation importante dans l’estimation de la profondeur pour renforcer le modèle. Notre réseau atteint des performances de pointe sur le jeu de données de profondeur difficile NYU Depth V2. Des expériences exhaustives ont été menées pour valider et démontrer l’efficacité de l’approche proposée. Enfin, notre modèle montre une meilleure capacité de généralisation et une meilleure robustesse que les autres modèles comparatifs.*
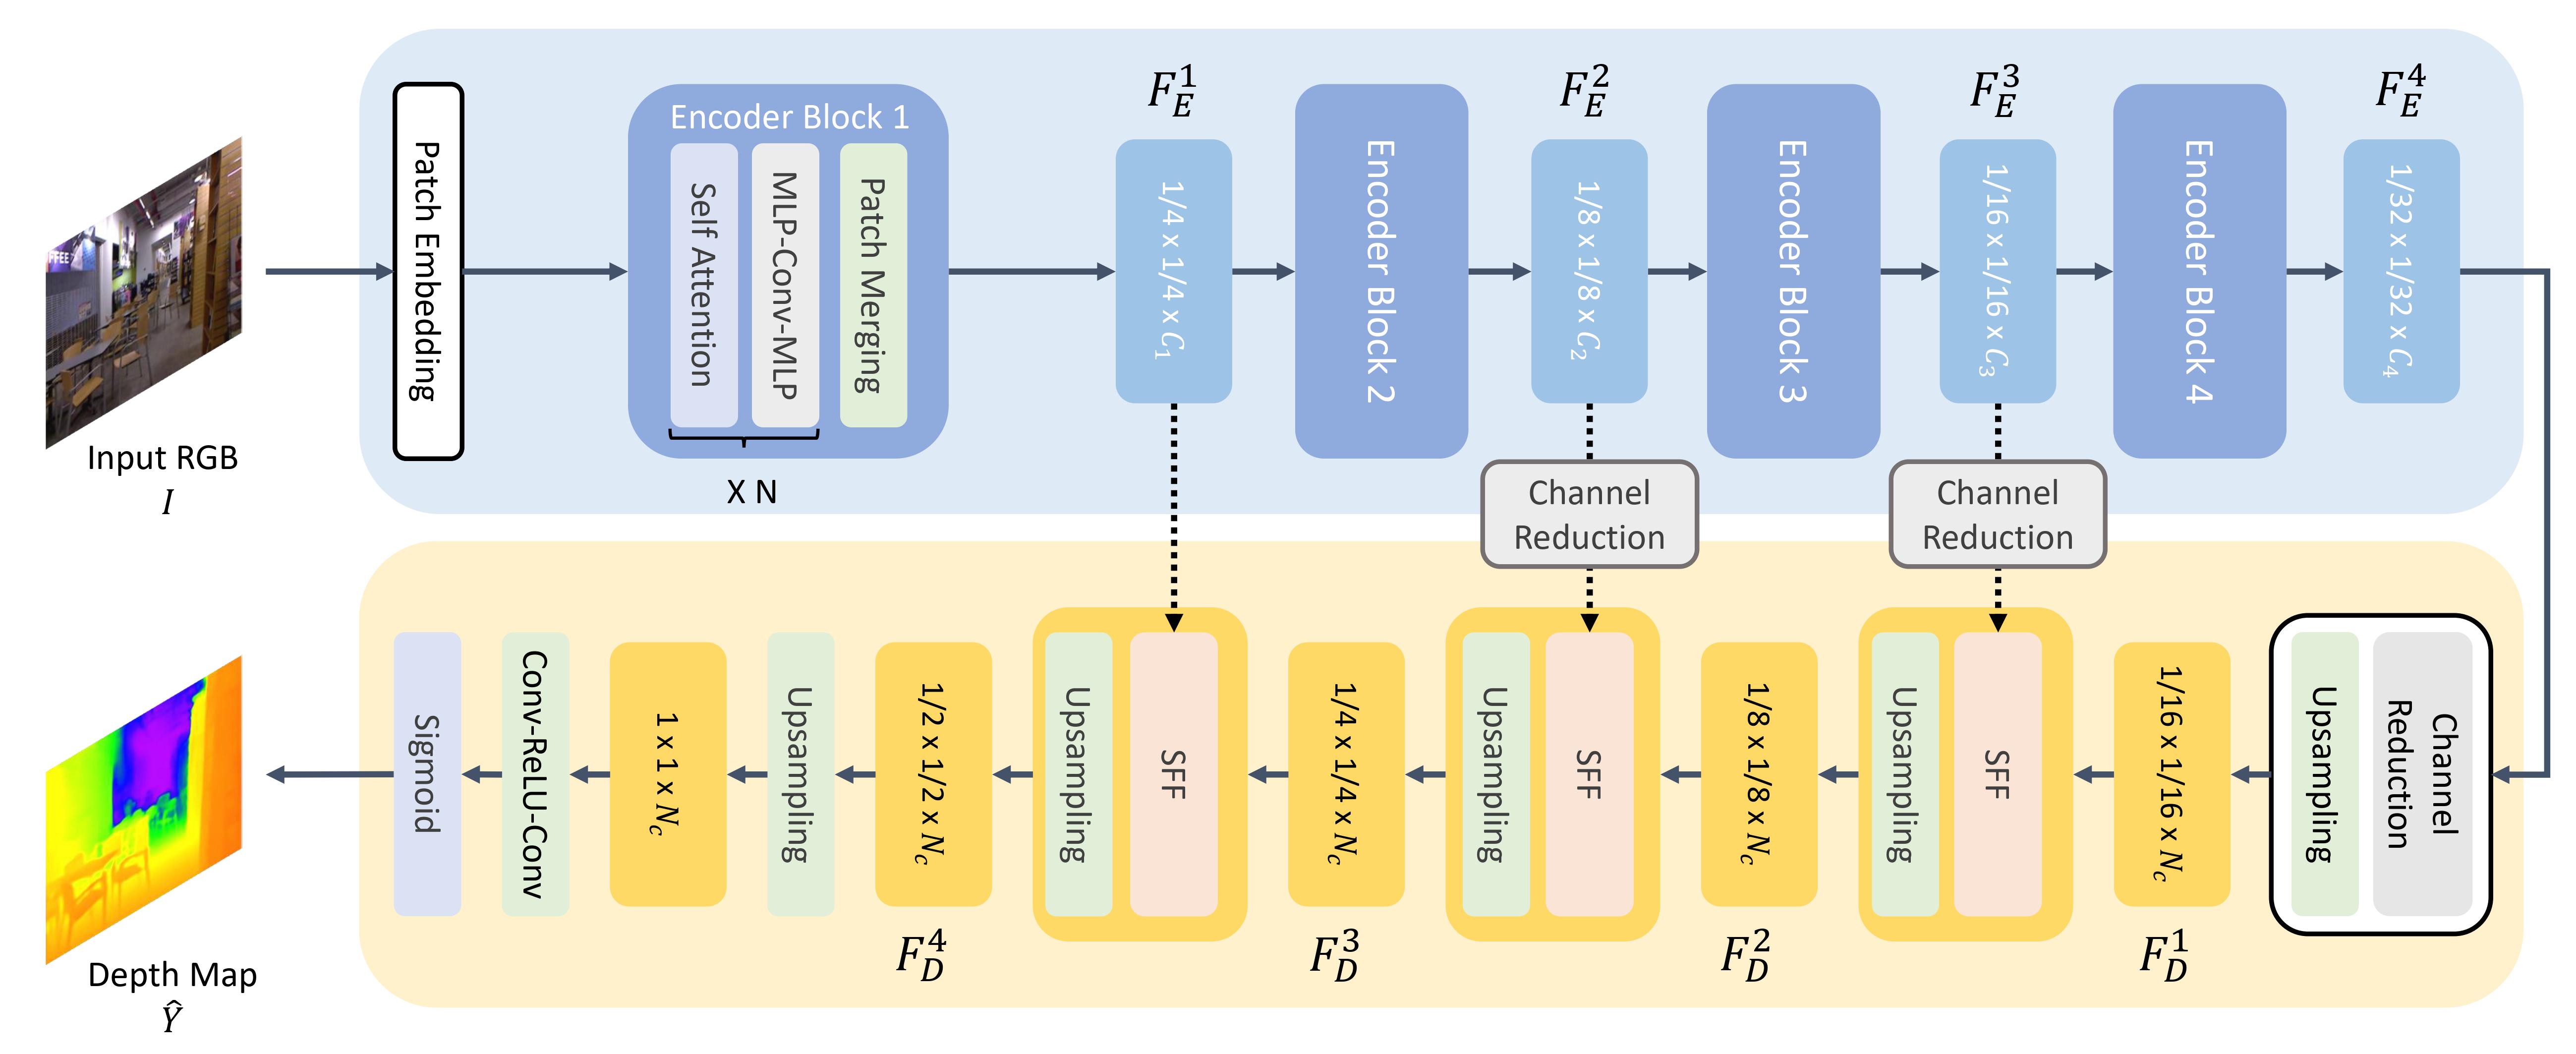 Résumé de l'approche. Tiré de l'article original.
Ce modèle a été contribué par [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/vinvino02/GLPDepth).
## Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec GLPN.
- Les notebooks de démonstration pour [GLPNForDepthEstimation](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNForDepthEstimation) sont disponibles [ici](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/GLPN).
- [Guide de la tâche d'estimation de profondeur monoculaire](../tasks/monocular_depth_estimation)
## GLPNConfig[[transformers.GLPNConfig]]
#### transformers.GLPNConfig[[transformers.GLPNConfig]]
```python
transformers.GLPNConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, num_channels: int = 3, num_encoder_blocks: int = 4, depths: list[int] | tuple[int, ...] = (2, 2, 2, 2), sr_ratios: list[int] | tuple[int, ...] = (8, 4, 2, 1), hidden_sizes: list[int] | tuple[int, ...] = (32, 64, 160, 256), patch_sizes: list[int] | tuple[int, ...] = (7, 3, 3, 3), strides: list[int] | tuple[int, ...] = (4, 2, 2, 2), num_attention_heads: list[int] | tuple[int, ...] = (1, 2, 5, 8), mlp_ratios: list[int] | tuple[int, ...] = (4, 4, 4, 4), hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, drop_path_rate: float | int = 0.1, layer_norm_eps: float = 1e-06, decoder_hidden_size: int = 64, max_depth: int = 10, head_in_index: int = -1)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/glpn/configuration_glpn.py#L24)
**Paramètres :**
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
num_encoder_blocks (`int`, *facultatif*, valeur par défaut : 4) : Le nombre de blocs d'encodeur (c'est-à-dire les étapes de l'encodeur Mix Transformer).
depths (`list[int]`, *facultatif*, par défaut `[2, 2, 2, 2]`) : Le nombre de couches dans chaque bloc d'encodeur.
sr_ratios (`list[int]`, *facultatif*, par défaut `[8, 4, 2, 1]`) : Ratios de réduction de séquence dans chaque bloc d'encodeur.
hidden_sizes (`Union[list[int], tuple[int, ...]]`, *facultatif*, valeur par défaut `(32, 64, 160, 256)`) : Dimensionnalité (taille cachée) à chaque étape du modèle.
patch_sizes (`list[int]`, *facultatif*, par défaut `[7, 3, 3, 3]`) : Taille des patches avant chaque bloc d'encodeur.
strides (`list[int]`, *facultatif*, par défaut `[4, 2, 2, 2]`) : Pas avant chaque bloc d'encodeur.
num_attention_heads (`list[int]`, *facultatif*, valeur par défaut `[1, 2, 5, 8]`) : Nombre de têtes d'attention pour chaque couche d'attention de chaque bloc de l'encodeur Transformer.
mlp_ratios (`list[int]`, *facultatif*, par défaut `[4, 4, 4, 4]`) : Ratio de la taille de la couche cachée par rapport à la taille de la couche d'entrée des Mix FFNs dans les blocs encodeur.
hidden_act (`str`, *facultatif*, par défaut `gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : La probabilité de dropout pour toutes les couches entièrement connectées des embeddings, de l'encodeur et du pooler.
attention_probs_dropout_prob (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
drop_path_rate (`Union[float, int]`, *facultatif*, valeur par défaut `0.1`) : Taux de drop path pour la fusion des patches.
layer_norm_eps (`float`, *facultatif*, par défaut `1e-06`) : L'épsilon utilisé par les couches de normalisation par couche.
decoder_hidden_size (`int`, *facultatif*, valeur par défaut 64) : La dimension du décodeur.
max_depth (`int`, *facultatif*, valeur par défaut : 10) : La profondeur maximale du décodeur.
head_in_index (`int`, *facultatif*, valeur par défaut : -1) : L'index des fonctionnalités à utiliser dans la tête.
Ceci est la classe de configuration destinée à stocker la configuration d'un GLPNModel. Elle est utilisée pour instancier un modèle Glpn en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [vinvino02/glpn-kitti](https://huggingface.co/vinvino02/glpn-kitti)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/v5.23.0/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import GLPNModel, GLPNConfig
>>> # Initializing a GLPN vinvino02/glpn-kitti style configuration
>>> configuration = GLPNConfig()
>>> # Initializing a model from the vinvino02/glpn-kitti style configuration
>>> model = GLPNModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GLPNImageProcessor[[transformers.GLPNImageProcessor]]
#### transformers.GLPNImageProcessor[[transformers.GLPNImageProcessor]]
```python
transformers.GLPNImageProcessor(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/glpn/image_processing_glpn.py#L51)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, *facultatif*, valeur par défaut 32) : lorsque `do_resize` est `True`, les images sont redimensionnées de sorte que leur hauteur et leur largeur soient arrondies à la valeur inférieure au multiple le plus proche de `size_divisor`.
Construit un processeur d’image GLPNImageProcessor.
#### prétraiter[[transformers.GLPNImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/glpn/image_processing_glpn.py#L70)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, *facultatif*, valeur par défaut 32) : lorsque `do_resize` est `True`, les images sont redimensionnées de sorte que leur hauteur et leur largeur soient arrondies à la valeur inférieure au multiple le plus proche de `size_divisor`.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## GLPNImageProcessorPil[[transformers.GLPNImageProcessorPil]]
#### transformers.GLPNImageProcessorPil[[transformers.GLPNImageProcessorPil]]
```python
transformers.GLPNImageProcessorPil(**kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/glpn/image_processing_pil_glpn.py#L46)
**Paramètres :**
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut par défaut redimensionner l'image en un carré si la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, par défaut `2`) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*, valeur par défaut `True`) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*, valeur par défaut `0.00392156862745098`) : Facteur de remise à l'échelle appliqué à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, *facultatif*, valeur par défaut 32) : lorsque `do_resize` est `True`, les images sont redimensionnées de sorte que leur hauteur et leur largeur soient arrondies à la valeur inférieure au multiple le plus proche de `size_divisor`.
Construit un processeur d’image GLPNImageProcessor.
#### prétraiter[[transformers.GLPNImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/glpn/image_processing_pil_glpn.py#L65)
**Paramètres :**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Image à prétraiter. Attend une image unique ou un lot d'images dont les valeurs de pixels sont comprises entre 0 et 255. Si vous transmettez des images dont les valeurs de pixels sont comprises entre 0 et 1, définissez `do_rescale=False`.
do_convert_rgb (`bool`, *kwargs*, *facultatif*) : Indique s'il faut convertir l'image en RGB.
do_resize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut redimensionner l'image.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Décrit les dimensions d'entrée maximales du modèle.
default_to_square (`bool`, *kwargs*, *facultatif*) : Indique s'il faut par défaut redimensionner l'image en un carré lorsque la taille est un entier.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Taille de l'image de sortie après application de `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtre de rééchantillonnage à utiliser lors du redimensionnement de l'image. Il peut s'agir d'une des valeurs de l'énumération `PILImageResampling`. N'a un effet que si `do_resize` est défini sur `True`.
do_rescale (`bool`, *kwargs*, *facultatif*) : Indique s'il faut rééchelonner l'image.
rescale_factor (`float`, *kwargs*, *facultatif*) : Facteur de redimensionnement à appliquer à l'image si `do_rescale` est défini sur `True`.
do_normalize (`bool`, *kwargs*, *facultatif*) : Indique s'il faut normaliser l'image.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Moyenne de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *facultatif*) : Écart-type de l'image à utiliser pour la normalisation. N'a un effet que si `do_normalize` est défini sur `True`.
do_pad (`bool`, *kwargs*, *facultatif*) : Indique s'il faut ajouter un rembourrage à l'image. Le rembourrage est effectué soit jusqu'à la plus grande taille du lot, soit jusqu'à une taille carrée fixe par image. La stratégie de rembourrage exacte dépend du modèle.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : La taille au format `{"height": int, "width" int}` à laquelle rembourrer les images. Elle doit être supérieure à la taille de n'importe quelle image fournie pour le prétraitement. Si `pad_size` n'est pas fourni, les images seront rembourrées à la hauteur et à la largeur maximales du lot. Appliqué uniquement lorsque `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *facultatif*) : Indique s'il faut effectuer un recadrage centré de l'image.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Seul `ChannelDimension.FIRST` est pris en charge. Ajouté pour assurer la compatibilité avec les processeurs lents.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *facultatif*) : Le format de la dimension des canaux pour l'image d'entrée. Si non défini, le format de la dimension des canaux est déduit de l'image d'entrée. Peut être l'un des éléments suivants : - `"channels_first"` ou `ChannelDimension.FIRST` : image au format (num_channels, height, width). - `"channels_last"` ou `ChannelDimension.LAST` : image au format (height, width, num_channels). - `"none"` ou `ChannelDimension.NONE` : image au format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : L'appareil sur lequel traiter les vidéos. Si non défini, l'appareil est déduit des vidéos d'entrée.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Renvoie des tenseurs empilés si la valeur est `'pt'`, sinon renvoie une liste de tenseurs.
disable_grouping (`bool`, *kwargs*, *facultatif*) : Indique s'il faut désactiver le regroupement des images par taille afin de les traiter individuellement plutôt que par lots. Si la valeur est None, elle sera définie sur True si les images sont sur CPU, et sur False dans le cas contraire. Ce choix repose sur des observations empiriques, comme détaillé ici : https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *facultatif*) : Le nombre de jetons d'image à utiliser pour chaque image de l'entrée. Ajouté pour la compatibilité ascendante, mais cela devrait être défini comme un attribut du processeur dans les futurs modèles.
size_divisor (`int`, *kwargs*, *facultatif*, valeur par défaut 32) : lorsque `do_resize` est `True`, les images sont redimensionnées de sorte que leur hauteur et leur largeur soient arrondies à la valeur inférieure au multiple le plus proche de `size_divisor`.
**Retourne :** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionnaire de listes/tableaux/tenseurs renvoyé par la méthode __call__ (« pixel_values », etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *facultatif*) -- Vous pouvez spécifier un tensor_type ici pour convertir les listes d'entiers en tenseurs PyTorch/Numpy lors de l'initialisation.
## GLPNModel[[transformers.GLPNModel]]
#### transformers.GLPNModel[[transformers.GLPNModel]]
```python
transformers.GLPNModel(config: GLPNConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/glpn/modeling_glpn.py#L377)
**Paramètres :**
config ([GLPNConfig](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle Glpn brut, qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.GLPNModel.forward]]
```python
forward(pixel_values: Tensor, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/glpn/modeling_glpn.py#L389)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d’entrée. Les valeurs des pixels peuvent être obtenues à l’aide de [GLPNImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNImageProcessor). Voir [GLPNImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [GLPNImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNImageProcessor) pour le traitement des images).
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
**Retourne :** [BaseModelOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutput) ou `tuple(torch.Tensor)`
Un [BaseModelOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([GLPNConfig](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNConfig)) et les entrées.
La méthode forward de [GLPNModel](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemple :
```python
```
## GLPNForDepthEstimation[[transformers.GLPNForDepthEstimation]]
#### transformers.GLPNForDepthEstimation[[transformers.GLPNForDepthEstimation]]
```python
transformers.GLPNForDepthEstimation(config: GLPNConfig)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/glpn/modeling_glpn.py#L565)
**Paramètres :**
config ([GLPNConfig](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L’initialisation à partir d’un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Transformateur de modèle GLPN avec une tête d'estimation de profondeur légère au sommet, par exemple pour KITTI, NYUv2.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/v5.23.0/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.GLPNForDepthEstimation.forward]]
```python
forward(pixel_values: Tensor, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/glpn/modeling_glpn.py#L576)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d’entrée. Les valeurs des pixels peuvent être obtenues à l’aide de [GLPNImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNImageProcessor). Voir [GLPNImageProcessor.__call__()](/docs/transformers/v5.23.0/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails (`processor_class` utilise [GLPNImageProcessor](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNImageProcessor) pour le traitement des images).
labels (`torch.Tensor` de forme `(batch_size, height, width)`, *facultatif*) : Cartes d'estimation de profondeur de référence pour le calcul de la perte.
output_attentions (`bool`, *facultatif*) : Indique s'il faut ou non retourner les tenseurs d'attention de toutes les couches d'attention. Voir `attentions` sous les tenseurs retournés pour plus de détails.
output_hidden_states (`bool`, *facultatif*) : Indique s'il faut retourner les états cachés de toutes les couches. Voir `hidden_states` dans les tenseurs retournés pour plus de détails.
return_dict (`bool`, *facultatif*) : Indique s'il faut retourner un [ModelOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.utils.ModelOutput) plutôt qu'un simple tuple.
**Retourne :** [DepthEstimatorOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.DepthEstimatorOutput) ou `tuple(torch.Tensor)`
Un [DepthEstimatorOutput](/docs/transformers/v5.23.0/fr/main_classes/output#transformers.modeling_outputs.DepthEstimatorOutput) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([GLPNConfig](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNConfig)) et les entrées.
La méthode forward de [GLPNForDepthEstimation](/docs/transformers/v5.23.0/fr/model_doc/glpn#transformers.GLPNForDepthEstimation) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `labels` est fourni) -- Perte de classification (ou de régression si config.num_labels==1).
- **predicted_depth** (`torch.Tensor` de forme `(batch_size, height, width)`) -- Profondeur prédite pour chaque pixel.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d'embedding, + un pour la sortie de chaque couche) de forme `(batch_size, num_channels, height, width)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, patch_size, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import AutoImageProcessor, GLPNForDepthEstimation
>>> import torch
>>> import numpy as np
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("vinvino02/glpn-kitti")
>>> model = GLPNForDepthEstimation.from_pretrained("vinvino02/glpn-kitti")
>>> # prepare image for the model
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> # interpolate to original size
>>> post_processed_output = image_processor.post_process_depth_estimation(
... outputs,
... target_sizes=[(image.height, image.width)],
... )
>>> # visualize the prediction
>>> predicted_depth = post_processed_output[0]["predicted_depth"]
>>> depth = predicted_depth * 255 / predicted_depth.max()
>>> depth = depth.detach().cpu().numpy()
>>> depth = Image.fromarray(depth.astype("uint8"))
```