# UDOP
## Ikhtisar
Model UDOP diusulkan dalam [Unifying Vision, Text, and Layout for Universal Document Processing](https://huggingface.co/papers/2212.02623) oleh Zineng Tang, Ziyi Yang, Guoxin Wang, Yuwei Fang, Yang Liu, Chenguang Zhu, Michael Zeng, Cha Zhang, Mohit Bansal. UDOP mengadopsi arsitektur Transformer encoder-decoder yang berbasis pada [T5](t5) untuk tugas-tugas document AI seperti klasifikasi gambar dokumen, parsing dokumen, dan visual question answering dokumen.
Abstrak dari makalah tersebut adalah sebagai berikut:
Kami mengusulkan Universal Document Processing (UDOP), sebuah model dasar Document AI yang menyatukan modalitas teks, gambar, dan tata letak bersama dengan berbagai format tugas, termasuk pemahaman dan generasi dokumen. UDOP memanfaatkan korelasi spasial antara konten teks dan gambar dokumen untuk memodelkan modalitas gambar, teks, dan tata letak dengan satu representasi seragam. Dengan Vision-Text-Layout Transformer yang baru, UDOP menyatukan pra-pelatihan dan tugas turunan multi-domain ke dalam skema generasi sekuens berbasis prompt. UDOP dilatih secara pra-pelatihan pada korpus dokumen berskala besar tanpa label menggunakan tujuan self-supervised yang inovatif serta data berlabel yang beragam. UDOP juga belajar menghasilkan gambar dokumen dari modalitas teks dan tata letak melalui rekonstruksi gambar ter-mask. Sejauh pengetahuan kami, ini adalah pertama kalinya di bidang Document AI bahwa satu model secara simultan mencapai pengeditan dokumen neural berkualitas tinggi dan kustomisasi konten. Metode kami menetapkan state-of-the-art pada 9 tugas Document AI, misalnya pemahaman dokumen dan QA, di berbagai domain data seperti laporan keuangan, makalah akademik, dan situs web. UDOP menempati peringkat pertama di papan peringkat Document Understanding Benchmark (DUE).*
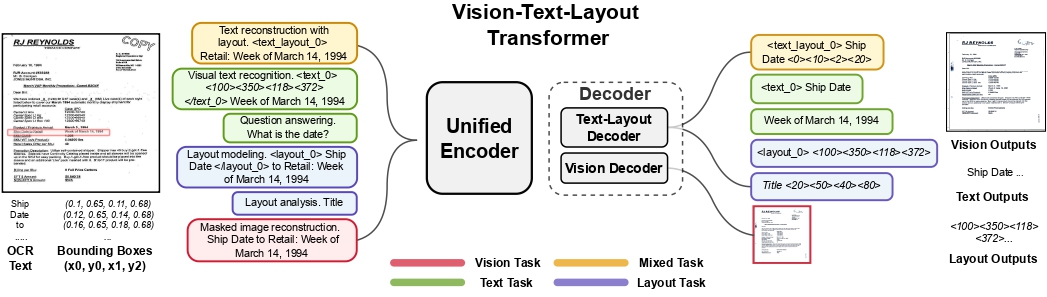 Arsitektur UDOP. Diambil dari paper aslinya.
## Tips penggunaan
- Selain *input_ids*, [UdopForConditionalGeneration](/docs/transformers/main/id/model_doc/udop#transformers.UdopForConditionalGeneration) juga mengharapkan input `bbox`, yaitu kotak pembatas (yaitu posisi 2D) dari token input. Kotak pembatas ini dapat diperoleh menggunakan mesin OCR eksternal seperti [Tesseract](https://github.com/tesseract-ocr/tesseract) dari Google (tersedia [wrapper Python](https://pypi.org/project/pytesseract/)). Setiap kotak pembatas harus dalam format (x0, y0, x1, y1), di mana (x0, y0) sesuai dengan posisi sudut kiri atas pada kotak pembatas, dan (x1, y1) merepresentasikan posisi sudut kanan bawah. Perhatikan bahwa kotak pembatas terlebih dahulu perlu dinormalisasi ke skala 0-1000. Untuk menormalisasi, Anda dapat menggunakan fungsi berikut:
```python
def normalize_bbox(bbox, width, height):
return [
int(1000 * (bbox[0] / width)),
int(1000 * (bbox[1] / height)),
int(1000 * (bbox[2] / width)),
int(1000 * (bbox[3] / height)),
]
```
Di sini, `width` dan `height` sesuai dengan lebar dan tinggi dokumen asli tempat token tersebut muncul. Nilai-nilai tersebut dapat diperoleh, misalnya, menggunakan pustaka Python Image Library (PIL) sebagai berikut:
```python
from PIL import Image
# Document can be a png, jpg, etc. PDFs must be converted to images.
image = Image.open(name_of_your_document).convert("RGB")
width, height = image.size
```
Anda dapat menggunakan [UdopProcessor](/docs/transformers/main/id/model_doc/udop#transformers.UdopProcessor) untuk menyiapkan gambar dan teks bagi model, yang menangani semua hal tersebut. Secara default, kelas ini menggunakan mesin Tesseract untuk mengekstrak daftar kata dan kotak (koordinat) dari dokumen yang diberikan. Fungsinya setara dengan [LayoutLMv3Processor](/docs/transformers/main/id/model_doc/layoutlmv3#transformers.LayoutLMv3Processor), sehingga mendukung pengiriman `apply_ocr=False` jika Anda lebih memilih menggunakan mesin OCR sendiri, atau `apply_ocr=True` jika Anda ingin menggunakan mesin OCR default. Lihat [panduan penggunaan LayoutLMv2](layoutlmv2#usage-layoutlmv2processor) untuk semua kasus penggunaan yang mungkin (fungsionalitas `UdopProcessor` identik).
- Jika menggunakan mesin OCR pilihan sendiri, salah satu rekomendasi adalah [Read API](https://learn.microsoft.com/en-us/azure/ai-services/computer-vision/how-to/call-read-api) dari Azure, yang mendukung segmen baris. Penggunaan posisi segmen embedding biasanya menghasilkan kinerja yang lebih baik.
- Saat inferensi, disarankan untuk menggunakan metode `generate` untuk menghasilkan teks secara autoregresif berdasarkan gambar dokumen.
- Model telah dilatih sebelumnya (pre-trained) pada tujuan (objectives) self-supervised dan supervised. Anda dapat menggunakan berbagai prefiks tugas (prompts) yang digunakan selama pre-training untuk menguji kemampuan bawaan (out-of-the-box) model. Sebagai contoh, model dapat diberi prompt "Question answering. What is the date?", karena "Question answering." adalah prefiks tugas yang digunakan selama pre-training untuk DocVQA. Lihat [paper](https://huggingface.co/papers/2212.02623) (tabel 1) untuk semua prefiks tugas.
- Anda juga dapat melakukan fine-tuning pada [UdopEncoderModel](/docs/transformers/main/id/model_doc/udop#transformers.UdopEncoderModel), yaitu bagian encoder-only dari UDOP, yang dapat dipandang sebagai encoder Transformer serupa LayoutLMv3. Untuk tugas diskriminatif, Anda cukup menambahkan linear classifier di atasnya dan melakukan fine-tuning pada dataset berlabel.
Model ini disumbangkan oleh [nielsr](https://huggingface.co/nielsr). Kode aslinya dapat ditemukan [di sini](https://github.com/microsoft/UDOP).
## Sumber daya
Daftar sumber resmi Hugging Face dan komunitas (ditandai dengan 🌎) untuk membantu Anda memulai dengan UDOP. Jika Anda tertarik untuk mengirimkan sumber agar disertakan di sini, silakan buka Pull Request dan kami akan meninjaunya! Sumber tersebut sebaiknya mendemonstrasikan sesuatu yang baru, bukan menduplikasi sumber yang sudah ada.
- Notebook demo terkait UDOP dapat ditemukan [di sini](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/UDOP) yang menunjukkan cara
untuk melakukan fine-tuning UDOP pada dataset kustom serta inferensi. 🌎
- [Panduan tugas menjawab pertanyaan dokumen](../tasks/document_question_answering)
## UdopConfig[[transformers.UdopConfig]]
#### transformers.UdopConfig[[transformers.UdopConfig]]
```python
transformers.UdopConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, vocab_size: int = 33201, d_model: int = 1024, d_kv: int = 64, d_ff: int = 4096, num_layers: int = 24, num_decoder_layers: int | None = None, num_heads: int = 16, relative_attention_num_buckets: int = 32, relative_attention_max_distance: int = 128, relative_bias_args: list[dict] | None = None, dropout_rate: float | int = 0.1, layer_norm_epsilon: float = 1e-06, initializer_factor: float = 1.0, feed_forward_proj: str = 'relu', use_cache: bool = True, pad_token_id: int | None = 0, eos_token_id: int | list[int] | None = 1, max_2d_position_embeddings: int = 1024, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, is_decoder: bool = False, add_cross_attention: bool = False, tie_word_embeddings: bool = True)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/configuration_udop.py#L24)
**Parameter:**
is_encoder_decoder (`bool`, *opsional*, defaultnya `True`) : Apakah model digunakan sebagai encoder/decoder atau tidak.
vocab_size (`int`, *opsional*, defaultnya `33201`) : Ukuran kosakata model. Menentukan jumlah token berbeda yang dapat direpresentasikan oleh `input_ids`.
d_model (`int`, *opsional*, defaultnya `1024`) : Ukuran lapisan encoder dan lapisan pooler.
d_kv (`int`, *opsional*, defaultnya `64`) : Ukuran proyeksi kunci, kueri, dan nilai per kepala perhatian. `inner_dim` dari lapisan proyeksi akan didefinisikan sebagai `num_heads * d_kv`.
d_ff (`int`, *opsional*, defaultnya `4096`) : Dimensi dari representasi MLP.
num_layers (`int`, *opsional*, defaultnya `24`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_decoder_layers (`int`, *opsional*) : Jumlah lapisan tersembunyi dalam decoder Transformer. Akan menggunakan nilai yang sama dengan `num_layers` jika tidak diatur.
num_heads (`int`, *opsional*, defaultnya `16`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
relative_attention_num_buckets (`int`, *opsional*, defaultnya 32) : Jumlah bucket yang digunakan untuk setiap lapisan perhatian.
relative_attention_max_distance (`int`, *opsional*, default 128) : Jarak maksimum dari urutan yang lebih panjang untuk pemisahan bucket.
relative_bias_args (`list[dict]`, *opsional*, defaultnya `[{'type' : '1d'}, {'type': 'horizontal'}, {'type': 'vertical'}]`): Daftar kamus yang berisi argumen untuk lapisan bias relatif.
dropout_rate (`Union[float, int]`, *opsional*, defaultnya `0.1`) : Rasio untuk semua lapisan dropout.
layer_norm_epsilon (`float`, *opsional*, defaultnya `1e-06`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
initializer_factor (`float`, *opsional*, default `1.0`) : Faktor untuk menginisialisasi semua matriks bobot (sebaiknya tetap 1, digunakan secara internal untuk pengujian inisialisasi).
feed_forward_proj (`string`, *opsional*, defaultnya `"relu"`) : Jenis lapisan feed forward yang akan digunakan. Harus salah satu dari `"relu"` atau `"gated-gelu"`. Udopv1.1 menggunakan proyeksi feed forward `"gated-gelu"`. Udop asli menggunakan `"relu"`.
use_cache (`bool`, *opsional*, defaultnya `True`) : Apakah model harus mengembalikan perhatian kunci/nilai terakhir (tidak digunakan oleh semua model). Hanya relevan jika `config.is_decoder=True` atau ketika model adalah model generatif yang hanya decoder.
pad_token_id (`int`, *opsional*, defaultnya `0`) : ID token yang digunakan untuk padding dalam kosakata.
eos_token_id (`Union[int, list[int]]`, *opsional*, defaultnya `1`) : Token id yang digunakan untuk end-of-stream dalam kosakata.
max_2d_position_embeddings (`int`, *opsional*, default 1024) : Embedding posisi absolut maksimum untuk encoding posisi relatif.
image_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `224`) : Ukuran (resolusi) dari setiap gambar.
patch_size (`Union[int, list[int], tuple[int, int]]`, *opsional*, defaultnya `16`) : Ukuran (resolusi) dari setiap patch.
num_channels (`int`, *opsional*, default `3`) : Jumlah saluran input.
is_decoder (`bool`, *opsional*, defaultnya `False`) : Apakah model digunakan sebagai decoder atau tidak. Jika `False`, model digunakan sebagai encoder.
add_cross_attention (`bool`, *opsional*, defaultnya `False`) : Apakah lapisan cross-attention harus ditambahkan ke model.
tie_word_embeddings (`bool`, *opsional*, defaultnya `True`) : Apakah mengikat embedding bobot sesuai dengan pemetaan `tied_weights_keys` model.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari UdopModel. Kelas ini digunakan untuk membuat instans model Udop sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [microsoft/udop-large](https://huggingface.co/microsoft/udop-large)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/main/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
## UdopTokenizer[[transformers.UdopTokenizer]]
#### transformers.UdopTokenizer[[transformers.UdopTokenizer]]
```python
transformers.UdopTokenizer(vocab: str | list[tuple[str, float]] | None = None, eos_token = '', sep_token = '', unk_token = '', pad_token = '', sep_token_box = [1000, 1000, 1000, 1000], pad_token_box = [0, 0, 0, 0], pad_token_label = -100, only_label_first_subword = True, extra_special_tokens = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/tokenization_udop.py#L139)
**Parameter:**
eos_token (`str`, *opsional*, defaultnya `""`) : Token akhir urutan. Saat membangun urutan menggunakan token khusus, ini bukan token yang digunakan untuk akhir urutan. Token yang digunakan adalah `sep_token`.
sep_token (`str`, *opsional*, defaultnya `""`) : Token pemisah, yang digunakan saat membangun urutan dari beberapa urutan, misalnya dua urutan untuk klasifikasi urutan atau untuk teks dan pertanyaan untuk penjawaban pertanyaan. Token ini juga digunakan sebagai token terakhir dari urutan yang dibangun dengan token khusus.
unk_token (`str`, *opsional*, defaultnya `""`) : Token yang tidak diketahui. Token yang tidak ada dalam kosakata tidak dapat dikonversi menjadi ID dan akan diset sebagai token ini.
pad_token (`str`, *opsional*, defaultnya `""`) : Token yang digunakan untuk padding, misalnya saat membatching urutan dengan panjang yang berbeda.
sep_token_box (`list[int]`, *opsional*, defaultnya `[1000, 1000, 1000, 1000]`) : Kotak pembatas yang digunakan untuk token khusus [SEP].
pad_token_box (`list[int]`, *opsional*, defaultnya `[0, 0, 0, 0]`) : Kotak pembatas yang digunakan untuk token khusus [PAD].
pad_token_label (`int`, *opsional*, default -100) : Label yang digunakan untuk token padding. Defaultnya -100, yang merupakan `ignore_index` dari CrossEntropyLoss PyTorch.
only_label_first_subword (`bool`, *opsional*, defaultnya `True`) : Apakah hanya melabeli subword pertama, jika label kata disediakan.
extra_special_tokens (`list[str]`, *opsional*, defaultnya `["
NOTUSED", "NOTUSED"]`) : Token khusus tambahan yang digunakan oleh tokenizer.
Konstruksi tokenizer UDOP "cepat" (didukung oleh pustaka *tokenizers* dari HuggingFace). Diadaptasi dari [LayoutXLMTokenizer](/docs/transformers/main/id/model_doc/layoutxlm#transformers.LayoutXLMTokenizer) dan [T5Tokenizer](/docs/transformers/main/id/model_doc/t5#transformers.T5Tokenizer). Berbasis [BPE](https://huggingface.co/docs/tokenizers/python/latest/components.html?highlight=BPE#models).
Tokenizer ini mewarisi dari [TokenizersBackend](/docs/transformers/main/id/main_classes/tokenizer#transformers.TokenizersBackend) yang berisi sebagian besar metode utama. Pengguna harus merujuk ke superclass ini untuk informasi lebih lanjut mengenai metode-metode tersebut.
#### build_inputs_with_special_tokens[[transformers.UdopTokenizer.build_inputs_with_special_tokens]]
```python
build_inputs_with_special_tokens(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/tokenization_udop.py#L972)
**Parameter:**
token_ids_0 (`list[int]`) : Daftar ID tempat token khusus akan ditambahkan.
token_ids_1 (`list[int]`, *opsional*) : Daftar ID kedua opsional untuk pasangan sekuens.
**Mengembalikan:** `list[int]`
Daftar [ID input](../glossary#input-ids) dengan token khusus yang sesuai.
Bangun input model dari sebuah urutan atau sepasang urutan untuk tugas klasifikasi urutan dengan melakukan penggabungan dan penambahan token khusus. Urutan XLM-RoBERTa memiliki format berikut:
- satu urutan: ` X `
- pasangan sekuens: ` A B `
#### get_special_tokens_mask[[transformers.UdopTokenizer.get_special_tokens_mask]]
```python
get_special_tokens_mask(token_ids_0: list[int], token_ids_1: list[int] | None = None, already_has_special_tokens: bool = False)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/tokenization_utils_base.py#L1338)
**Parameter:**
token_ids_0 : Daftar ID untuk sekuens (yang mungkin sudah diformat).
token_ids_1 : Tidak digunakan ketika `already_has_special_tokens=True`. Harus None dalam kasus tersebut.
already_has_special_tokens : Apakah urutan sudah diformat dengan token khusus.
**Mengembalikan:** Daftar bilangan bulat dalam rentang [0, 1]
1 untuk token khusus, 0 untuk token urutan.
Ambil id urutan dari daftar token yang tidak memiliki token khusus yang ditambahkan.
Untuk tokenizer yang cepat, data collator memanggil ini dengan `already_has_special_tokens=True` untuk membangun mask di atas urutan yang sudah diformat. Dalam kasus tersebut, kami menghitung mask dengan memeriksa keanggotaan dalam `all_special_ids`.
#### create_token_type_ids_from_sequences[[transformers.UdopTokenizer.create_token_type_ids_from_sequences]]
```python
create_token_type_ids_from_sequences(token_ids_0: list, token_ids_1: list[int] | None = None)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/tokenization_udop.py#L997)
**Parameter:**
token_ids_0 (`list[int]`) : Daftar ID.
token_ids_1 (`list[int]`, *opsional*) : Daftar ID kedua opsional untuk pasangan sekuens.
**Mengembalikan:** `list[int]`
Daftar nol.
Buat mask dari dua urutan yang diteruskan untuk digunakan dalam tugas klasifikasi pasangan urutan. XLM-RoBERTa tidak menggunakan id tipe token, oleh karena itu daftar nol dikembalikan.
#### save_vocabulary[[transformers.UdopTokenizer.save_vocabulary]]
```python
save_vocabulary(save_directory: str, filename_prefix: str | None = None)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/tokenization_udop.py#L1021)
Simpan file kosakata tokenizer. Untuk TokenizersBackend, file tokenizer.json disimpan oleh kelas dasar. Metode ini mengembalikan tuple kosong karena kami hanya menggunakan tokenizer.json.
## UdopProcessor[[transformers.UdopProcessor]]
#### transformers.UdopProcessor[[transformers.UdopProcessor]]
```python
transformers.UdopProcessor(image_processor, tokenizer)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/processing_udop.py#L53)
**Parameter:**
image_processor (`LayoutLMv3ImageProcessor`) : Prosesor gambar adalah input yang wajib.
tokenizer (`UdopTokenizer`) : Tokenizer adalah input yang wajib.
Membangun UdopProcessor yang membungkus image processor dan tokenizer menjadi satu processor.
[UdopProcessor](/docs/transformers/main/id/model_doc/udop#transformers.UdopProcessor) menyediakan semua fungsionalitas dari [LayoutLMv3ImageProcessor](/docs/transformers/main/id/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) dan [UdopTokenizer](/docs/transformers/main/id/model_doc/udop#transformers.UdopTokenizer). Lihat [~LayoutLMv3ImageProcessor](/docs/transformers/main/id/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) dan [~UdopTokenizer](/docs/transformers/main/id/model_doc/udop#transformers.UdopTokenizer) untuk informasi lebih lanjut.
#### __call__[[transformers.UdopProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/processing_udop.py#L72)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opsional*) : Gambar untuk dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opsional*) : Urutan atau batch dari urutan yang akan dienkod. Setiap urutan dapat berupa string atau daftar string (string yang sudah dipretokenisasi). Jika Anda memasukkan input yang sudah dipretokenisasi, setel `is_split_into_words=True` untuk menghindari ambiguitas dengan input yang di-batch.
return_tensors (`str` atau [TensorType](/docs/transformers/main/id/internal/file_utils#transformers.TensorType), *opsional*) : Jika diatur, akan mengembalikan tensor dari framework tertentu. Nilai yang dapat diterima adalah: - `'pt'`: Mengembalikan objek `torch.Tensor` PyTorch. - `'np'`: Mengembalikan objek `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/id/main_classes/processors#transformers.ProcessingKwargs), *opsional*) : Opsi pemrosesan tambahan untuk setiap modalitas (teks, gambar, video, audio). Parameter spesifik model tercantum di atas; lihat kelas TypedDict untuk daftar lengkap argumen yang didukung.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## UdopModel[[transformers.UdopModel]]
#### transformers.UdopModel[[transformers.UdopModel]]
```python
transformers.UdopModel(config: UdopConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1251)
**Parameter:**
config ([UdopConfig](/docs/transformers/main/id/model_doc/udop#transformers.UdopConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Udop polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.UdopModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, bbox: dict[str, typing.Any] | None = None, pixel_values: typing.Optional[torch.Tensor] = None, visual_bbox: dict[str, typing.Any] | None = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1287)
**Parameter:**
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
bbox (`torch.LongTensor` dengan bentuk `({0}, 4)`, *opsional*) : Kotak pembatas (bounding box) untuk setiap token dalam urutan input. Dipilih dalam rentang `[0, config.max_2d_position_embeddings-1]`. Setiap kotak pembatas harus berupa versi ternormalisasi dalam format (x0, y0, x1, y1), di mana (x0, y0) sesuai dengan posisi sudut kiri atas pada kotak pembatas, dan (x1, y1) merepresentasikan posisi sudut kanan bawah. Perhatikan bahwa `sequence_length = token_sequence_length + patch_sequence_length + 1` di mana `1` adalah untuk token [CLS]. Lihat `pixel_values` untuk `patch_sequence_length`.
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [LayoutLMv3ImageProcessor](/docs/transformers/main/id/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor). Lihat [LayoutLMv3ImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([UdopProcessor](/docs/transformers/main/id/model_doc/udop#transformers.UdopProcessor) menggunakan [LayoutLMv3ImageProcessor](/docs/transformers/main/id/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) untuk memproses gambar).
visual_bbox (`torch.LongTensor` dengan bentuk `(batch_size, patch_sequence_length, 4)`, *opsional*) : Kotak pembatas (bounding box) untuk setiap patch dalam gambar. Jika tidak disediakan, kotak pembatas akan dibuat di dalam model.
decoder_input_ids (`torch.LongTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Indeks token dari urutan input decoder dalam kosakata. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu decoder input IDs?](../glossary#decoder-input-ids) T5 menggunakan `pad_token_id` sebagai token awal untuk generasi `decoder_input_ids`. Jika `past_key_values` digunakan, secara opsional hanya `decoder_input_ids` terakhir yang perlu diinput (lihat `past_key_values`). Untuk mengetahui lebih lanjut tentang cara menyiapkan `decoder_input_ids` untuk pra-pelatihan, lihat [T5 Training](./t5#training).
decoder_attention_mask (`torch.BoolTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Perilaku bawaan: menghasilkan tensor yang mengabaikan token pad di `decoder_input_ids`. Mask kausal juga akan digunakan secara bawaan.
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
encoder_outputs (`torch.Tensor`, *opsional*) : Tuple terdiri dari (`last_hidden_state`, *opsional*: `hidden_states`, *opsional*: `attentions`) `last_hidden_state` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) adalah urutan hidden-states pada keluaran lapisan terakhir encoder. Digunakan dalam cross-attention decoder.
past_key_values (`~cache_utils.Cache`, *opsional*) : Hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention dan di blok cross-attention) yang dapat digunakan untuk mempercepat decoding berurutan. Ini biasanya terdiri dari `past_key_values` yang dikembalikan oleh model pada tahap decoding sebelumnya, ketika `use_cache=True` atau `config.use_cache=True`. Hanya instance [Cache](/docs/transformers/main/id/internal/generation_utils#transformers.Cache) yang diizinkan sebagai input, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami. Jika tidak ada `past_key_values` yang diteruskan, [DynamicCache](/docs/transformers/main/id/internal/generation_utils#transformers.DynamicCache) akan diinisialisasi secara default. Model akan mengoutput format cache yang sama dengan yang diberikan sebagai input. Jika `past_key_values` digunakan, pengguna diharapkan untuk hanya menginput `input_ids` yang belum diproses (yang tidak memiliki state past key value mereka diberikan ke model ini) dengan bentuk `(batch_size, unprocessed_length)` alih-alih semua `input_ids` dengan bentuk `(batch_size, sequence_length)`.
decoder_inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, target_sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `decoder_input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Jika `past_key_values` digunakan, secara opsional hanya `decoder_inputs_embeds` terakhir yang perlu diinput (lihat `past_key_values`). Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `decoder_input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model. Jika `decoder_input_ids` dan `decoder_inputs_embeds` keduanya tidak disetel, `decoder_inputs_embeds` mengambil nilai dari `inputs_embeds`.
use_cache (`bool`, *opsional*) : Jika diatur ke `True`, state kunci-nilai `past_key_values` akan dikembalikan dan dapat digunakan untuk mempercepat decoding (lihat `past_key_values`).
**Mengembalikan:** [Seq2SeqModelOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.Seq2SeqModelOutput) atau `tuple(torch.Tensor)`
A [Seq2SeqModelOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.Seq2SeqModelOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([UdopConfig](/docs/transformers/main/id/model_doc/udop#transformers.UdopConfig)) dan input.
Metode forward dari [UdopModel](/docs/transformers/main/id/model_doc/udop#transformers.UdopModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-state pada keluaran lapisan terakhir dari decoder model.
Jika `past_key_values` digunakan, hanya hidden-state terakhir dari sekuens dengan bentuk `(batch_size, 1, hidden_size)` yang dioutput.
- **past_key_values** (`EncoderDecoderCache`, *opsional*, dikembalikan ketika `use_cache=True` diteruskan atau ketika `config.use_cache=True`) -- Ini adalah instance [EncoderDecoderCache](/docs/transformers/main/id/internal/generation_utils#transformers.EncoderDecoderCache). Untuk detail lebih lanjut, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami.
Berisi hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention dan di blok cross-attention) yang dapat digunakan (lihat input `past_key_values`) untuk mempercepat decoding berurutan.
- **decoder_hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states dari decoder pada output setiap layer ditambah output embedding awal yang opsional.
- **decoder_attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` diteruskan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian dari decoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
- **cross_attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian dari lapisan cross-attention decoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala cross-attention.
- **encoder_last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) -- Urutan hidden-states pada keluaran lapisan terakhir dari encoder model.
- **encoder_hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_hidden_states=True` diteruskan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states dari encoder pada output setiap layer ditambah output embedding awal yang opsional.
- **encoder_attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian dari encoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from datasets import load_dataset
>>> import torch
>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = AutoModel.from_pretrained("microsoft/udop-large")
>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> inputs = processor(image, words, boxes=boxes, return_tensors="pt")
>>> decoder_input_ids = torch.tensor([[model.config.decoder_start_token_id]])
>>> # forward pass
>>> outputs = model(**inputs, decoder_input_ids=decoder_input_ids)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 1, 1024]
```
## UdopForConditionalGeneration[[transformers.UdopForConditionalGeneration]]
#### transformers.UdopForConditionalGeneration[[transformers.UdopForConditionalGeneration]]
```python
transformers.UdopForConditionalGeneration(config: UdopConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1405)
**Parameter:**
config ([UdopConfig](/docs/transformers/main/id/model_doc/udop#transformers.UdopConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Transformer encoder-decoder UDOP dengan kepala pemodelan bahasa di atasnya, yang memungkinkan untuk menghasilkan teks berdasarkan gambar dokumen dan prompt opsional.
Kelas ini didasarkan pada [T5ForConditionalGeneration](/docs/transformers/main/id/model_doc/t5#transformers.T5ForConditionalGeneration), yang diperluas untuk menangani data gambar dan tata letak (2D).
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.UdopForConditionalGeneration.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, bbox: dict[str, typing.Any] | None = None, pixel_values: typing.Optional[torch.Tensor] = None, visual_bbox: dict[str, typing.Any] | None = None, decoder_input_ids: typing.Optional[torch.Tensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, past_key_values: transformers.cache_utils.Cache | None = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, use_cache: bool | None = None, labels: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1447)
**Parameter:**
input_ids (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
bbox (`torch.LongTensor` dengan bentuk `({0}, 4)`, *opsional*) : Kotak pembatas (bounding box) untuk setiap token dalam urutan input. Dipilih dalam rentang `[0, config.max_2d_position_embeddings-1]`. Setiap kotak pembatas harus berupa versi ternormalisasi dalam format (x0, y0, x1, y1), di mana (x0, y0) sesuai dengan posisi sudut kiri atas pada kotak pembatas, dan (x1, y1) merepresentasikan posisi sudut kanan bawah. Perhatikan bahwa `sequence_length = token_sequence_length + patch_sequence_length + 1` di mana `1` adalah untuk token [CLS]. Lihat `pixel_values` untuk `patch_sequence_length`.
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [LayoutLMv3ImageProcessor](/docs/transformers/main/id/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor). Lihat [LayoutLMv3ImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([UdopProcessor](/docs/transformers/main/id/model_doc/udop#transformers.UdopProcessor) menggunakan [LayoutLMv3ImageProcessor](/docs/transformers/main/id/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) untuk memproses gambar).
visual_bbox (`torch.LongTensor` dengan bentuk `(batch_size, patch_sequence_length, 4)`, *opsional*) : Kotak pembatas (bounding box) untuk setiap patch dalam gambar. Jika tidak disediakan, kotak pembatas akan dibuat di dalam model.
decoder_input_ids (`torch.LongTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Indeks token dari urutan input decoder dalam kosakata. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu decoder input IDs?](../glossary#decoder-input-ids) T5 menggunakan `pad_token_id` sebagai token awal untuk generasi `decoder_input_ids`. Jika `past_key_values` digunakan, secara opsional hanya `decoder_input_ids` terakhir yang perlu diinput (lihat `past_key_values`). Untuk mengetahui lebih lanjut tentang cara menyiapkan `decoder_input_ids` untuk pra-pelatihan, lihat [T5 Training](./t5#training).
decoder_attention_mask (`torch.BoolTensor` dengan bentuk `(batch_size, target_sequence_length)`, *opsional*) : Perilaku bawaan: menghasilkan tensor yang mengabaikan token pad di `decoder_input_ids`. Mask kausal juga akan digunakan secara bawaan.
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
encoder_outputs (`torch.Tensor`, *opsional*) : Tuple terdiri dari (`last_hidden_state`, *opsional*: `hidden_states`, *opsional*: `attentions`) `last_hidden_state` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) adalah urutan hidden-states pada keluaran lapisan terakhir encoder. Digunakan dalam cross-attention decoder.
past_key_values (`~cache_utils.Cache`, *opsional*) : Hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention dan di blok cross-attention) yang dapat digunakan untuk mempercepat decoding berurutan. Ini biasanya terdiri dari `past_key_values` yang dikembalikan oleh model pada tahap decoding sebelumnya, ketika `use_cache=True` atau `config.use_cache=True`. Hanya instance [Cache](/docs/transformers/main/id/internal/generation_utils#transformers.Cache) yang diizinkan sebagai input, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami. Jika tidak ada `past_key_values` yang diteruskan, [DynamicCache](/docs/transformers/main/id/internal/generation_utils#transformers.DynamicCache) akan diinisialisasi secara default. Model akan mengoutput format cache yang sama dengan yang diberikan sebagai input. Jika `past_key_values` digunakan, pengguna diharapkan untuk hanya menginput `input_ids` yang belum diproses (yang tidak memiliki state past key value mereka diberikan ke model ini) dengan bentuk `(batch_size, unprocessed_length)` alih-alih semua `input_ids` dengan bentuk `(batch_size, sequence_length)`.
decoder_inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, target_sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `decoder_input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Jika `past_key_values` digunakan, secara opsional hanya `decoder_inputs_embeds` terakhir yang perlu diinput (lihat `past_key_values`). Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `decoder_input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model. Jika `decoder_input_ids` dan `decoder_inputs_embeds` keduanya tidak disetel, `decoder_inputs_embeds` mengambil nilai dari `inputs_embeds`.
use_cache (`bool`, *opsional*) : Jika diatur ke `True`, state kunci-nilai `past_key_values` akan dikembalikan dan dapat digunakan untuk mempercepat decoding (lihat `past_key_values`).
labels (`torch.LongTensor` dengan bentuk `(batch_size,)`, *opsional*) : Label untuk menghitung kerugian pemodelan bahasa. Indeks harus berada dalam `[-100, 0, ..., config.vocab_size - 1]`. Semua label yang disetel ke `-100` diabaikan (diperlakukan sebagai masker), dan kerugian hanya dihitung untuk label dalam `[0, ..., config.vocab_size]`.
**Mengembalikan:** [Seq2SeqLMOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.Seq2SeqLMOutput) atau `tuple(torch.Tensor)`
A [Seq2SeqLMOutput](/docs/transformers/main/id/main_classes/output#transformers.modeling_outputs.Seq2SeqLMOutput) atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([UdopConfig](/docs/transformers/main/id/model_doc/udop#transformers.UdopConfig)) dan input.
Metode forward dari [UdopForConditionalGeneration](/docs/transformers/main/id/model_doc/udop#transformers.UdopForConditionalGeneration) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `labels` disediakan) -- Loss pemodelan bahasa.
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, config.vocab_size)`) -- Skor prediksi dari kepala pemodelan bahasa (skor untuk setiap token kosakata sebelum SoftMax).
- **past_key_values** (`EncoderDecoderCache`, *opsional*, dikembalikan ketika `use_cache=True` diteruskan atau ketika `config.use_cache=True`) -- Ini adalah instance [EncoderDecoderCache](/docs/transformers/main/id/internal/generation_utils#transformers.EncoderDecoderCache). Untuk detail lebih lanjut, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami.
Berisi hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention dan di blok cross-attention) yang dapat digunakan (lihat input `past_key_values`) untuk mempercepat decoding berurutan.
- **decoder_hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states dari decoder pada output setiap layer ditambah output embedding awal.
- **decoder_attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` diteruskan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian dari decoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
- **cross_attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian dari lapisan cross-attention decoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala cross-attention.
- **encoder_last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) -- Urutan hidden-states pada keluaran lapisan terakhir dari encoder model.
- **encoder_hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_hidden_states=True` diteruskan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states dari encoder pada output setiap layer ditambah output embedding awal.
- **encoder_attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian dari encoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> from transformers import AutoProcessor, UdopForConditionalGeneration
>>> from datasets import load_dataset
>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopForConditionalGeneration.from_pretrained("microsoft/udop-large")
>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> # one can use the various task prefixes (prompts) used during pre-training
>>> # e.g. the task prefix for DocVQA is "Question answering. "
>>> question = "Question answering. What is the date on the form?"
>>> encoding = processor(image, question, text_pair=words, boxes=boxes, return_tensors="pt")
>>> # autoregressive generation
>>> predicted_ids = model.generate(**encoding)
>>> print(processor.batch_decode(predicted_ids, skip_special_tokens=True)[0])
9/30/92
```
## UdopEncoderModel[[transformers.UdopEncoderModel]]
#### transformers.UdopEncoderModel[[transformers.UdopEncoderModel]]
```python
transformers.UdopEncoderModel(config: UdopConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1579)
**Parameter:**
config ([UdopConfig](/docs/transformers/main/id/model_doc/udop#transformers.UdopConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Udop polos yang menghasilkan hidden-states mentah tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/main/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.UdopEncoderModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, bbox: dict[str, typing.Any] | None = None, attention_mask: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, visual_bbox: dict[str, typing.Any] | None = None, inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/main/src/transformers/models/udop/modeling_udop.py#L1610)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`) : Indeks token dari urutan input dalam kosakata. T5 adalah model dengan posisi relatif tertanam sehingga Anda harus dapat mengisi input di sisi kanan dan kiri. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/main/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/main/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detail. Untuk mengetahui lebih lanjut tentang cara menyiapkan `input_ids` untuk pra-pelatihan, lihat [T5 Training](./t5#training).
bbox (`torch.LongTensor` dengan bentuk `({0}, 4)`, *opsional*) : Kotak pembatas (bounding box) untuk setiap token dalam urutan input. Dipilih dalam rentang `[0, config.max_2d_position_embeddings-1]`. Setiap kotak pembatas harus berupa versi ternormalisasi dalam format (x0, y0, x1, y1), di mana (x0, y0) sesuai dengan posisi sudut kiri atas pada kotak pembatas, dan (x1, y1) merepresentasikan posisi sudut kanan bawah. Perhatikan bahwa `sequence_length = token_sequence_length + patch_sequence_length + 1` di mana `1` adalah untuk token [CLS]. Lihat `pixel_values` untuk `patch_sequence_length`.
attention_mask (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [LayoutLMv3ImageProcessor](/docs/transformers/main/id/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor). Lihat [LayoutLMv3ImageProcessor.__call__()](/docs/transformers/main/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([UdopProcessor](/docs/transformers/main/id/model_doc/udop#transformers.UdopProcessor) menggunakan [LayoutLMv3ImageProcessor](/docs/transformers/main/id/model_doc/layoutlmv3#transformers.LayoutLMv3ImageProcessor) untuk memproses gambar).
visual_bbox (`torch.LongTensor` dengan bentuk `(batch_size, patch_sequence_length, 4)`, *opsional*) : Kotak pembatas (bounding box) untuk setiap patch dalam gambar. Jika tidak disediakan, kotak pembatas akan dibuat di dalam model.
inputs_embeds (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`, *opsional*) : Secara opsional, alih-alih meneruskan `input_ids`, Anda dapat memilih untuk langsung meneruskan representasi tertanam. Ini berguna jika Anda ingin lebih banyak kendali atas cara mengonversi indeks `input_ids` menjadi vektor terkait daripada matriks pencarian penanaman internal model.
**Mengembalikan:** `BaseModelOutputWithAttentionMask` atau `tuple(torch.Tensor)`
Sebuah `BaseModelOutputWithAttentionMask` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([UdopConfig](/docs/transformers/main/id/model_doc/udop#transformers.UdopConfig)) dan input.
Metode forward dari [UdopEncoderModel](/docs/transformers/main/id/model_doc/udop#transformers.UdopEncoderModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-state pada keluaran lapisan terakhir model. Jika `past_key_values` digunakan, hanya hidden-state terakhir dari urutan dengan bentuk `(batch_size, 1, hidden_size)` yang dihasilkan.
- **attention_mask** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) -- Attention mask yang digunakan dalam forward pass model untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dari `[0, 1]`:
- 1 untuk token yang **tidak dimasker**,
- 0 untuk token yang **dimasker**.
- **past_key_values** (`Cache`, *opsional*, dikembalikan saat `use_cache=True` dilewatkan atau saat `config.use_cache=True`) -- Ini adalah instance [Cache](/docs/transformers/main/id/internal/generation_utils#transformers.Cache). Untuk detail lebih lanjut, lihat [panduan kv cache](https://huggingface.co/docs/transformers/en/kv_cache) kami.
Berisi hidden-states yang telah dihitung sebelumnya (key dan values di blok self-attention, dan secara opsional jika `config.is_encoder_decoder=True` di blok cross-attention) yang dapat digunakan (lihat input `past_key_values`) untuk mempercepat decoding berurutan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_hidden_states=True` dilewatkan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`. Hidden-states dari model pada output setiap lapisan ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`. Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
- **cross_attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dan `config.add_cross_attention=True` diteruskan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`. Bobot perhatian dari layer cross-attention decoder, setelah softmax perhatian, yang digunakan untuk menghitung rata-rata berbobot di head cross-attention.
Contoh:
```python
>>> from transformers import AutoProcessor, UdopEncoderModel
>>> from huggingface_hub import hf_hub_download
>>> from datasets import load_dataset
>>> # load model and processor
>>> # in this case, we already have performed OCR ourselves
>>> # so we initialize the processor with `apply_ocr=False`
>>> processor = AutoProcessor.from_pretrained("microsoft/udop-large", apply_ocr=False)
>>> model = UdopEncoderModel.from_pretrained("microsoft/udop-large")
>>> # load an example image, along with the words and coordinates
>>> # which were extracted using an OCR engine
>>> dataset = load_dataset("nielsr/funsd-layoutlmv3", split="train")
>>> example = dataset[0]
>>> image = example["image"]
>>> words = example["tokens"]
>>> boxes = example["bboxes"]
>>> encoding = processor(image, words, boxes=boxes, return_tensors="pt")
>>> outputs = model(**encoding)
>>> last_hidden_states = outputs.last_hidden_state
```