# OWL-ViT
## Обзор
OWL-ViT (аббревиатура от Vision Transformer for Open-World Localization) была предложена в статье [Simple Open-Vocabulary Object Detection with Vision Transformers](https://huggingface.co/papers/2205.06230) авторами Matthias Minderer, Alexey Gritsenko, Austin Stone, Maxim Neumann, Dirk Weissenborn, Alexey Dosovitskiy, Aravindh Mahendran, Anurag Arnab, Mostafa Dehghani, Zhuoran Shen, Xiao Wang, Xiaohua Zhai, Thomas Kipf и Neil Houlsby. OWL-ViT — это сеть обнаружения объектов с открытым словарем, обученная на разнообразных парах (изображение, текст). С ее помощью можно запросить изображение с одним или несколькими текстовыми запросами, чтобы найти и обнаружить целевые объекты, описанные в тексте.
Аннотация из статьи следующая:
*Сочетание простых архитектур с масштабным предварительным обучением привело к значительному улучшению результатов классификации изображений. Для обнаружения объектов подходы к предварительному обучению и масштабированию разработаны в меньшей степени, особенно в условиях длинного хвоста и открытого словаря, где обучающих данных относительно мало. В данной статье мы предлагаем эффективный метод переноса моделей «изображение-текст» на задачу обнаружения объектов с открытым словарем. Мы используем стандартную архитектуру Vision Transformer с минимальными модификациями, контрастное предварительное обучение «изображение-текст» и дообучение для обнаружения объектов end-to-end. Наш анализ свойств масштабирования данной конфигурации показывает, что увеличение масштаба предварительного обучения на уровне изображений и размера модели приводит к последовательному улучшению результатов на задаче обнаружения объектов. Мы описываем стратегии адаптации и методы регуляризации, необходимые для достижения очень высоких показателей в задачах обнаружения объектов с нулевым примером (zero-shot) по текстовому условию и с одним примером (one-shot) по изображению. Код и модели доступны на GitHub.*
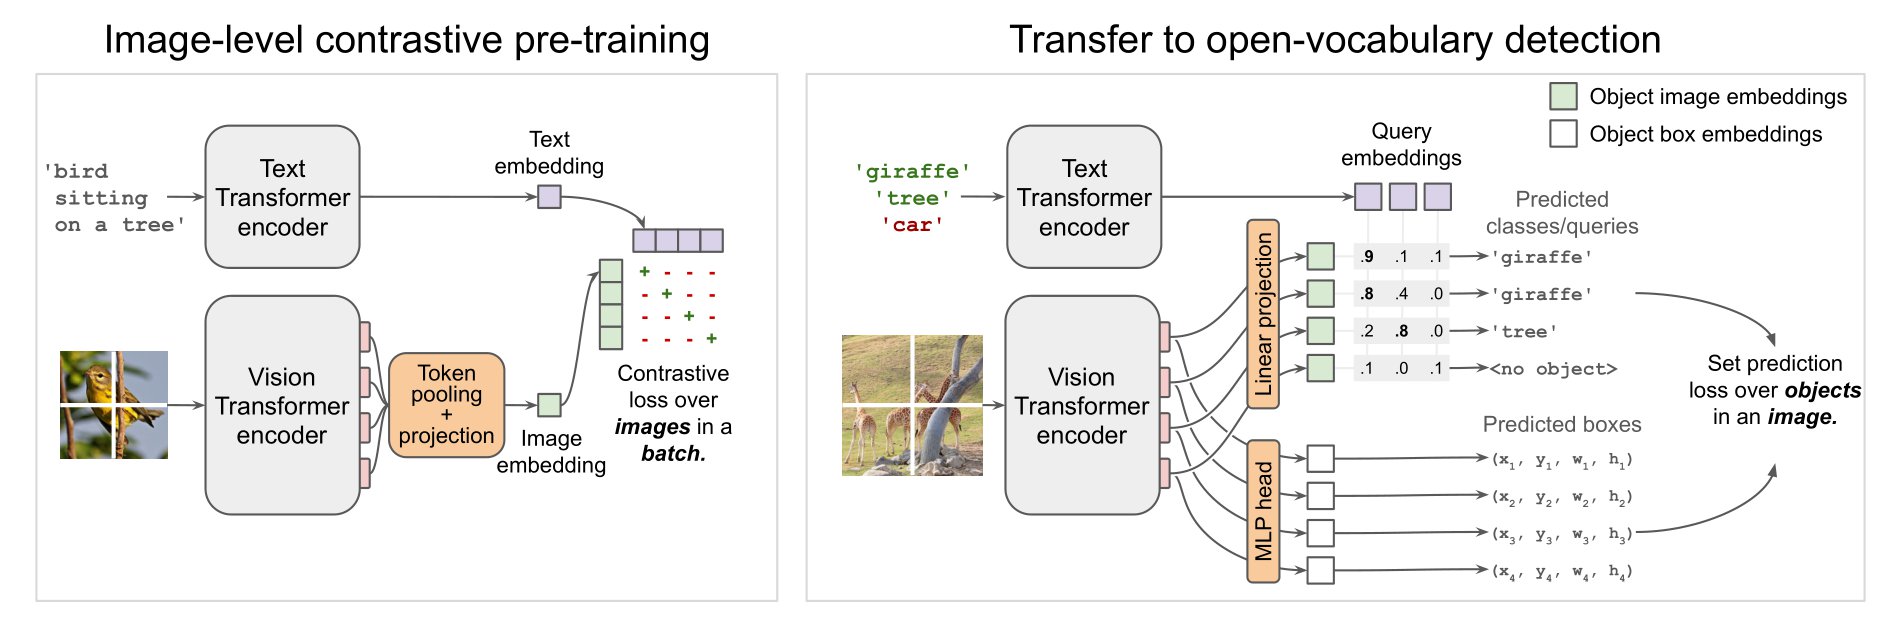 Архитектура OWL-ViT. Взято из оригинальной статьи.
Эта модель была предоставлена [adirik](https://huggingface.co/adirik). Исходный код можно найти [здесь](https://github.com/google-research/scenic/tree/main/scenic/projects/owl_vit).
## Советы по использованию
OWL-ViT — это модель обнаружения объектов с нулевой настройкой, управляемая текстом. OWL-ViT использует [CLIP](clip) в качестве мультимодального базового блока, где визуальные признаки извлекаются с помощью трансформера, похожего на ViT, а текстовые признаки — с помощью каузальной языковой модели. Для применения CLIP в задаче обнаружения OWL-ViT удаляет слой пулинга последнего токена в визуальной модели и подключает лёгкую голову классификации и регрессии границ к каждому выходному токену трансформера. Возможность классификации с открытым словарём обеспечивается заменой весов фиксированного слоя классификации на эмбеддинги названий классов, полученные из текстовой модели. Авторы сначала обучают CLIP с нуля, а затем дообучают его end-to-end вместе с головами классификации и регрессии границ на стандартных наборах данных для обнаружения, используя потерю на основе бипартитного сопоставления. Для выполнения обнаружения объектов с нулевой настройкой по текстовому запросу можно использовать один или несколько текстовых запросов на изображение.
[OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor) используется для изменения размера (или масштабирования) и нормализации изображений для модели, а [CLIPTokenizer](/docs/transformers/v5.23.0/ru/model_doc/clip#transformers.CLIPTokenizer) — для кодирования текста. [OwlViTProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTProcessor) объединяет [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor) и [CLIPTokenizer](/docs/transformers/v5.23.0/ru/model_doc/clip#transformers.CLIPTokenizer) в единый экземпляр, чтобы одновременно кодировать текст и готовить изображения. В следующем примере показано, как выполнять обнаружение объектов с помощью [OwlViTProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTProcessor) и [OwlViTForObjectDetection](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTForObjectDetection).
```python
import requests
from PIL import Image
import torch
from transformers import OwlViTProcessor, OwlViTForObjectDetection
processor = OwlViTProcessor.from_pretrained("google/owlvit-base-patch32")
model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch32", device_map="auto")
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
text_labels = [["a photo of a cat", "a photo of a dog"]]
inputs = processor(text=text_labels, images=image, return_tensors="pt").to(model.device)
outputs = model(**inputs)
# Target image sizes (height, width) to rescale box predictions [batch_size, 2]
target_sizes = torch.tensor([(image.height, image.width)])
# Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
results = processor.post_process_grounded_object_detection(
outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
)
# Retrieve predictions for the first image for the corresponding text queries
result = results[0]
boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
for box, score, text_label in zip(boxes, scores, text_labels):
box = [round(i, 2) for i in box.tolist()]
print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.707 at location [324.97, 20.44, 640.58, 373.29]
Detected a photo of a cat with confidence 0.717 at location [1.46, 55.26, 315.55, 472.17]
```
## Ресурсы
Демо-ноутбук по использованию OWL-ViT для обнаружения объектов в режимах zero- и one-shot (с использованием изображений в качестве ориентира) можно найти [здесь](https://github.com/huggingface/notebooks/blob/main/examples/zeroshot_object_detection_with_owlvit.ipynb).
## OwlViTConfig[[transformers.OwlViTConfig]]
#### transformers.OwlViTConfig[[transformers.OwlViTConfig]]
```python
transformers.OwlViTConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, return_dict: bool = True, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, projection_dim: int = 512, logit_scale_init_value: float = 2.6592, initializer_factor: float = 1.0)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/configuration_owlvit.py#L101)
**Параметры:**
return_dict (`bool`, *необязательный*, по умолчанию `True`) : Возвращать ли `ModelOutput` (dataclass) вместо обычного кортежа.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь текстового бэкбона.
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *необязательный*) : Объект конфигурации или словарь для визуального бэкбона.
projection_dim (`int`, *optional*, по умолчанию `512`) : Размерность проекционных слоёв для текста и изображений.
logit_scale_init_value (`float`, *необязательный*, по умолчанию `2.6592`) : Начальное значение параметра *logit_scale*.
initializer_factor (`float`, *необязательный*, по умолчанию `1.0`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
Это класс конфигурации для хранения настроек модели OwlViTModel. Он используется для создания модели Owlvit в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
## OwlViTTextConfig[[transformers.OwlViTTextConfig]]
#### transformers.OwlViTTextConfig[[transformers.OwlViTTextConfig]]
```python
transformers.OwlViTTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 16, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0, pad_token_id: int | None = 0, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/configuration_owlvit.py#L27)
**Параметры:**
vocab_size (`int`, *необязательный*, по умолчанию `49408`) : Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены в `input_ids`.
hidden_size (`int`, *необязательный*, по умолчанию `512`) : Размерность скрытых представлений.
intermediate_size (`int`, *необязательный*, по умолчанию `2048`) : Размерность представлений MLP.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `8`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
max_position_embeddings (`int`, *необязательный*, по умолчанию `16`) : Максимальная длина последовательности, с которой может использоваться данная модель.
hidden_act (`str`, *необязательный*, по умолчанию `quick_gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-05`) : Значение epsilon, используемое слоями нормализации.
attention_dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
initializer_factor (`float`, *необязательный*, по умолчанию `1.0`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
pad_token_id (`int`, *необязательный*, по умолчанию `0`) : Идентификатор токена, используемый для выравнивания в словаре.
bos_token_id (`int`, *необязательный*, по умолчанию `49406`) : Идентификатор токена, используемый для обозначения начала потока в словаре.
eos_token_id (`Union[int, list[int]]`, *необязательный*, по умолчанию `49407`) : Идентификатор токена, используемый для обозначения конца потока в словаре.
Это класс конфигурации для хранения настроек модели OwlViTModel. Он используется для создания модели Owlvit в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import OwlViTTextConfig, OwlViTTextModel
>>> # Initializing a OwlViTTextModel with google/owlvit-base-patch32 style configuration
>>> configuration = OwlViTTextConfig()
>>> # Initializing a OwlViTTextConfig from the google/owlvit-base-patch32 style configuration
>>> model = OwlViTTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## OwlViTVisionConfig[[transformers.OwlViTVisionConfig]]
#### transformers.OwlViTVisionConfig[[transformers.OwlViTVisionConfig]]
```python
transformers.OwlViTVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 768, patch_size: int | list[int] | tuple[int, int] = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: float | int = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/configuration_owlvit.py#L65)
**Параметры:**
hidden_size (`int`, *optional*, по умолчанию `768`) : Размерность скрытых представлений.
intermediate_size (`int`, *optional*, по умолчанию `3072`) : Размерность представлений MLP.
num_hidden_layers (`int`, *необязательный*, по умолчанию `12`) : Количество скрытых слоев в декодере Transformer.
num_attention_heads (`int`, *необязательный*, по умолчанию `12`) : Количество головок внимания для каждого слоя внимания в декодере Transformer.
num_channels (`int`, *необязательный*, по умолчанию `3`) : Количество входных каналов.
image_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `768`) : Размер (разрешение) каждого изображения.
patch_size (`Union[int, list[int], tuple[int, int]]`, *необязательный*, по умолчанию `32`) : Размер (разрешение) каждого патча.
hidden_act (`str`, *необязательный*, по умолчанию `quick_gelu`) : Нелинейная функция активации (функция или строка) в декодере. Например, `"gelu"`, `"relu"`, `"silu"` и т. д.
layer_norm_eps (`float`, *необязательный*, по умолчанию `1e-05`) : Значение epsilon, используемое слоями нормализации.
attention_dropout (`Union[float, int]`, *необязательный*, по умолчанию `0.0`) : Коэффициент dropout для вероятностей внимания.
initializer_range (`float`, *необязательный*, по умолчанию `0.02`) : Стандартное отклонение truncated_normal_initializer для инициализации всех матриц весов.
initializer_factor (`float`, *необязательный*, по умолчанию `1.0`) : Коэффициент для инициализации всех матриц весов (должен оставаться равным 1, используется внутренне для тестирования инициализации).
Это класс конфигурации для хранения настроек модели OwlViTModel. Он используется для создания модели Owlvit в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации модели [google/owlvit-base-patch16](https://huggingface.co/google/owlvit-base-patch16)
Объекты конфигурации наследуются от [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig) и могут использоваться для управления выводами модели. Подробнее см. в документации [PreTrainedConfig](/docs/transformers/v5.23.0/ru/main_classes/configuration#transformers.PreTrainedConfig).
Пример:
```python
>>> from transformers import OwlViTVisionConfig, OwlViTVisionModel
>>> # Initializing a OwlViTVisionModel with google/owlvit-base-patch32 style configuration
>>> configuration = OwlViTVisionConfig()
>>> # Initializing a OwlViTVisionModel model from the google/owlvit-base-patch32 style configuration
>>> model = OwlViTVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## OwlViTImageProcessor[[transformers.OwlViTImageProcessor]]
#### transformers.OwlViTImageProcessor[[transformers.OwlViTImageProcessor]]
```python
transformers.OwlViTImageProcessor(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/image_processing_owlvit.py#L102)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*, по умолчанию `True`) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 768, 'width': 768}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 768, 'width': 768}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.48145466, 0.4578275, 0.40821073]`) : Среднее значение изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.26862954, 0.26130258, 0.27577711]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Создаёт процессор изображений OwlViTImageProcessor.
#### preprocess[[transformers.OwlViTImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
## OwlViTImageProcessorPil[[transformers.OwlViTImageProcessorPil]]
#### transformers.OwlViTImageProcessorPil[[transformers.OwlViTImageProcessorPil]]
```python
transformers.OwlViTImageProcessorPil(**kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L108)
**Параметры:**
do_convert_rgb (`bool`, *kwargs*, *необязательный*, по умолчанию `True`) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли изменять размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 768, 'width': 768}`): Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Использовать ли квадратное изображение по умолчанию при изменении размера, если size является int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, по умолчанию `{'height' : 768, 'width': 768}`): Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, по умолчанию `3`) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Влияет только в том случае, если `do_resize` установлено в `True`.
do_rescale (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*, по умолчанию `0.00392156862745098`) : Коэффициент масштабирования для изменения масштаба изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *optional*, по умолчанию `True`) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.48145466, 0.4578275, 0.40821073]`) : Среднее значение изображения для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, по умолчанию `[0.26862954, 0.26130258, 0.27577711]`) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, по умолчанию `False`) : Нужно ли выполнять центрированный кроп изображения.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
Создаёт процессор изображений OwlViTImageProcessor.
#### preprocess[[transformers.OwlViTImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], *args, image_like_kwargs: dict[str, typing.Any] | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/image_processing_utils.py#L382)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Изображение для предобработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
image_like_kwargs (`dict[str, Any]`, *необязательный*) : Флаг разработчика для дополнительных изображений и похожих на них входных данных, которые также будут предобработаны. Используйте этот параметр только в том случае, если передача входных данных через kwarg не работает. Например, `preprocess(images, masks=masks)` — предпочтительный вариант, но для некоторых моделей он приводит к проблемам с приоритетом аргументов. В таких случаях можно использовать `preprocess(images, image_like_inputs={"masks": masks})`.
do_convert_rgb (`bool`, *kwargs*, *необязательный*) : Преобразовать ли изображение в RGB.
do_resize (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли изменить размер изображения.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Описывает максимальные размеры входных данных для модели.
default_to_square (`bool`, *kwargs*, *необязательный*) : Указывает, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задан как int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер выходного изображения после применения `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисления `PILImageResampling`. Действует только при установке `do_resize` в `True`.
do_rescale (`bool`, *kwargs*, *необязательный*) : Нужно ли масштабировать изображение.
rescale_factor (`float`, *kwargs*, *optional*) : Коэффициент масштабирования для изменения размера изображения, если `do_rescale` установлен в `True`.
do_normalize (`bool`, *kwargs*, *необязательный*) : Нужно ли нормализовать изображение.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Среднее значение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, если `do_normalize` установлено в `True`.
do_pad (`bool`, *kwargs*, *необязательный*) : Указывает, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Конкретная стратегия выравнивания зависит от модели.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Размер в формате `{"height": int, "width" int}`, до которого следует дополнить изображения. Должен быть больше любого размера изображения, переданного для предобработки. Если `pad_size` не указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только при `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Центрировать ли изображение при обрезке.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *необязательный*) : Поддерживается только `ChannelDimension.FIRST`. Добавлено для совместимости с медленными процессорами.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Формат размерности каналов для входного изображения. Если не задано, формат размерности каналов определяется по входному изображению. Может быть одним из: - `"channels_first"` или `ChannelDimension.FIRST`: изображение в формате (num_channels, height, width). - `"channels_last"` или `ChannelDimension.LAST`: изображение в формате (height, width, num_channels). - `"none"` или `ChannelDimension.NONE`: изображение в формате (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Устройство для обработки видео. Если не задано, устройство определяется на основе входных видео.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Возвращает стопку тензоров, если установлено значение `'pt'`, иначе возвращает список тензоров.
disable_grouping (`bool`, *kwargs*, *optional*) : Указывает, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *необязательный*) : Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
**Возвращает:** `~image_processing_base.BatchFeature`
- **data** (`dict`) — Словарь списков/массивов/тензоров, возвращаемый методом __call__ ('pixel_values' и т. д.).
- **tensor_type** (`Union[None, str, TensorType]`, *необязательный*) -- Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
Предобработка изображения или пакета изображений.
#### post_process_object_detection[[transformers.OwlViTImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: OwlViTObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L132)
**Параметры:**
outputs (`OwlViTObjectDetectionOutput`) : Сырые выходные данные модели.
threshold (`float`, *optional*, по умолчанию 0.1) : Порог оценки для сохранения предсказаний обнаружения объектов.
target_sizes (`torch.Tensor` или `list[tuple[int, int]]`, *необязательный*) : тензор формы `(batch_size, 2)` или список кортежей (`tuple[int, int]`), содержащих целевой размер `(height, width)` каждого изображения в батче. Если не задано, предсказания не будут изменены в размере.
**Возвращает:** `list[Dict]`
Список словарей, каждый из которых содержит следующие ключи:
- Уровень уверенности для каждого предсказанного прямоугольника на изображении.
- "labels": Индексы классов, предсказанных моделью на изображении.
- "boxes": ограничивающие рамки изображений в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
Преобразует необработанный вывод [OwlViTForObjectDetection](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTForObjectDetection) в итоговые ограничивающие рамки в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
#### post_process_image_guided_detection[[transformers.OwlViTImageProcessorPil.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs, threshold = 0.0, nms_threshold = 0.3, target_sizes = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/image_processing_pil_owlvit.py#L188)
**Параметры:**
outputs (`OwlViTImageGuidedObjectDetectionOutput`) : Сырые выходные данные модели.
threshold (`float`, *optional*, по умолчанию 0.0) : Минимальный порог уверенности для отбраковки предсказанных рамок.
nms_threshold (`float`, *optional*, по умолчанию 0.3) : Порог IoU для подавления не-максимумов (non-maximum suppression) перекрывающихся рамок.
target_sizes (`torch.Tensor`, *необязательный*) : тензор формы (batch_size, 2), где каждая запись представляет собой (height, width) соответствующего изображения в батче. Если задано, предсказанные нормализованные ограничивающие рамки масштабируются до целевых размеров. Если оставлено как None, предсказания не будут денормализованы.
**Возвращает:** `list[Dict]`
Список словарей, где каждый словарь содержит оценки, метки и рамки для изображения в батче, как их предсказала модель. Все метки установлены в None, так как `OwlViTForObjectDetection.image_guided_detection` выполняет однократное обнаружение объектов.
Преобразует вывод [OwlViTForObjectDetection.image_guided_detection()](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTForObjectDetection.image_guided_detection) в формат, ожидаемый COCO api.
## OwlViTProcessor[[transformers.OwlViTProcessor]]
#### transformers.OwlViTProcessor[[transformers.OwlViTProcessor]]
```python
transformers.OwlViTProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/processing_owlvit.py#L59)
**Параметры:**
image_processor (`OwlViTImageProcessor`) : Процессор изображений является обязательным входным параметром.
tokenizer (`CLIPTokenizer`) : Токенизатор является обязательным входным параметром.
Создаёт OwlViTProcessor, который объединяет процессор изображений и токенизатор в единый процессор.
[OwlViTProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTProcessor) предоставляет все возможности [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor) и [CLIPTokenizer](/docs/transformers/v5.23.0/ru/model_doc/clip#transformers.CLIPTokenizer). Подробнее см. в документации [~OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor) и [~CLIPTokenizer](/docs/transformers/v5.23.0/ru/model_doc/clip#transformers.CLIPTokenizer).
#### __call__[[transformers.OwlViTProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] = None, query_images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/processing_owlvit.py#L71)
**Параметры:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *необязательный*) : Изображение для предварительной обработки. Ожидается одно изображение или пакет изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установите `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *необязательный*) : Последовательность или батч последовательностей для кодирования. Каждая последовательность может быть строкой или списком строк (предтокенизированная строка). Если вы передаёте предтокенизированный вход, установите `is_split_into_words=True`, чтобы избежать неоднозначности с батчированными входами.
query_images (`ImageInput`, *необязательный*) : Изображения-запросы для использования в обнаружении объектов с визуальным руководством. При указании эти изображения служат визуальными запросами для поиска похожих объектов в основных `images`. Изображения-запросы имеют приоритет над текстовыми подсказками, и модель выполняет сопоставление «изображение-изображение» вместо сопоставления «текст-изображение».
return_mm_token_type_ids (`bool`, *kwargs*) : Нужно ли возвращать идентификаторы типов мультимодальных токенов, указывающие на позиции мультимодальных плейсхолдер-токенов.
return_text_replacement_offsets (`bool`, *kwargs*) : Нужно ли возвращать смещения символов для каждого мультимодального плейсхолдера и его замены.
return_tensors (`str` или [TensorType](/docs/transformers/v5.23.0/ru/internal/file_utils#transformers.TensorType), *optional*) : Если задано, возвращает тензоры конкретного фреймворка. Допустимые значения: - `'pt'`: возвращает объекты `torch.Tensor` PyTorch. - `'np'`: возвращает объекты `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/ru/main_classes/processors#transformers.ProcessingKwargs), *optional*) : Дополнительные параметры обработки для каждой модальности (текст, изображения, видео, аудио). Специфичные для модели параметры перечислены выше; полный список поддерживаемых аргументов см. в классе TypedDict.
**Возвращает:** [BatchFeature](/docs/transformers/v5.23.0/ru/main_classes/feature_extractor#transformers.BatchFeature)
Объект [BatchFeature](/docs/transformers/v5.23.0/ru/main_classes/feature_extractor#transformers.BatchFeature) со следующими полями:
- **input_ids** -- Список идентификаторов токенов, передаваемых в модель. Возвращается, если `text` не равен `None`.
- **attention_mask** -- Список индексов, указывающих, на какие токены модель должна обращать внимание (когда `return_attention_mask=True` или если *"attention_mask"* входит в `self.model_input_names` и если `text` не равно `None`).
- **pixel_values** -- Значения пикселей, передаваемые в модель. Возвращается, если `images` не равно `None`.
- **query_pixel_values** -- Пиксельные значения изображений запроса, передаваемые в модель. Возвращается, если `query_images` не равно `None`.
#### post_process_grounded_object_detection[[transformers.OwlViTProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: OwlViTObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/processing_owlvit.py#L168)
**Параметры:**
outputs (`OwlViTObjectDetectionOutput`) : Сырые выходные данные модели.
threshold (`float`, *optional*, по умолчанию 0.1) : Порог оценки для сохранения предсказаний обнаружения объектов.
target_sizes (`torch.Tensor` или `list[tuple[int, int]]`, *необязательный*) : тензор формы `(batch_size, 2)` или список кортежей (`tuple[int, int]`), содержащих целевой размер `(height, width)` каждого изображения в батче. Если не задано, предсказания не будут изменены в размере.
text_labels (`list[list[str]]`, *необязательный*) : Список списков текстовых меток для каждого изображения в батче. Если не задано, "text_labels" в выводе будет установлено в `None`.
**Возвращает:** `list[Dict]`
Список словарей, каждый из которых содержит следующие ключи:
- Уровень уверенности для каждого предсказанного прямоугольника на изображении.
- "labels": Индексы классов, предсказанных моделью на изображении.
- "boxes": ограничивающие рамки изображений в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
- "text_labels": Текстовые метки для каждого предсказанного ограничивающего прямоугольника на изображении.
Преобразует необработанный вывод [OwlViTForObjectDetection](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTForObjectDetection) в итоговые ограничивающие рамки в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
#### post_process_image_guided_detection[[transformers.OwlViTProcessor.post_process_image_guided_detection]]
```python
post_process_image_guided_detection(outputs: OwlViTImageGuidedObjectDetectionOutput, threshold: float = 0.0, nms_threshold: float = 0.3, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/processing_owlvit.py#L216)
**Параметры:**
outputs (`OwlViTImageGuidedObjectDetectionOutput`) : Сырые выходные данные модели.
threshold (`float`, *optional*, по умолчанию 0.0) : Минимальный порог уверенности для отбраковки предсказанных рамок.
nms_threshold (`float`, *optional*, по умолчанию 0.3) : Порог IoU для подавления не-максимумов (non-maximum suppression) перекрывающихся рамок.
target_sizes (`torch.Tensor`, *необязательный*) : тензор формы (batch_size, 2), где каждая запись представляет собой (height, width) соответствующего изображения в батче. Если задано, предсказанные нормализованные ограничивающие рамки масштабируются до целевых размеров. Если оставлено как None, предсказания не будут денормализованы.
**Возвращает:** `list[Dict]`
Список словарей, каждый из которых содержит следующие ключи:
- Уровень уверенности для каждого предсказанного прямоугольника на изображении.
- "boxes": ограничивающие рамки изображений в формате (top_left_x, top_left_y, bottom_right_x, bottom_right_y).
- "labels": установлено в `None`.
Преобразует вывод [OwlViTForObjectDetection.image_guided_detection()](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTForObjectDetection.image_guided_detection) в формат, ожидаемый COCO api.
## OwlViTModel[[transformers.OwlViTModel]]
#### transformers.OwlViTModel[[transformers.OwlViTModel]]
```python
transformers.OwlViTModel(config: OwlViTConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L813)
**Параметры:**
config ([OwlViTConfig](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTConfig)) : Класс конфигурации модели со всеми параметрами модели. Инициализация с файлом конфигурации не загружает веса, связанные с моделью, только конфигурацию. Используйте метод [from_pretrained()](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel.from_pretrained) для загрузки весов модели.
Модель Owlvit без дополнительных слоёв, выводящая необработанные скрытые состояния.
Эта модель наследуется от [PreTrainedModel](/docs/transformers/v5.23.0/ru/main_classes/model#transformers.PreTrainedModel). Общие методы, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка головок и т. д.), описаны в документации родительского класса.
Эта модель также является подклассом [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
#### forward[[transformers.OwlViTModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = False, return_base_image_embeds: bool | None = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L907)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. По умолчанию заполнение (padding) игнорируется. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor). Подробности см. в [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([OwlViTProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTProcessor) использует [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor) для обработки изображений).
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
return_loss (`bool`, *необязательный*) : Нужно ли возвращать контрастную потерю.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
return_base_image_embeds (`bool`, *необязательный*) : Нужно ли возвращать эмбеддинги базового изображения.
**Возвращает:** `OwlViTOutput` или `tuple(torch.Tensor)`
Объект `OwlViTOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([OwlViTConfig](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTConfig)) и входных данных.
Метод forward модели [OwlViTModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если `return_loss` равно `True`) -- Контрастивная функция потерь для сходства изображения и текста.
- **logits_per_image** (`torch.Tensor` формы `(image_batch_size, text_batch_size)`) -- Оценки масштабированного скалярного произведения между `image_embeds` и `text_embeds`. Это представляет собой оценки сходства между изображением и текстом.
- **logits_per_text** (`torch.Tensor` формы `(text_batch_size, image_batch_size)`) -- Оценки масштабированного скалярного произведения между `text_embeds` и `image_embeds`. Это представляет собой оценки сходства между текстом и изображением.
- **text_embeds** (`torch.Tensor` формы `(batch_size * num_max_text_queries, output_dim`) -- Векторные представления текста, полученные применением слоя проекции к агрегированному выводу [OwlViTTextModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTTextModel).
- **image_embeds** (`torch.Tensor` формы `(batch_size, output_dim`) -- Векторные представления изображений, полученные применением слоя проекции к агрегированному выводу [OwlViTVisionModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход [OwlViTTextModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход модели [OwlViTVisionModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTVisionModel).
Примеры:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(text=[["a photo of a cat", "a photo of a dog"]], images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.OwlViTModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L836)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size * num_max_text_queries, sequence_length)`) : Индексы токенов входной последовательности в словаре. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([OwlViTConfig](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTConfig)) и входных данных.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.OwlViTModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L873)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor). Подробности см. в [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([OwlViTProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTProcessor) использует [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor) для обработки изображений).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([OwlViTConfig](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTConfig)) и входных данных.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> import torch
>>> from transformers.image_utils import load_image
>>> from transformers import AutoProcessor, OwlViTModel
>>> model = OwlViTModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## OwlViTTextModel[[transformers.OwlViTTextModel]]
#### transformers.OwlViTTextModel[[transformers.OwlViTTextModel]]
```python
transformers.OwlViTTextModel(config: OwlViTTextConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L668)
#### forward[[transformers.OwlViTTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L684)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size * num_max_text_queries, sequence_length)`) : Индексы токенов входной последовательности в словаре. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids)
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([OwlViTConfig](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTConfig)) и входных данных.
Метод forward модели [OwlViTTextModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTTextModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from transformers import AutoProcessor, OwlViTTextModel
>>> model = OwlViTTextModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> inputs = processor(
... text=[["a photo of a cat", "a photo of a dog"], ["photo of a astranaut"]], return_tensors="pt"
... )
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## OwlViTVisionModel[[transformers.OwlViTVisionModel]]
#### transformers.OwlViTVisionModel[[transformers.OwlViTVisionModel]]
```python
transformers.OwlViTVisionModel(config: OwlViTVisionConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L763)
#### forward[[transformers.OwlViTVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L777)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`, *необязательно*) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor). Подробности см. в [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([OwlViTProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTProcessor) использует [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor) для обработки изображений).
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или `tuple(torch.Tensor)`
Объект [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/ru/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) или кортеж `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([OwlViTConfig](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTConfig)) и входных данных.
Метод forward модели [OwlViTVisionModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTVisionModel) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **last_hidden_state** (`torch.Tensor` формы `(batch_size, sequence_length, hidden_size)`) -- Последовательность скрытых состояний на выходе последнего слоя модели.
- **pooler_output** (`torch.Tensor` формы `(batch_size, hidden_size)`) -- Скрытое состояние последнего слоя для первого токена последовательности (токен классификации) после дополнительной обработки слоями, используемыми для вспомогательной задачи предварительного обучения. Например, для моделей семейства BERT это возвращает токен классификации после обработки линейным слоем и функцией активации tanh. Веса линейного слоя обучаются по задаче предсказания следующего предложения (классификации) во время предварительного обучения.
- **hidden_states** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_hidden_states=True` или когда `config.output_hidden_states=True`) -- Кортеж `torch.Tensor` (один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы `(batch_size, sequence_length, hidden_size)`.
Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
- **attentions** (`tuple(torch.Tensor)`, *необязательный*, возвращается при передаче `output_attentions=True` или при `config.output_attentions=True`) -- Кортеж `torch.Tensor` (по одному на каждый слой) формы `(batch_size, num_heads, sequence_length, sequence_length)`.
Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Примеры:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoProcessor, OwlViTVisionModel
>>> model = OwlViTVisionModel.from_pretrained("google/owlvit-base-patch32")
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## OwlViTForObjectDetection[[transformers.OwlViTForObjectDetection]]
#### transformers.OwlViTForObjectDetection[[transformers.OwlViTForObjectDetection]]
```python
transformers.OwlViTForObjectDetection(config: OwlViTConfig)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L1054)
#### forward[[transformers.OwlViTForObjectDetection.forward]]
```python
forward(input_ids: Tensor, pixel_values: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L1379)
**Параметры:**
input_ids (`torch.LongTensor` формы `(batch_size * num_max_text_queries, sequence_length)`, *необязательно*) : Индексы токенов входной последовательности в словаре. Индексы можно получить с помощью [AutoTokenizer](/docs/transformers/v5.23.0/ru/model_doc/auto#transformers.AutoTokenizer). Подробности см. в [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) и [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/ru/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__). [Что такое входные идентификаторы?](../glossary#input-ids).
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor). Подробности см. в [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([OwlViTProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTProcessor) использует [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor) для обработки изображений).
attention_mask (`torch.Tensor` формы `(batch_size, sequence_length)`, *необязательный*) : Маска для предотвращения применения внимания к индексам токенов отсечки. Значения маски выбираются из `[0, 1]`: - 1 для токенов, которые **не замаскированы**, - 0 для токенов, которые **замаскированы**. [Что такое маски внимания?](../glossary#attention-mask)
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** `OwlViTObjectDetectionOutput` или `tuple(torch.Tensor)`
Объект `OwlViTObjectDetectionOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([OwlViTConfig](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTConfig)) и входных данных.
Метод forward класса [OwlViTForObjectDetection](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTForObjectDetection) переопределяет специальный метод `__call__`.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр `Module`, а не эту функцию, поскольку первый выполняет шаги предварительной и постобработки, тогда как второй молча их игнорирует.
- **loss** (`torch.Tensor` формы `(1,)`, *необязательный*, возвращается, если предоставлены `labels`)) -- Суммарная потеря, представляющая собой линейную комбинацию отрицательного логарифма правдоподобия (кросс-энтропии) для предсказания класса и потери для ограничивающих прямоугольников. Последняя определяется как линейная комбинация L1-потери и обобщенной масштабно-инвариантной потери IoU.
- **loss_dict** (`Dict`, *необязательный*) -- Словарь, содержащий отдельные значения потерь. Полезно для ведения журнала.
- **logits** (`torch.Tensor` формы `(batch_size, num_patches, num_queries)`) -- Логиты классификации (включая no-object) для всех запросов.
- **pred_boxes** (`torch.Tensor` формы `(batch_size, num_patches, 4)`) -- Нормализованные координаты границ для всех запросов, представленные в виде (center_x, center_y, width, height). Эти значения нормализованы в диапазоне [0, 1] относительно размера каждого отдельного изображения в батче (игнорируя возможное выравнивание). Для получения ненормализованных границ используйте `post_process_object_detection()`.
- **text_embeds** (`torch.Tensor` формы `(batch_size, num_max_text_queries, output_dim`) -- Векторные представления текста, полученные применением слоя проекции к агрегированному выводу [OwlViTTextModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTTextModel).
- **image_embeds** (`torch.Tensor` формы `(batch_size, patch_size, patch_size, output_dim`) -- Пул-вывод модели [OwlViTVisionModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTVisionModel). OWL-ViT представляет изображения как набор патчей и вычисляет эмбеддинги изображений для каждого патча.
- **class_embeds** (`torch.Tensor` формы `(batch_size, num_patches, hidden_size)`) -- Классовые эмбеддинги всех патчей изображения. OWL-ViT представляет изображения как набор патчей, где общее количество патчей равно (image_size / patch_size)**2.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход [OwlViTTextModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход модели [OwlViTVisionModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTVisionModel).
Примеры:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import OwlViTProcessor, OwlViTForObjectDetection
>>> processor = OwlViTProcessor.from_pretrained("google/owlvit-base-patch32")
>>> model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch32")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text_labels = [["a photo of a cat", "a photo of a dog"]]
>>> inputs = processor(text=text_labels, images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # Target image sizes (height, width) to rescale box predictions [batch_size, 2]
>>> target_sizes = torch.tensor([(image.height, image.width)])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_grounded_object_detection(
... outputs=outputs, target_sizes=target_sizes, threshold=0.1, text_labels=text_labels
... )
>>> # Retrieve predictions for the first image for the corresponding text queries
>>> result = results[0]
>>> boxes, scores, text_labels = result["boxes"], result["scores"], result["text_labels"]
>>> for box, score, text_label in zip(boxes, scores, text_labels):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a photo of a cat with confidence 0.707 at location [324.97, 20.44, 640.58, 373.29]
Detected a photo of a cat with confidence 0.717 at location [1.46, 55.26, 315.55, 472.17]
```
#### image_guided_detection[[transformers.OwlViTForObjectDetection.image_guided_detection]]
```python
image_guided_detection(pixel_values: Tensor, query_pixel_values: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Источник](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/owlvit/modeling_owlvit.py#L1294)
**Параметры:**
pixel_values (`torch.Tensor` формы `(batch_size, num_channels, image_size, image_size)`) : Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor). Подробности см. в [OwlViTImageProcessor.__call__()](/docs/transformers/v5.23.0/ru/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) ([OwlViTProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTProcessor) использует [OwlViTImageProcessor](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTImageProcessor) для обработки изображений).
query_pixel_values (`torch.Tensor` формы `(batch_size, num_channels, height, width)`) : Пиксельные значения изображения-запроса для обнаружения. Передавайте одно изображение-запрос на каждое целевое изображение.
interpolate_pos_encoding (`bool`, *необязательный*, по умолчанию `False`) : Интерполировать ли предобученные позиционные кодирования.
**Возвращает:** `OwlViTImageGuidedObjectDetectionOutput` или `tuple(torch.Tensor)`
Объект `OwlViTImageGuidedObjectDetectionOutput` или кортеж из `torch.Tensor` (если передано `return_dict=False` или если `config.return_dict=False`), содержащий различные элементы в зависимости от конфигурации ([OwlViTConfig](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTConfig)) и входных данных.
- **logits** (`torch.Tensor` формы `(batch_size, num_patches, num_queries)`) -- Логиты классификации (включая no-object) для всех запросов.
- **image_embeds** (`torch.Tensor` формы `(batch_size, patch_size, patch_size, output_dim`) -- Пул-вывод модели [OwlViTVisionModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTVisionModel). OWL-ViT представляет изображения как набор патчей и вычисляет эмбеддинги изображений для каждого патча.
- **query_image_embeds** (`torch.Tensor` формы `(batch_size, patch_size, patch_size, output_dim`) -- Пул-вывод модели [OwlViTVisionModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTVisionModel). OWL-ViT представляет изображения как набор патчей и вычисляет эмбеддинги для каждого патча.
- **target_pred_boxes** (`torch.Tensor` формы `(batch_size, num_patches, 4)`) -- Нормализованные координаты границ для всех запросов, представленные в виде (center_x, center_y, width, height). Эти значения нормализованы в диапазоне [0, 1] относительно размера каждого отдельного целевого изображения в батче (без учёта возможного отступного заполнения). Для получения ненормализованных границ используйте `post_process_object_detection()`.
- **query_pred_boxes** (`torch.Tensor` формы `(batch_size, num_patches, 4)`) — нормализованные координаты границ для всех запросов, представленные в виде (center_x, center_y, width, height). Эти значения нормализованы в диапазоне [0, 1] относительно размера каждого отдельного изображения запроса в батче (без учёта возможного выравнивания). Для получения ненормализованных границ используйте `post_process_object_detection()`.
- **class_embeds** (`torch.Tensor` формы `(batch_size, num_patches, hidden_size)`) -- Классовые эмбеддинги всех патчей изображения. OWL-ViT представляет изображения как набор патчей, где общее количество патчей равно (image_size / patch_size)**2.
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход [OwlViTTextModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *необязательный*) -- Выход модели [OwlViTVisionModel](/docs/transformers/v5.23.0/ru/model_doc/owlvit#transformers.OwlViTVisionModel).
Примеры:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> import torch
>>> from transformers import AutoProcessor, OwlViTForObjectDetection
>>> processor = AutoProcessor.from_pretrained("google/owlvit-base-patch16")
>>> model = OwlViTForObjectDetection.from_pretrained("google/owlvit-base-patch16")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> query_url = "http://images.cocodataset.org/val2017/000000001675.jpg"
>>> with httpx.stream("GET", query_url) as response:
... query_image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, query_images=query_image, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model.image_guided_detection(**inputs)
>>> # Target image sizes (height, width) to rescale box predictions [batch_size, 2]
>>> target_sizes = torch.Tensor([image.size[::-1]])
>>> # Convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> results = processor.post_process_image_guided_detection(
... outputs=outputs, threshold=0.6, nms_threshold=0.3, target_sizes=target_sizes
... )
>>> i = 0 # Retrieve predictions for the first image
>>> boxes, scores = results[i]["boxes"], results[i]["scores"]
>>> for box, score in zip(boxes, scores):
... box = [round(i, 2) for i in box.tolist()]
... print(f"Detected similar object with confidence {round(score.item(), 3)} at location {box}")
Detected similar object with confidence 0.856 at location [10.94, 50.4, 315.8, 471.39]
Detected similar object with confidence 1.0 at location [334.84, 25.33, 636.16, 374.71]
```