# Grounding DINO
## Genel Bakış
Grounding DINO modeli, Shilong Liu, Zhaoyang Zeng, Tianhe Ren, Feng Li, Hao Zhang, Jie Yang, Chunyuan Li, Jianwei Yang, Hang Su, Jun Zhu ve Lei Zhang tarafından [Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection](https://huggingface.co/papers/2303.05499) makalesinde önerilmiştir. Grounding DINO, bir metin kodlayıcı ekleyerek kapalı küme nesne algılama modelini genişletir ve açık küme nesne algılama imkânı sağlar. Model, COCO üzerinde 52.5 AP gibi etkileyici sonuçlar elde eder.
Makalenin özeti aşağıdaki gibidir:
*Bu makalede, Transformer tabanlı dedektör DINO'yu yerelleştirilmiş ön eğitimiyle birleştirerek, kategori adları veya atıf ifadeleri gibi insan girdileriyle keyfi nesneleri algılayabilen, Grounding DINO adında açık küme nesne dedektörü sunuyoruz. Açık küme nesne algılamanın temel çözümü, açık küme kavram genellemesi için kapalı küme bir dedektöre dilin eklenmesidir. Dil ve görme modalitelerini etkili bir şekilde birleştirmek için, kapalı küme dedektörü kavramsal olarak üç aşamaya ayırıyoruz ve bir özellik güçlendirici, dil yönlendirmeli sorgu seçimi ve çapraz modalite füzyonu için bir çapraz modalite çözücü içeren sıkı bir füzyon çözümü öneriyoruz. Önceki çalışmalar açık küme nesne algılamayı ağırlıklı olarak yeni kategorilerde değerlendirirken, niteliklerle belirlenen nesneler için atıf ifade anlama üzerinde de değerlendirme yapılmasını öneriyoruz. Grounding DINO, COCO, LVIS, ODinW ve RefCOCO/+/g üzerindeki kıyaslamaları da içeren üç ayarın tümünde olağanüstü iyi performans gösteriyor. Grounding DINO, COCO algılama sıfır atımlı aktarım kıyaslamasında, yani COCO'dan herhangi bir eğitim verisi kullanılmadan, 52,5 AP elde ediyor. ODinW sıfır atımlı kıyaslamasında ortalama 26,1 AP ile yeni bir rekor kırıyor.*
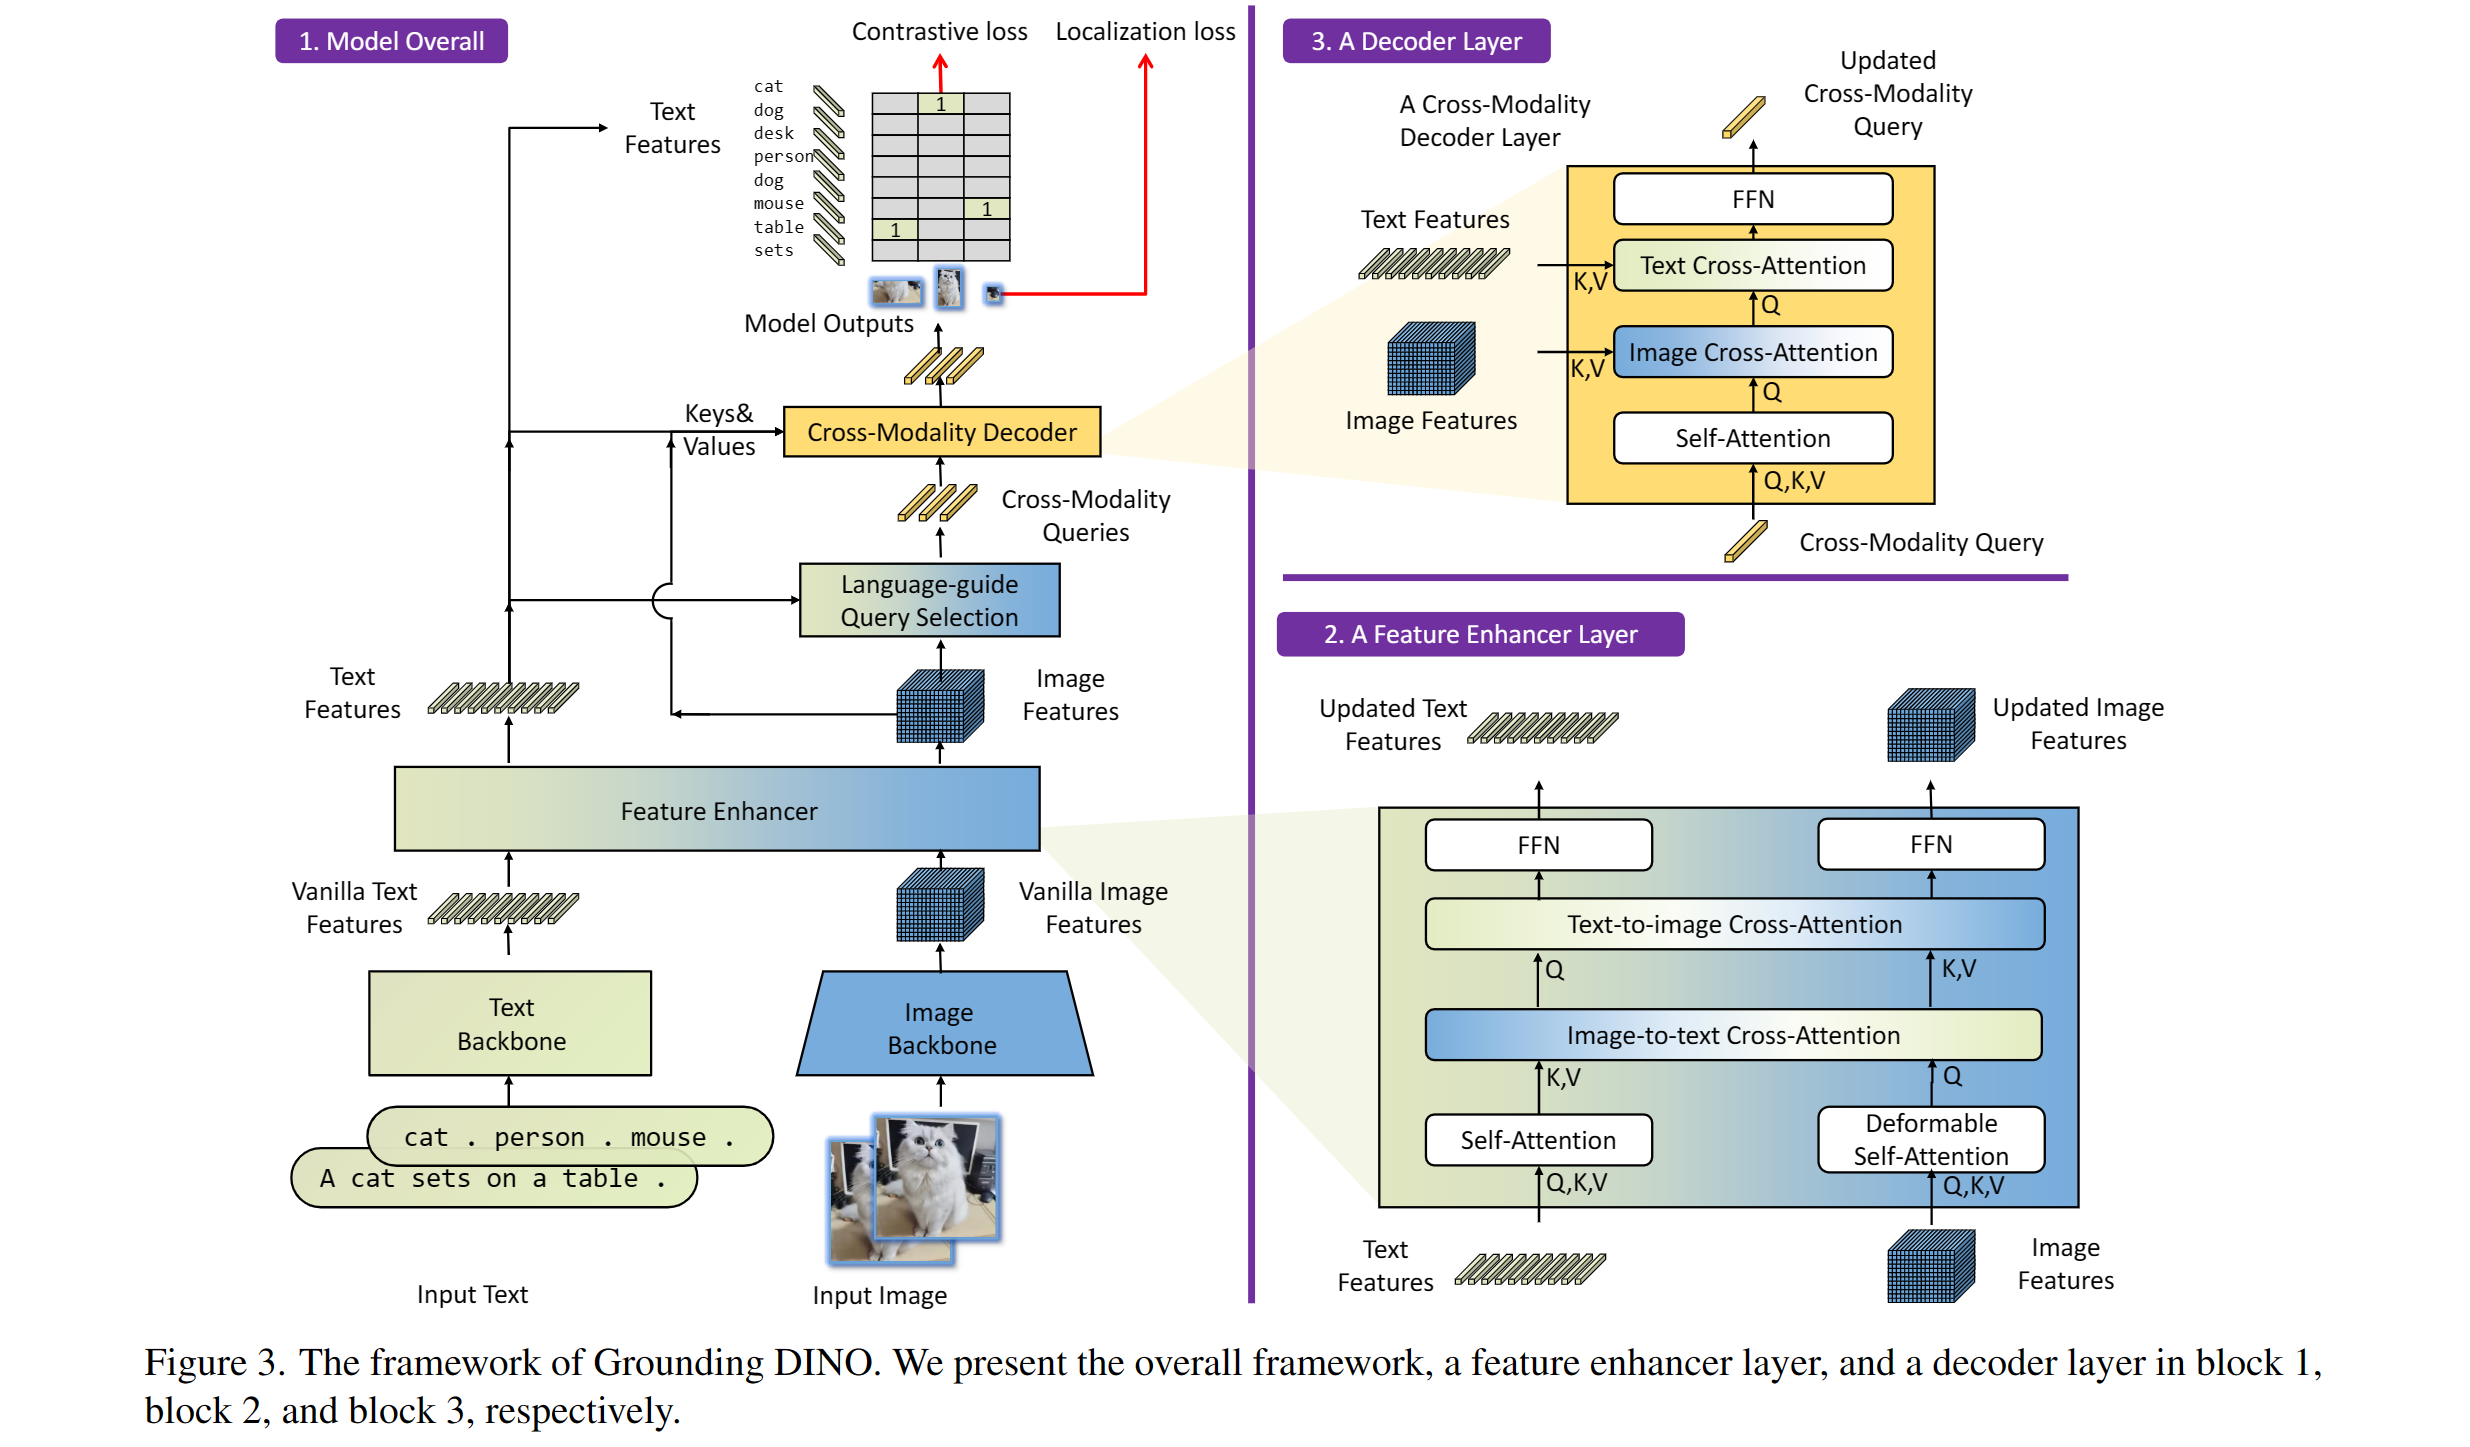 Grounding DINO genel bakış. Orijinal makaleden alınmıştır.
Bu model [EduardoPacheco](https://huggingface.co/EduardoPacheco) ve [nielsr](https://huggingface.co/nielsr) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/IDEA-Research/GroundingDINO) bulunabilir.
## Kullanım ipuçları
- Görsel-metin çiftlerini model için hazırlamak için [GroundingDinoProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoProcessor) kullanılabilir.
- Metindeki sınıfları ayırmak için nokta kullanın, örneğin "a cat. a dog."
- Birden fazla sınıf kullanıldığında (ör. `"a cat. a dog."`), çıktıları işleme almak için [GroundingDinoProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoProcessor)'dan `post_process_grounded_object_detection` kullanın. Çünkü `post_process_object_detection`'dan dönen etiketler, prob > threshold olan model boyutundaki indeksleri temsil eder.
Sıfır atışlı nesne algılama için modeli nasıl kullanacağınız aşağıda gösterilmektedir:
```python
import requests
import torch
from PIL import Image
from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
model_id = "IDEA-Research/grounding-dino-tiny"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id, device_map="auto")
image_url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(image_url, stream=True).raw)
# Check for cats and remote controls
text_labels = [["a cat", "a remote control"]]
inputs = processor(images=image, text=text_labels, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = processor.post_process_grounded_object_detection(
outputs,
inputs.input_ids,
threshold=0.4,
text_threshold=0.3,
target_sizes=[image.size[::-1]]
)
# Retrieve the first image result
result = results[0]
for box, score, labels in zip(result["boxes"], result["scores"], result["labels"]):
box = [round(x, 2) for x in box.tolist()]
print(f"Detected {labels} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.468 at location [344.78, 22.9, 637.3, 373.62]
Detected a cat with confidence 0.426 at location [11.74, 51.55, 316.51, 473.22]
```
## Grounded SAM
Grounding DINO, [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159) makalesinde tanıtıldığı gibi, metin tabanlı maske üretimi için [Segment Anything](sam) modeliyle birleştirilebilir. Detaylar için bu [demo defterine](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍 bakabilirsiniz.
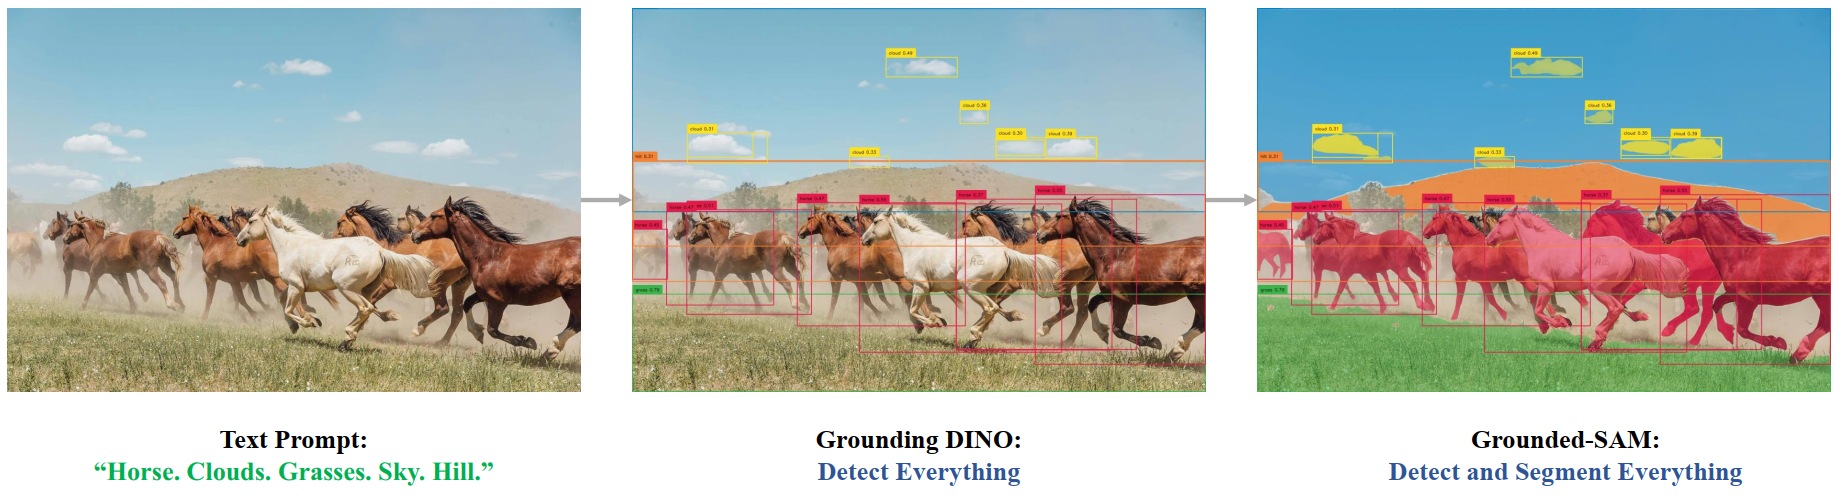 Grounded SAM genel bakış. Orijinal depodan alınmıştır.
## Kaynaklar
Grounding DINO ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilir) kaynaklarının listesi. Burada yer alacak bir kaynak göndermek isterseniz, bir Pull Request açmaktan çekinmeyin; inceleyeceğiz! Kaynağın, mevcut bir kaynağı tekrarlamak yerine ideal olarak yeni bir şey göstermesi beklenir.
- Grounding DINO ile çıkarım ve [SAM](sam) ile birleştirilmesine ilişkin demo defterleri [burada](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Grounding%20DINO) bulunabilir. 🌎
## GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
#### transformers.GroundingDinoImageProcessor[[transformers.GroundingDinoImageProcessor]]
```python
transformers.GroundingDinoImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L308)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 800, 'longest_edge': 1333}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
format (`str`, *kwargs*, *opsiyonel*, varsayılan `AnnotationFormat.COCO_DETECTION`) : Etiketlerin veri biçimi. "coco_detection" veya "coco_panoptic" değerlerinden biri.
do_convert_annotations (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Etiketlerin GROUNDING_DINO modelinin beklediği formata dönüştürülüp dönüştürülmemesini kontrol eder. Sınırlayıcı kutuları `(center_x, center_y, width, height)` formatına ve `[0, 1]` aralığına dönüştürür. `preprocess` metodundaki `do_convert_annotations` parametresi ile geçersiz kılınabilir.
GroundingDinoImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.GroundingDinoImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_grounding_dino.py#L563)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
annotations (`AnnotationType` veya `list[AnnotationType]`, *isteğe bağlı*) : Görsellere uygulanan dolgu (padding) durumuna göre dönüştürülecek etiketler.
return_segmentation_masks (`bool`, *isteğe bağlı*, varsayılan `self.return_segmentation_masks`) : Segmentasyon maskelerinin döndürülüp döndürülmeyeceğini belirtir.
masks_path (`str` veya `pathlib.Path`, *isteğe bağlı*) : Segmentasyon maskelerini içeren dizinin yolu.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
format (`str`, *kwargs*, *opsiyonel*, varsayılan `AnnotationFormat.COCO_DETECTION`) : Etiketlerin veri biçimi. "coco_detection" veya "coco_panoptic" değerlerinden biri.
do_convert_annotations (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Etiketlerin GROUNDING_DINO modelinin beklediği formata dönüştürülüp dönüştürülmemesini kontrol eder. Sınırlayıcı kutuları `(center_x, center_y, width, height)` formatına ve `[0, 1]` aralığına dönüştürür. `preprocess` metodundaki `do_convert_annotations` parametresi ile geçersiz kılınabilir.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
## GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
#### transformers.GroundingDinoImageProcessorPil[[transformers.GroundingDinoImageProcessorPil]]
```python
transformers.GroundingDinoImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L300)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'shortest_edge' : 800, 'longest_edge': 1333}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `2`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan değeri `[0.485, 0.456, 0.406]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.229, 0.224, 0.225]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
format (`str`, *kwargs*, *opsiyonel*, varsayılan `AnnotationFormat.COCO_DETECTION`) : Etiketlerin veri biçimi. "coco_detection" veya "coco_panoptic" değerlerinden biri.
do_convert_annotations (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Etiketlerin GROUNDING_DINO modelinin beklediği formata dönüştürülüp dönüştürülmemesini kontrol eder. Sınırlayıcı kutuları `(center_x, center_y, width, height)` formatına ve `[0, 1]` aralığına dönüştürür. `preprocess` metodundaki `do_convert_annotations` parametresi ile geçersiz kılınabilir.
GroundingDinoImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.GroundingDinoImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L568)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
annotations (`AnnotationType` veya `list[AnnotationType]`, *isteğe bağlı*) : Görsellere uygulanan dolgu (padding) durumuna göre dönüştürülecek etiketler.
return_segmentation_masks (`bool`, *isteğe bağlı*, varsayılan `self.return_segmentation_masks`) : Segmentasyon maskelerinin döndürülüp döndürülmeyeceğini belirtir.
masks_path (`str` veya `pathlib.Path`, *isteğe bağlı*) : Segmentasyon maskelerini içeren dizinin yolu.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
format (`str`, *kwargs*, *opsiyonel*, varsayılan `AnnotationFormat.COCO_DETECTION`) : Etiketlerin veri biçimi. "coco_detection" veya "coco_panoptic" değerlerinden biri.
do_convert_annotations (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Etiketlerin GROUNDING_DINO modelinin beklediği formata dönüştürülüp dönüştürülmemesini kontrol eder. Sınırlayıcı kutuları `(center_x, center_y, width, height)` formatına ve `[0, 1]` aralığına dönüştürür. `preprocess` metodundaki `do_convert_annotations` parametresi ile geçersiz kılınabilir.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
#### post_process_object_detection[[transformers.GroundingDinoImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs: GroundingDinoObjectDetectionOutput, threshold: float = 0.1, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/image_processing_pil_grounding_dino.py#L713)
**Parametreler:**
outputs (`GroundingDinoObjectDetectionOutput`) : Modelin ham çıktıları.
threshold (`float`, *opsiyonel*, varsayılan 0.1) : Nesne algılama tahminlerini tutmak için skor eşiği.
target_sizes (`torch.Tensor` veya `list[tuple[int, int]]`, *isteğe bağlı*) : Şekli `(batch_size, 2)` olan bir Tensor veya batch'teki her bir görüntünün hedef boyutunu `(height, width)` içeren tuple'ların (`tuple[int, int]`) listesi. Ayarlanmazsa, tahminler yeniden boyutlandırılmaz.
**Dönüş:** `list[Dict]`
Her biri aşağıdaki anahtarları içeren sözlüklerden oluşan bir liste:
- "scores": Görseldeki her tahmin edilen kutu için güven puanları.
- "labels": Modelin görüntüde tahmin ettiği sınıfların indeksleri.
- "boxes": (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde görüntü sınırlayıcı kutuları.
[GroundingDinoForObjectDetection](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection)'ün ham çıktısını (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde nihai sınırlayıcı kutulara dönüştürür.
## GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
#### transformers.GroundingDinoProcessor[[transformers.GroundingDinoProcessor]]
```python
transformers.GroundingDinoProcessor(image_processor, tokenizer)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/processing_grounding_dino.py#L100)
**Parametreler:**
image_processor (`GroundingDinoImageProcessor`) : Görüntü işleyici zorunlu bir girdidir.
tokenizer (`BertTokenizer`) : Tokenizer zorunlu bir girdidir.
Bir görüntü işleyiciyi ve bir belirteç oluşturucuyu tek bir işleyicide birleştiren bir GroundingDinoProcessor oluşturur.
[GroundingDinoProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoProcessor), [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) ve [BertTokenizer](/docs/transformers/v5.23.0/tr/model_doc/lxmert#transformers.BertTokenizer) sınıflarının tüm işlevlerini sunar. Daha fazla bilgi için [~GroundingDinoImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) ve [~BertTokenizer](/docs/transformers/v5.23.0/tr/model_doc/lxmert#transformers.BertTokenizer) belgelerine bakın.
#### __call__[[transformers.GroundingDinoProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
text (`Union[str, list[str], list[list[str]]]`, *isteğe bağlı*) : Kodlanacak dizi veya dizi topluluğu. Her dizi bir metin veya metin listesi (önceden tokenize edilmiş metin) olabilir. Önceden tokenize edilmiş bir girdi geçirirseniz, toplu girdilerle karışıklığı önlemek için `is_split_into_words=True` değerini ayarlayın.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *isteğe bağlı*) : Ön işleme tabi tutulacak video. Piksel değerleri 0 ile 255 arasında değişen tek bir video veya video grubu beklenir. Piksel değerleri 0 ile 1 arasında olan videoları geçiriyorsanız, `do_rescale=False` olarak ayarlayın.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *isteğe bağlı*) : Hazırlanacak ses veya sesler grubu. Her ses, bir NumPy dizisi veya PyTorch tensörü olabilir. NumPy dizisi/PyTorch tensörü durumunda, her sesin şekli (C, T) olmalıdır; burada C kanal sayısı, T ise sesin örnek uzunluğudur.
return_mm_token_type_ids (`bool`, *kwargs*) : Çok modlu yer tutucu token konumlarını gösteren çok modlu token türü kimliklerini döndürüp döndürmeyeceğini belirtir.
return_text_replacement_offsets (`bool`, *kwargs*) : Her çok modlu yer tutucu ve ikamesi için karakter ofsetlerinin döndürülüp döndürülmemesi.
return_tensors (`str` veya [TensorType](/docs/transformers/v5.23.0/tr/internal/file_utils#transformers.TensorType), *opsiyonel*) : Ayarlanırsa, belirli bir çerçeveye ait tensörleri döndürür. Kabul edilen değerler: - `'pt'`: PyTorch `torch.Tensor` nesnelerini döndürür. - `'np'`: NumPy `np.ndarray` nesnelerini döndürür.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/tr/main_classes/processors#transformers.ProcessingKwargs), *opsiyonel*) : Her modalite (metin, görüntüler, videolar, ses) için ek işleme seçenekleri. Modelle ilgili parametreler yukarıda listelenmiştir; desteklenen argümanların tam listesi için TypedDict sınıfına bakın.
#### post_process_grounded_object_detection[[transformers.GroundingDinoProcessor.post_process_grounded_object_detection]]
```python
post_process_grounded_object_detection(outputs: GroundingDinoObjectDetectionOutput, input_ids: transformers.utils.generic.TensorType | None = None, threshold: float = 0.25, text_threshold: float = 0.25, target_sizes: transformers.utils.generic.TensorType | list[tuple] | None = None, text_labels: list[list[str]] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/processing_grounding_dino.py#L130)
**Parametreler:**
outputs (`GroundingDinoObjectDetectionOutput`) : Modelin ham çıktıları.
input_ids (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Girdi metninin token kimlikleri. Sağlanmazsa model çıktısından alınır.
threshold (`float`, *opsiyonel*, varsayılan 0.25) : Güven skoru temelinde nesne algılama tahminlerini tutmak için eşik değeri.
text_threshold (`float`, *opsiyonel*, varsayılan 0.25) : Metin algılama tahminlerini tutmak için skor eşiği.
target_sizes (`torch.Tensor` veya `list[tuple[int, int]]`, *isteğe bağlı*) : Şekli `(batch_size, 2)` olan bir Tensor veya batch'teki her bir görüntünün hedef boyutunu `(height, width)` içeren tuple'ların (`tuple[int, int]`) listesi. Ayarlanmazsa, tahminler yeniden boyutlandırılmaz.
text_labels (`list[list[str]]`, *isteğe bağlı*) : Her görüntüde algılanacak aday etiketlerin listesi. Şu an *kullanılmıyor*, ancak sıfır atışlı nesne algılama hattının imzasında bulunması gerekiyor. Metin etiketleri bunun yerine `outputs` içinde sağlanan `input_ids` tensöründen çıkarılıyor.
**Dönüş:** `list[Dict]`
Her biri şunları içeren sözlüklerden oluşan bir liste
- **scores**: algılanan nesneler için güven puanlarını içeren tensör
- **boxes**: [x0, y0, x1, y1] biçiminde sınırlayıcı kutuların tensörü
- **labels**: algılanan her nesne için metin etiketleri listesi (v4.51.0 sürümünde tamsayı kimlikleriyle değiştirilecektir)
- **text_labels**: algılanan nesneler için metin etiketleri listesi
[GroundingDinoForObjectDetection](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection)'ün ham çıktısını (top_left_x, top_left_y, bottom_right_x, bottom_right_y) biçiminde nihai sınırlayıcı kutulara dönüştürür ve ilişkili metin etiketini alır.
## GroundingDinoConfig[[transformers.GroundingDinoConfig]]
#### transformers.GroundingDinoConfig[[transformers.GroundingDinoConfig]]
```python
transformers.GroundingDinoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, text_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_queries: int = 900, encoder_layers: int = 6, encoder_ffn_dim: int = 2048, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 2048, decoder_attention_heads: int = 8, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = True, class_cost: float = 1.0, bbox_cost: float = 5.0, giou_cost: float = 2.0, bbox_loss_coefficient: float = 5.0, giou_loss_coefficient: float = 2.0, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, max_text_len: int = 256, text_enhancer_dropout: float | int = 0.0, fusion_droppath: float | int = 0.1, fusion_dropout: float | int = 0.0, embedding_init_target: bool = True, query_dim: int = 4, decoder_bbox_embed_share: bool = True, two_stage_bbox_embed_share: bool = False, positional_embedding_temperature: int = 20, init_std: float = 0.02, layer_norm_eps: float = 1e-05, tie_word_embeddings: bool = True)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/configuration_grounding_dino.py#L28)
**Parametreler:**
is_encoder_decoder (`bool`, *isteğe bağlı*, varsayılan `True`) : Modelin bir kodlayıcı/çözücü olarak kullanılıp kullanılmadığı.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Omurga modelinin yapılandırması.
text_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *isteğe bağlı*) : Metin omurgasının yapılandırma nesnesi veya sözlüğü.
num_queries (`int`, *isteğe bağlı*, varsayılan 900) : Nesne sorgusu sayısı, yani algılama yuvaları. Bu, [GroundingDinoModel](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoModel)'in tek bir görüntüde algılayabileceği nesnelerin azami sayısıdır.
encoder_layers (`int`, *isteğe bağlı*, varsayılan `6`) : Transformer kodlayıcısındaki gizli katman sayısı. Ayarlanmazsa `num_layers` ile aynı değeri kullanır.
encoder_ffn_dim (`int`, *opsiyonel*, varsayılan `2048`) : Kodlayıcıdaki "ara" (genellikle feed-forward olarak adlandırılan) katmanının boyutluluğu.
encoder_attention_heads (`int`, *isteğe bağlı*, varsayılan `8`) : Transformer kodlayıcısındaki her dikkat katmanı için dikkat başı sayısı.
decoder_layers (`int`, *isteğe bağlı*, varsayılan `6`) : Transformer decoder'ındaki gizli katman sayısı. Ayarlanmazsa `num_layers` ile aynı değer kullanılır.
decoder_ffn_dim (`int`, *opsiyonel*, varsayılan `2048`) : Dekoderdeki "ara" (genellikle feed-forward olarak adlandırılan) katmanın boyutluluğu.
decoder_attention_heads (`int`, *isteğe bağlı*, varsayılan `8`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
activation_function (`str`, *isteğe bağlı*, varsayılan `relu`) : Dekoderdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
d_model (`int`, *isteğe bağlı*, varsayılan `256`) : Kodlayıcı katmanlarının ve havuzlayıcı katmanının boyutu.
dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Tüm dropout katmanları için oran.
attention_dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
activation_dropout (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Tamamen bağlı katmandaki aktivasyonlar için dropout oranı.
auxiliary_loss (`bool`, *isteğe bağlı*, varsayılan `False`) : Yardımcı çözümleme kayıplarının (her decoder katmanındaki kayıplar) kullanılıp kullanılmayacağı.
position_embedding_type (`str`, *isteğe bağlı*, varsayılan `"sine"`) : Görüntü özelliklerinin üzerine kullanılacak konum gömme türü. `"sine"` veya `"learned"` değerlerinden biri.
num_feature_levels (`int`, *isteğe bağlı*, varsayılan 4) : Girdi özellik seviyelerinin sayısı.
encoder_n_points (`int`, *isteğe bağlı*, varsayılan 4) : Kodlayıcıdaki her dikkat başı için her özellik seviyesinde örneklenen anahtar sayısı.
decoder_n_points (`int`, *isteğe bağlı*, varsayılan 4) : Dekoderdeki her dikkat başı için her özellik seviyesinde örneklenen anahtar sayısı.
two_stage (`bool`, *isteğe bağlı*, varsayılan `True`) : Bölge önerilerinin de Grounding DINO'nun bir varyantı tarafından üretilip, bunların daha sonra iteratif sınırlayıcı kutu iyileştirmesi için dekodöre beslendiği iki aşamalı deformable DETR uygulanıp uygulanmayacağını belirtir.
class_cost (`float`, *opsiyonel*, varsayılan `1.0`) : Macar eşleştirme maliyetinde sınıflandırma hatasının göreli ağırlığı.
bbox_cost (`float`, *opsiyonel*, varsayılan `5.0`) : Macar eşleştirme maliyetinde L1 sınırlayıcı kutu hatasının göreli ağırlığı.
giou_cost (`float`, *opsiyonel*, varsayılan `2.0`) : Macar eşleştirme maliyetinde genelleştirilmiş IoU kaybının göreli ağırlığı.
bbox_loss_coefficient (`float`, *opsiyonel*, varsayılan `5.0`) : Panoptik segmentasyon kaybında L1 sınırlayıcı kutu kaybının göreli ağırlığı.
giou_loss_coefficient (`float`, *opsiyonel*, varsayılan `2.0`) : Panoptik segmentasyon kaybında genelleştirilmiş IoU kaybının göreli ağırlığı.
focal_alpha (`float`, *isteğe bağlı*, varsayılan `0.25`) : Focal loss'taki Alpha parametresi.
disable_custom_kernels (`bool`, *isteğe bağlı*, varsayılan `False`) : Özel CUDA ve CPU çekirdeklerinin kullanımını devre dışı bırakır. Bu seçenek, özel çekirdeklerin PyTorch ONNX dışa aktarımı tarafından desteklenmediği için ONNX dışa aktarımı için gereklidir.
max_text_len (`int`, *isteğe bağlı*, varsayılan 256) : Metin girdisinin maksimum uzunluğu.
text_enhancer_dropout (`float`, *isteğe bağlı*, varsayılan 0.0) : Metin iyileştiricisi için dropout oranı.
fusion_droppath (`float`, *opsiyonel*, varsayılan 0.1) : Füzyon modülü için droppath oranı.
fusion_dropout (`float`, *opsiyonel*, varsayılan 0.0) : Füzyon modülü için dropout oranı.
embedding_init_target (`bool`, *isteğe bağlı*, varsayılan `True`) : Hedefin Embedding ağırlıklarıyla başlatılıp başlatılmayacağı.
query_dim (`int`, *isteğe bağlı*, varsayılan 4) : Sorgu vektörünün boyutu.
decoder_bbox_embed_share (`bool`, *isteğe bağlı*, varsayılan `True`) : bbox regresyon başlığının tüm decoder katmanları için paylaşılıp paylaşılmayacağını belirtir.
two_stage_bbox_embed_share (`bool`, *isteğe bağlı*, varsayılan `False`) : bbox gömmelemesinin, iki aşamalı bbox üreticisi ile bölge önerisi üretimi arasında paylaşılıp paylaşılmayacağını belirtir.
positional_embedding_temperature (`float`, *opsiyonel*, varsayılan 20) : Görüntü omurgasıyla birlikte kullanılan Sine Positional Embedding için sıcaklık.
init_std (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-05`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
tie_word_embeddings (`bool`, *isteğe bağlı*, varsayılan `True`) : Ağırlık gömme bağlamalarının, modelin `tied_weights_keys` eşlemesine göre yapılıp yapılmayacağını belirtir.
Bu, bir Grounding DinoModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Grounding Dino modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [IDEA-Research/grounding-dino-tiny](https://huggingface.co/IDEA-Research/grounding-dino-tiny) yapılandırmasına benzer bir yapılandırma üretir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/v5.23.0/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnekler:
```python
>>> from transformers import GroundingDinoConfig, GroundingDinoModel
>>> # Initializing a Grounding DINO IDEA-Research/grounding-dino-tiny style configuration
>>> configuration = GroundingDinoConfig()
>>> # Initializing a model (with random weights) from the IDEA-Research/grounding-dino-tiny style configuration
>>> model = GroundingDinoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## GroundingDinoModel[[transformers.GroundingDinoModel]]
#### transformers.GroundingDinoModel[[transformers.GroundingDinoModel]]
```python
transformers.GroundingDinoModel(config: GroundingDinoConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L1869)
**Parametreler:**
config ([GroundingDinoConfig](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine bakın.
Üzerinde herhangi bir özel başlık olmadan ham gizli durumlar (hidden-states) üreten, bir omurga (backbone) ve encoder-decoder Transformer'dan oluşan çıplak Grounding DINO Modeli.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.GroundingDinoModel.forward]]
```python
forward(pixel_values: Tensor, input_ids: Tensor, token_type_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, pixel_mask: typing.Optional[torch.Tensor] = None, encoder_outputs = None, output_attentions = None, output_hidden_states = None, return_dict = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2015)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [GroundingDinoImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakınız ([GroundingDinoProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoProcessor), görüntü işleme için [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) kullanır).
input_ids (`torch.LongTensor`, şekli `(batch_size, text_sequence_length)`) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak, sağlarsanız dolgu (padding) yok sayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [BertTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) bölümüne bakın.
token_type_ids (`torch.LongTensor`, şekli `(batch_size, text_sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: 0, `sentence A` token'ına, 1 ise `sentence B` token'ına karşılık gelir [Token türü kimlikleri nelerdir?](../glossary#token-type-ids)
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
pixel_mask (`torch.Tensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Dolgu piksel değerleri üzerinde dikkat işleminin uygulanmaması için maske. `[0, 1]` aralığında seçilen maske değerleri: - Gerçek (yani **maskelenmemiş**) pikseller için 1, - Dolgu (yani **maskelenmiş**) pikseller için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
encoder_outputs (``) : Tuple consists of (`last_hidden_state`, *optional*: `hidden_states`, *optional*: `attentions`) `last_hidden_state` of shape `(batch_size, sequence_length, hidden_size), *optional*) kodlayıcının son katmanının çıktısındaki gizli durumlar dizisidir. Çözücünün çapraz dikkatinde kullanılır.
output_attentions (``) : Whether or not to return the attentions tensors of all attention layers. See `attentions` under returned tensors for more detail.
output_hidden_states (``) : Whether or not to return the hidden states of all layers. See `hidden_states` under returned tensors for more detail.
return_dict (``) : Düz bir tuple yerine [ModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.utils.ModelOutput) döndürülüp döndürülmemesi.
**Dönüş:** `GroundingDinoModelOutput` veya `tuple(torch.Tensor)`
`GroundingDinoModelOutput` veya bir `torch.Tensor` demeti (`return_dict=False` geçirildiğinde veya `config.return_dict=False` olduğunda), yapılandırmaya ([GroundingDinoConfig](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[GroundingDinoModel](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, num_queries, hidden_size)`) -- Modelin decoder'ının son katmanının çıktısındaki gizli durumlar dizisi.
- **init_reference_points** (`torch.Tensor`, şekli `(batch_size, num_queries, 4)`) -- Transformer decoder üzerinden gönderilen başlangıç referans noktaları.
- **intermediate_hidden_states** (`torch.Tensor`, şekli `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Yığılmış ara gizli durumlar (decoder'ın her katmanının çıktısı).
- **intermediate_reference_points** (`torch.Tensor`, şekli `(batch_size, config.decoder_layers, num_queries, 4)`) -- Yığılmış ara referans noktaları (decoder'ın her katmanının referans noktaları).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`.
Her katmanın çıktısında ve başlangıç gömme çıktılarında dekodlayıcının gizli durumları.
- **decoder_attentions** (`tuple[tuple[torch.Tensor]]`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat yumuşatma (attention softmax) sonrasında, öz-dikkat (self-attention) kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılan çözücü (decoder) dikkat ağırlıkları.
- **encoder_last_hidden_state_vision** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) -- Modelin kodlayıcısının son katmanının çıktısındaki gizli durumlar dizisi.
- **encoder_last_hidden_state_text** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`, *isteğe bağlı*) -- Modelin kodlayıcısının son katmanının çıktısındaki gizli durumlar dizisi.
- **encoder_vision_hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (görsel gömme çıktısı için bir tane + her katman çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`. Görsel kodlayıcının her katman çıktısındaki gizli durumları ve başlangıç gömme çıktıları.
- **encoder_text_hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (metin gömme çıktısı için bir tane + her katman çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`. Metin kodlayıcısının her katman çıktısındaki gizli durumları ve başlangıç gömme çıktıları.
- **encoder_attentions** (`tuple(tuple(torch.Tensor))`, *opsiyonel*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için dikkat için bir tane) içeren tuple'ların tuple'ı, şekli `(batch_size, num_heads, sequence_length, sequence_length)`. Dikkat softmax'ı sonrası dikkat ağırlıkları, metin-görüntü dikkati, görüntü-metin dikkati, metin-güçlendirici (öz-dikkat) ve çok ölçekli deformable dikkat başlıklarında ağırlıklı ortalama hesaplamak için kullanılır. dikkat softmax'ı, çift dikkat başlıklarında ağırlıklı ortalama hesaplamak için kullanılır.
- **enc_outputs_class** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.num_labels)`, *opsiyonel*, `config.two_stage=True` olduğunda döndürülür) -- İlk aşamada bölge önerileri olarak seçilen en yüksek `config.num_queries` puanlı sınırlayıcı kutuların tahmini sınırlayıcı kutu puanları. Sınırlayıcı kutu ikili sınıflandırmasının (yani ön plan ve arka plan) çıktısı.
- **enc_outputs_coord_logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, 4)`, *opsiyonel*, `config.two_stage=True` olduğunda döndürülür) -- Birinci aşamada tahmin edilen sınırlayıcı kutu koordinatlarının logitleri.
- **encoder_logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.num_labels)`, *isteğe bağlı*, `config.two_stage=True` olduğunda döndürülür) -- Birinci aşamada en yüksek puanı alan `config.num_queries` sınırlayıcı kutusunun logitleri.
- **encoder_pred_boxes** (`torch.Tensor`, şekli `(batch_size, sequence_length, 4)`, *isteğe bağlı*, `config.two_stage=True` olduğunda döndürülür) -- Birinci aşamada en yüksek puan alan `config.num_queries` sınırlayıcı kutusunun koordinatları.
Örnekler:
```python
>>> from transformers import AutoProcessor, AutoModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> text = "a cat."
>>> processor = AutoProcessor.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> model = AutoModel.from_pretrained("IDEA-Research/grounding-dino-tiny")
>>> inputs = processor(images=image, text=text, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 900, 256]
```
## GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
#### transformers.GroundingDinoForObjectDetection[[transformers.GroundingDinoForObjectDetection]]
```python
transformers.GroundingDinoForObjectDetection(config: GroundingDinoConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2385)
**Parametreler:**
config ([GroundingDinoConfig](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine bakın.
COCO algılama gibi görevler için üstünde nesne algılama başlıkları bulunan, bir omurga ve kodlayıcı-çözücü Transformer'dan oluşan Grounding DINO Model.
Bu model [PreTrainedModel](/docs/transformers/v5.23.0/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.GroundingDinoForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, input_ids: LongTensor, token_type_ids: typing.Optional[torch.LongTensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, pixel_mask: typing.Optional[torch.BoolTensor] = None, encoder_outputs: transformers.models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput | tuple | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, labels: list[dict[str, typing.Union[torch.LongTensor, torch.Tensor]]] | None = None, **kwargs)
```
[Kaynak](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/grounding_dino/modeling_grounding_dino.py#L2426)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [GroundingDinoImageProcessor.__call__()](/docs/transformers/v5.23.0/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakınız ([GroundingDinoProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoProcessor), görüntü işleme için [GroundingDinoImageProcessor](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoImageProcessor) kullanır).
input_ids (`torch.LongTensor`, şekli `(batch_size, text_sequence_length)`) : Sözlükteki girdi dizisi belirteçlerinin (token) indeksleri. Varsayılan olarak, sağlarsanız dolgu (padding) yok sayılır. İndeksler [AutoTokenizer](/docs/transformers/v5.23.0/tr/model_doc/auto#transformers.AutoTokenizer) kullanılarak elde edilebilir. Ayrıntılar için [BertTokenizer.__call__()](/docs/transformers/v5.23.0/tr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) bölümüne bakın.
token_type_ids (`torch.LongTensor`, şekli `(batch_size, text_sequence_length)`, *isteğe bağlı*) : Girdilerin ilk ve ikinci bölümlerini belirtmek için segment token dizinleri. Dizinler `[0, 1]` aralığından seçilir: 0, `sentence A` token'ına, 1 ise `sentence B` token'ına karşılık gelir [Token türü kimlikleri nelerdir?](../glossary#token-type-ids)
attention_mask (`torch.LongTensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
pixel_mask (`torch.BoolTensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Dolgu piksel değerleri üzerinde dikkat işleminin uygulanmasını önlemek için maske. `[0, 1]` aralığında seçilen maske değerleri: - Gerçek (yani **maskelenmemiş**) pikseller için 1, - Dolgu (yani **maskelenmiş**) pikseller için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
encoder_outputs (`Union[~models.grounding_dino.modeling_grounding_dino.GroundingDinoEncoderOutput, tuple]`, *isteğe bağlı*) : (`last_hidden_state`, *isteğe bağlı*: `hidden_states`, *isteğe bağlı*: `attentions`) `last_hidden_state` `(batch_size, sequence_length, hidden_size)` boyutunda, *isteğe bağlı*) bir demet, kodlayıcının son katmanının çıktısındaki gizli durumlar dizisidir. Dekodlayıcının çapraz dikkat (cross-attention) mekanizmasında kullanılır.
output_attentions (`bool`, *isteğe bağlı*) : Tüm dikkat katmanlarının dikkat tensörlerinin döndürülüp döndürülmediğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `attentions` bölümüne bakın.
output_hidden_states (`bool`, *isteğe bağlı*) : Tüm katmanların gizli durumlarının (hidden states) döndürülüp döndürülmeyeceğini belirtir. Daha fazla ayrıntı için döndürülen tensörler altındaki `hidden_states` bölümüne bakın.
return_dict (`bool`, *isteğe bağlı*) : Düz bir tuple yerine [ModelOutput](/docs/transformers/v5.23.0/tr/main_classes/output#transformers.utils.ModelOutput) döndürülecek mi?
labels (`list[Dict]`, len `(batch_size,)`, *isteğe bağlı*) : İkili eşleştirme kaybını hesaplamak için etiketler. Sözlüklerden oluşan liste, her sözlük en azından şu 2 anahtarı içerir: 'class_labels' ve 'boxes' (sırasıyla bir batch içindeki bir görüntünün sınıf etiketleri ve sınırlayıcı kutuları). Sınıf etiketlerinin kendisi, len `(number of bounding boxes in the image,)` olan bir `torch.LongTensor` ve kutuların şekli `(number of bounding boxes in the image, 4)` olan bir `torch.Tensor` olmalıdır.
[GroundingDinoForObjectDetection](/docs/transformers/v5.23.0/tr/model_doc/grounding-dino#transformers.GroundingDinoForObjectDetection) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
Örnekler:
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> import torch
>>> from PIL import Image
>>> from transformers import AutoProcessor, AutoModelForZeroShotObjectDetection
>>> model_id = "IDEA-Research/grounding-dino-tiny"
>>> device = "cuda"
>>> processor = AutoProcessor.from_pretrained(model_id)
>>> model = AutoModelForZeroShotObjectDetection.from_pretrained(model_id).to(device)
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> # Check for cats and remote controls
>>> text_labels = [["a cat", "a remote control"]]
>>> inputs = processor(images=image, text=text_labels, return_tensors="pt").to(device)
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> results = processor.post_process_grounded_object_detection(
... outputs,
... threshold=0.4,
... text_threshold=0.3,
... target_sizes=[(image.height, image.width)]
... )
>>> # Retrieve the first image result
>>> result = results[0]
>>> for box, score, text_label in zip(result["boxes"], result["scores"], result["text_labels"]):
... box = [round(x, 2) for x in box.tolist()]
... print(f"Detected {text_label} with confidence {round(score.item(), 3)} at location {box}")
Detected a cat with confidence 0.479 at location [344.7, 23.11, 637.18, 374.28]
Detected a cat with confidence 0.438 at location [12.27, 51.91, 316.86, 472.44]
Detected a remote control with confidence 0.478 at location [38.57, 70.0, 176.78, 118.18]
```