# TVP
## Ikhtisar
Kerangka kerja text-visual prompting (TVP) diusulkan dalam makalah [Text-Visual Prompting for Efficient 2D Temporal Video Grounding](https://huggingface.co/papers/2303.04995) oleh Yimeng Zhang, Xin Chen, Jinghan Jia, Sijia Liu, Ke Ding.
Abstrak dari makalah tersebut adalah sebagai berikut:
*Dalam makalah ini, kami mempelajari masalah temporal video grounding (TVG), yang bertujuan untuk memprediksi titik waktu awal/akhir dari momen yang dijelaskan oleh kalimat teks dalam video panjang yang tidak dipotong. Berkat fitur visual 3D yang sangat rinci, teknik TVG telah mencapai kemajuan yang signifikan dalam beberapa tahun terakhir. Namun, kompleksitas tinggi dari jaringan saraf konvolusional 3D (CNN) membuat ekstraksi fitur visual 3D yang padat memakan waktu, yang membutuhkan sumber daya memori dan komputasi yang intensif. Menuju TVG yang efisien, kami mengusulkan kerangka text-visual prompting (TVP) yang baru, yang mengintegrasikan pola perturbasi yang dioptimalkan (yang kami sebut ‘prompts’) ke dalam input visual dan fitur teks dari model TVG. Berbeda secara tajam dengan 3D CNN, kami menunjukkan bahwa TVP memungkinkan kami untuk melatih secara efektif vision encoder dan language encoder dalam model TVG 2D dan meningkatkan kinerja fusi fitur lintas-modal menggunakan hanya fitur visual 2D sparse dengan kompleksitas rendah. Lebih lanjut, kami mengusulkan loss Temporal-Distance IoU (TDIoU) untuk pembelajaran TVG yang efisien. Eksperimen pada dua dataset benchmark, Charades-STA dan ActivityNet Captions, secara empiris menunjukkan bahwa TVP yang diusulkan secara signifikan meningkatkan kinerja 2D TVG (misalnya, peningkatan 9,79% pada Charades-STA dan peningkatan 30,77% pada ActivityNet Captions) dan mencapai percepatan inferensi 5× dibandingkan TVG yang menggunakan fitur visual 3D.*
Penelitian ini membahas *temporal video grounding* (TVG), yaitu proses menentukan waktu awal dan akhir dari peristiwa tertentu dalam video panjang, sebagaimana dijelaskan oleh kalimat teks. *Text-visual prompting* (TVP) diusulkan untuk meningkatkan TVG. TVP melibatkan integrasi pola khusus yang dikenal sebagai 'prompts' ke dalam komponen input visual (berbasis gambar) dan teks (berbasis kata) dari model TVG. Prompts ini menyediakan konteks spasial-temporal tambahan, sehingga meningkatkan kemampuan model untuk menentukan waktu peristiwa dalam video secara akurat. Pendekatan ini menggunakan input visual 2D sebagai pengganti input 3D. Meskipun input 3D menawarkan detail spasial-temporal yang lebih banyak, pemrosesannya juga lebih memakan waktu. Penggunaan input 2D dengan metode prompting bertujuan untuk memberikan tingkat konteks dan akurasi yang serupa secara lebih efisien.
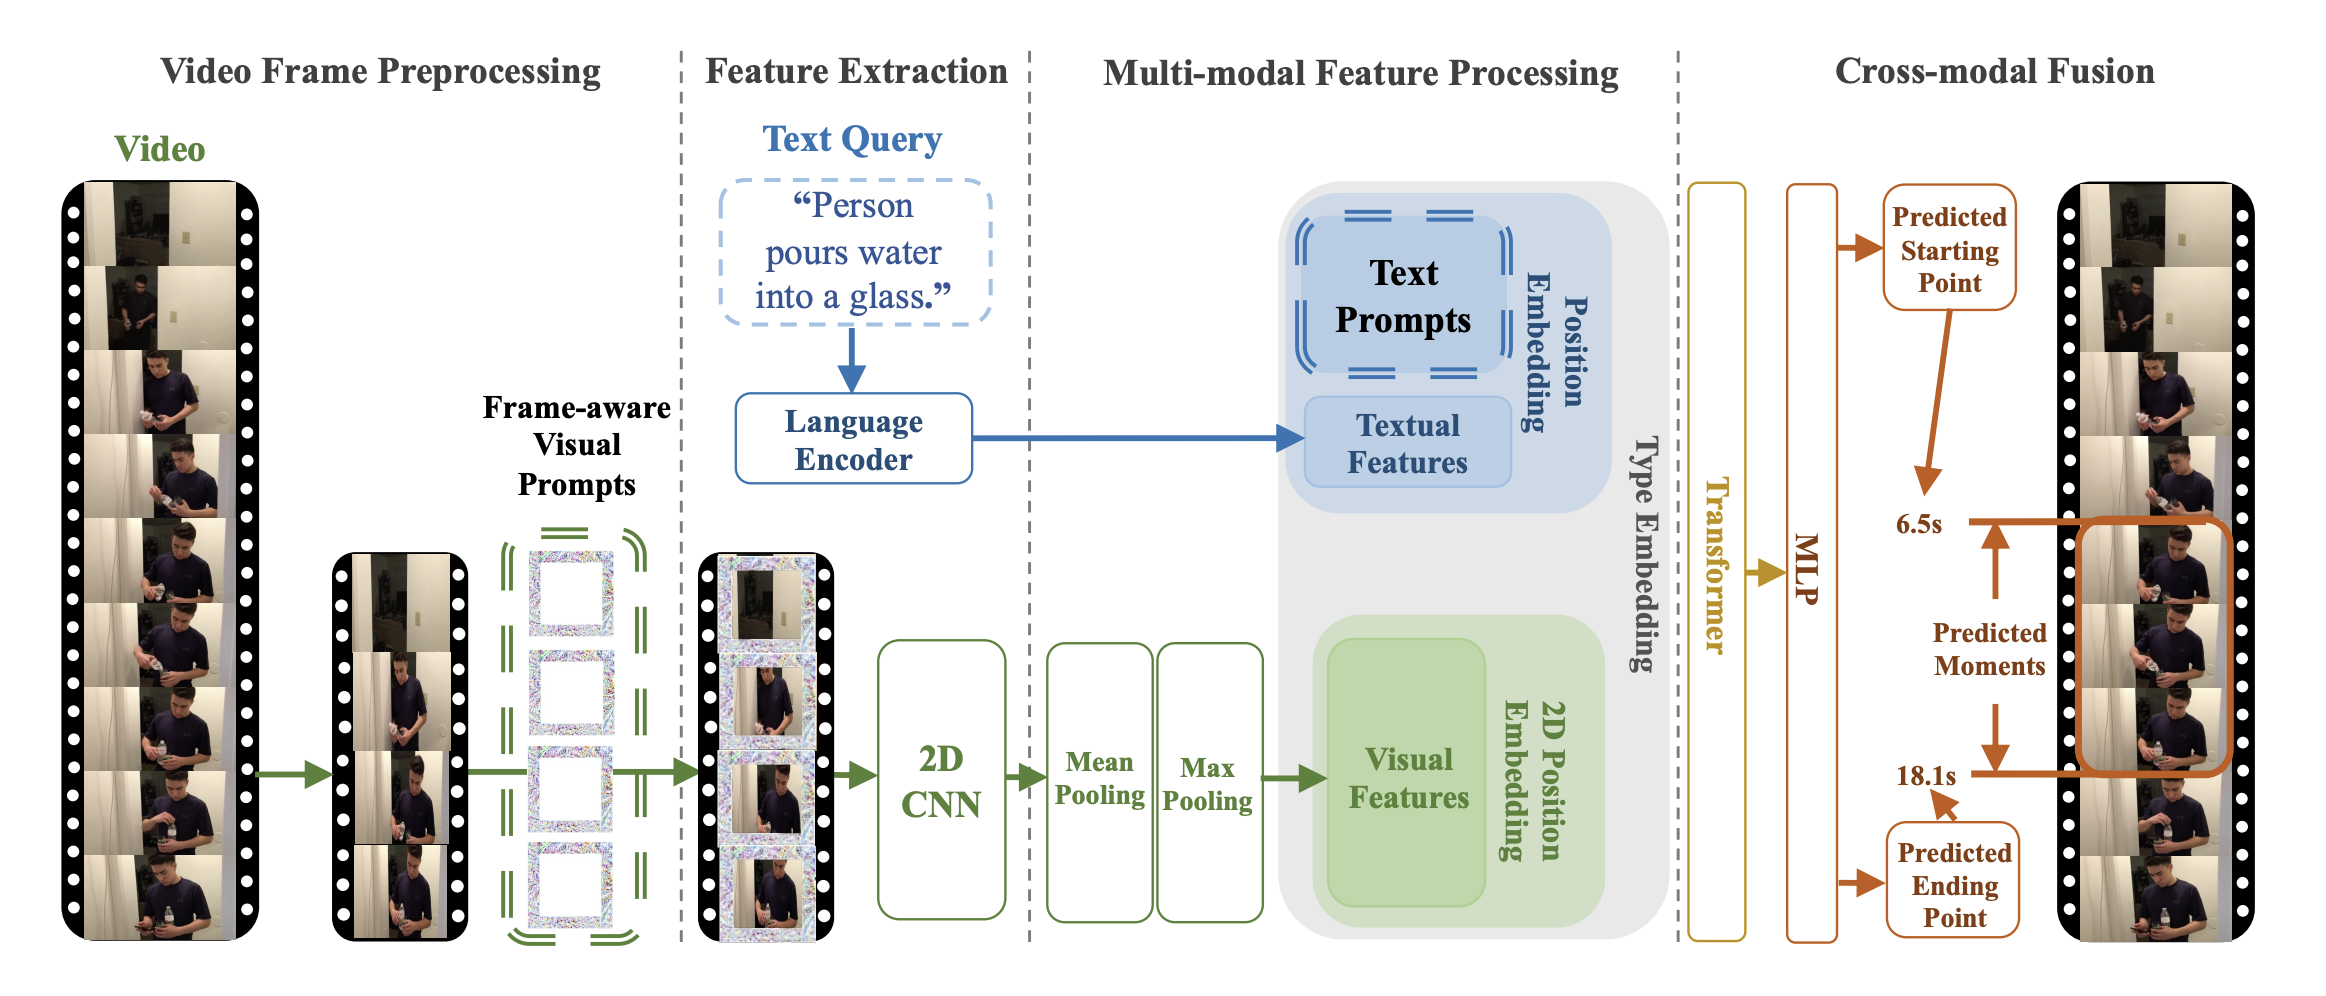 Arsitektur TVP. Diambil dari paper aslinya.
Model ini disumbangkan oleh [Jiqing Feng](https://huggingface.co/Jiqing). Kode aslinya dapat ditemukan [di sini](https://github.com/intel/TVP).
## Tips dan contoh penggunaan
Prompts adalah pola perturbasi yang dioptimalkan, yang akan ditambahkan ke bingkai video input atau fitur teks. Universal set merujuk pada penggunaan set prompts yang persis sama untuk input apa pun, yang berarti prompts ini ditambahkan secara konsisten ke semua bingkai video dan fitur teks, terlepas dari konten input.
TVP terdiri dari encoder visual dan encoder lintas-modal. Himpunan universal dari prompt visual dan prompt teks yang akan diintegrasikan ke dalam bingkai video yang diambil secara sampling dan fitur teks, masing-masing. Secara khusus, himpunan prompt visual yang berbeda diterapkan secara berurutan pada bingkai yang diambil secara sampling seragam dari satu video yang tidak dipotong.
Tujuan dari model ini adalah untuk mengintegrasikan prompt yang dapat dilatih ke dalam input visual dan fitur teks untuk masalah grounding video temporal (TVG). Secara prinsip, encoder visual atau cross-modal apa pun dapat diterapkan dalam arsitektur yang diusulkan.
[TvpProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpProcessor) membungkus [BertTokenizer](/docs/transformers/v5.23.0/id/model_doc/lxmert#transformers.BertTokenizer) dan [TvpImageProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpImageProcessor) menjadi satu instance untuk mengkodekan teks dan menyiapkan gambar, masing-masing.
Contoh berikut menunjukkan cara menjalankan temporal video grounding menggunakan [TvpProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpProcessor) dan [TvpForVideoGrounding](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpForVideoGrounding).
```python
import av
import cv2
import numpy as np
from huggingface_hub import hf_hub_download
from transformers import AutoProcessor, TvpForVideoGrounding
def pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
'''
Convert the video from its original fps to the target_fps and decode the video with PyAV decoder.
Args:
container (container): pyav container.
sampling_rate (int): frame sampling rate (interval between two sampled frames).
num_frames (int): number of frames to sample.
clip_idx (int): if clip_idx is -1, perform random temporal sampling.
If clip_idx is larger than -1, uniformly split the video to num_clips
clips, and select the clip_idx-th video clip.
num_clips (int): overall number of clips to uniformly sample from the given video.
target_fps (int): the input video may have different fps, convert it to
the target video fps before frame sampling.
Returns:
frames (tensor): decoded frames from the video. Return None if the no
video stream was found.
fps (float): the number of frames per second of the video.
'''
video = container.streams.video[0]
fps = float(video.average_rate)
clip_size = sampling_rate * num_frames / target_fps * fps
delta = max(num_frames - clip_size, 0)
start_idx = delta * clip_idx / num_clips
end_idx = start_idx + clip_size - 1
timebase = video.duration / num_frames
video_start_pts = int(start_idx * timebase)
video_end_pts = int(end_idx * timebase)
seek_offset = max(video_start_pts - 1024, 0)
container.seek(seek_offset, any_frame=False, backward=True, stream=video)
frames = {}
for frame in container.decode(video=0):
if frame.pts < video_start_pts:
continue
frames[frame.pts] = frame
if frame.pts > video_end_pts:
break
frames = [frames[pts] for pts in sorted(frames)]
return frames, fps
def decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps):
'''
Decode the video and perform temporal sampling.
Args:
container (container): pyav container.
sampling_rate (int): frame sampling rate (interval between two sampled frames).
num_frames (int): number of frames to sample.
clip_idx (int): if clip_idx is -1, perform random temporal sampling.
If clip_idx is larger than -1, uniformly split the video to num_clips
clips, and select the clip_idx-th video clip.
num_clips (int): overall number of clips to uniformly sample from the given video.
target_fps (int): the input video may have different fps, convert it to
the target video fps before frame sampling.
Returns:
frames (tensor): decoded frames from the video.
'''
assert clip_idx >= -2, f"Not a valid clip_idx {clip_idx}"
frames, fps = pyav_decode(container, sampling_rate, num_frames, clip_idx, num_clips, target_fps)
clip_size = sampling_rate * num_frames / target_fps * fps
index = np.linspace(0, clip_size - 1, num_frames)
index = np.clip(index, 0, len(frames) - 1).astype(np.int64)
frames = np.array([frames[idx].to_rgb().to_ndarray() for idx in index])
frames = frames.transpose(0, 3, 1, 2)
return frames
file = hf_hub_download(repo_id="Intel/tvp_demo", filename="AK2KG.mp4", repo_type="dataset")
model = TvpForVideoGrounding.from_pretrained("Intel/tvp-base", device_map="auto")
decoder_kwargs = dict(
container=av.open(file, metadata_errors="ignore"),
sampling_rate=1,
num_frames=model.config.num_frames,
clip_idx=0,
num_clips=1,
target_fps=3,
)
raw_sampled_frms = decode(**decoder_kwargs)
text = "a person is sitting on a bed."
processor = AutoProcessor.from_pretrained("Intel/tvp-base")
model_inputs = processor(
text=[text], videos=list(raw_sampled_frms), return_tensors="pt", max_text_length=100#, size=size
)
model_inputs["pixel_values"] = model_inputs["pixel_values"].to(model.dtype)
output = model(**model_inputs)
def get_video_duration(filename):
cap = cv2.VideoCapture(filename)
if cap.isOpened():
rate = cap.get(5)
frame_num = cap.get(7)
duration = frame_num/rate
return duration
return -1
duration = get_video_duration(file)
start, end = processor.post_process_video_grounding(output.logits, duration)
print(f"The time slot of the video corresponding to the text \"{text}\" is from {start}s to {end}s")
```
Tips:
- Implementasi TVP ini menggunakan [BertTokenizer](/docs/transformers/v5.23.0/id/model_doc/lxmert#transformers.BertTokenizer) untuk menghasilkan embedding teks dan model Resnet-50 untuk menghitung embedding visual.
- Checkpoint untuk [tvp-base](https://huggingface.co/Intel/tvp-base) yang telah dilatih sebelumnya telah dirilis.
- Silakan lihat [Tabel 2](https://huggingface.co/papers/2303.04995) untuk kinerja TVP pada tugas Temporal Video Grounding.
## TvpConfig[[transformers.TvpConfig]]
#### transformers.TvpConfig[[transformers.TvpConfig]]
```python
transformers.TvpConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, distance_loss_weight: float = 1.0, duration_loss_weight: float = 0.1, visual_prompter_type: str = 'framepad', visual_prompter_apply: str = 'replace', visual_prompt_size: int = 96, max_img_size: int = 448, num_frames: int = 48, vocab_size: int = 30522, type_vocab_size: int = 2, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, max_position_embeddings: int = 512, max_grid_col_position_embeddings: int = 100, max_grid_row_position_embeddings: int = 100, hidden_dropout_prob: float | int = 0.1, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-12, initializer_range: float = 0.02, attention_probs_dropout_prob: float | int = 0.1, pad_token_id: int | None = None)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/configuration_tvp.py#L25)
**Parameter:**
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opsional*) : Konfigurasi dari model backbone.
distance_loss_weight (`float`, *opsional*, default 1.0) : Bobot dari jarak loss.
duration_loss_weight (`float`, *opsional*, default 0.1) : Bobot dari durasi loss.
visual_prompter_type (`str`, *opsional*, defaultnya `"framepad"`) : Jenis prompt visual. Jenis padding. Framepad berarti padding pada setiap frame. Harus salah satu dari "framepad" atau "framedownpad"
visual_prompter_apply (`str`, *opsional*, defaultnya `"replace"`) : Cara menerapkan visual prompt. Replace berarti menggunakan nilai prompt untuk mengubah nilai asli dalam input visual. Harus salah satu dari "replace", atau "add", atau "remove".
visual_prompt_size (`int`, *opsional*, default 96) : Ukuran visual prompt.
max_img_size (`int`, *opsional*, defaultnya 448) : Ukuran maksimum frame.
num_frames (`int`, *opsional*, default 48) : Jumlah frame yang diekstrak dari video.
vocab_size (`int`, *opsional*, defaultnya `30522`) : Ukuran kosakata model. Menentukan jumlah token berbeda yang dapat direpresentasikan oleh `input_ids`.
type_vocab_size (`int`, *opsional*, defaultnya `2`) : Ukuran kosakata dari `token_type_ids`.
hidden_size (`int`, *opsional*, defaultnya `768`) : Dimensi dari representasi tersembunyi.
intermediate_size (`int`, *opsional*, defaultnya `3072`) : Dimensi dari representasi MLP.
num_hidden_layers (`int`, *opsional*, defaultnya `12`) : Jumlah lapisan tersembunyi dalam decoder Transformer.
num_attention_heads (`int`, *opsional*, defaultnya `12`) : Jumlah kepala perhatian untuk setiap lapisan perhatian dalam decoder Transformer.
max_position_embeddings (`int`, *opsional*, defaultnya 512) : Panjang maksimum urutan yang mungkin akan digunakan dengan model ini. Biasanya, atur ini ke nilai yang cukup besar sebagai antisipasi (misalnya, 512 atau 1024 atau 2048).
max_grid_col_position_embeddings (`int`, *opsional*, default 100) : Jumlah maksimum patch horizontal dari bingkai video.
max_grid_row_position_embeddings (`int`, *opsional*, default 100) : Jumlah maksimum patch vertikal dari bingkai video.
hidden_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.1`) : Probabilitas dropout untuk semua lapisan fully connected di embeddings, encoder, dan pooler.
hidden_act (`str`, *opsional*, defaultnya `gelu`) : Fungsi aktivasi non-linear (fungsi atau string) di decoder. Misalnya, `"gelu"`, `"relu"`, `"silu"`, dan sebagainya.
layer_norm_eps (`float`, *opsional*, defaultnya `1e-12`) : Epsilon yang digunakan oleh lapisan normalisasi lapisan.
initializer_range (`float`, *opsional*, defaultnya `0.02`) : Deviasi standar dari truncated_normal_initializer untuk menginisialisasi semua matriks bobot.
attention_probs_dropout_prob (`Union[float, int]`, *opsional*, defaultnya `0.1`) : Rasio dropout untuk probabilitas perhatian.
pad_token_id (`int`, *opsional*) : ID token yang digunakan untuk padding dalam kosakata.
Ini adalah kelas konfigurasi untuk menyimpan konfigurasi dari TvpModel. Kelas ini digunakan untuk membuat instans model Tvp sesuai dengan argumen yang ditentukan, sehingga mendefinisikan arsitektur model. Membuat instans konfigurasi dengan nilai bawaan akan menghasilkan konfigurasi yang serupa dengan konfigurasi dari [Intel/tvp-base](https://huggingface.co/Intel/tvp-base)
Objek konfigurasi mewarisi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) dan dapat digunakan untuk mengontrol keluaran model. Baca dokumentasi dari [PreTrainedConfig](/docs/transformers/v5.23.0/id/main_classes/configuration#transformers.PreTrainedConfig) untuk informasi lebih lanjut.
## TvpImageProcessor[[transformers.TvpImageProcessor]]
#### transformers.TvpImageProcessor[[transformers.TvpImageProcessor]]
```python
transformers.TvpImageProcessor(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_tvp.py#L50)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'longest_edge' : 448}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 448, 'width': 448}`): Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `2`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 448, 'width': 448}`): Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang disediakan untuk pra-pemrosesan. Jika `pad_size` tidak disediakan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_flip_channel_order (`bool`, *kwargs*, *opsional*, defaultnya `self.do_flip_channel_order`) : Apakah akan membalik urutan channel gambar dari RGB ke BGR.
constant_values (`float`, *kwargs* atau `List[float]`, *opsional*, defaultnya `self.constant_values`) : Nilai yang digunakan untuk mengisi area padding ketika `pad_mode` adalah `'constant'`.
pad_mode (`str`, *kwargs*, *opsional*, defaultnya `self.pad_mode`) : Mode padding yang digunakan — `'constant'`, `'edge'`, `'reflect'`, atau `'symmetric'`.
Membangun pemroses gambar TvpImageProcessor.
#### preprocess[[transformers.TvpImageProcessor.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_tvp.py#L72)
**Parameter:**
videos (`ImageInput` atau `list[ImageInput]` atau `list[list[ImageInput]]`) : Frame yang akan dipreprocess.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_flip_channel_order (`bool`, *kwargs*, *opsional*, defaultnya `self.do_flip_channel_order`) : Apakah akan membalik urutan channel gambar dari RGB ke BGR.
constant_values (`float`, *kwargs* atau `List[float]`, *opsional*, defaultnya `self.constant_values`) : Nilai yang digunakan untuk mengisi area padding ketika `pad_mode` adalah `'constant'`.
pad_mode (`str`, *kwargs*, *opsional*, defaultnya `self.pad_mode`) : Mode padding yang digunakan — `'constant'`, `'edge'`, `'reflect'`, atau `'symmetric'`.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## TvpImageProcessorPil[[transformers.TvpImageProcessorPil]]
#### transformers.TvpImageProcessorPil[[transformers.TvpImageProcessorPil]]
```python
transformers.TvpImageProcessorPil(**kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_pil_tvp.py#L72)
**Parameter:**
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'longest_edge' : 448}`): Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*, defaultnya `False`) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 448, 'width': 448}`): Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, defaultnya `2`) : Filter resampling yang digunakan jika mengubah ukuran gambar. Ini bisa berupa salah satu enum `PILImageResampling`. Hanya berdampak jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*, defaultnya `0.00392156862745098`) : Faktor rescale untuk melakukan rescale pada gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*, defaultnya `[0.5, 0.5, 0.5]`) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaultnya `{'height' : 448, 'width': 448}`): Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang disediakan untuk pra-pemrosesan. Jika `pad_size` tidak disediakan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*, defaultnya `True`) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_flip_channel_order (`bool`, *kwargs*, *opsional*, defaultnya `self.do_flip_channel_order`) : Apakah akan membalik urutan channel gambar dari RGB ke BGR.
constant_values (`float`, *kwargs* atau `List[float]`, *opsional*, defaultnya `self.constant_values`) : Nilai yang digunakan untuk mengisi area padding ketika `pad_mode` adalah `'constant'`.
pad_mode (`str`, *kwargs*, *opsional*, defaultnya `self.pad_mode`) : Mode padding yang digunakan — `'constant'`, `'edge'`, `'reflect'`, atau `'symmetric'`.
Membangun pemroses gambar TvpImageProcessor.
#### preprocess[[transformers.TvpImageProcessorPil.preprocess]]
```python
preprocess(videos: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]], list[list[typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]]]], **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/image_processing_pil_tvp.py#L94)
**Parameter:**
videos (`ImageInput` atau `list[ImageInput]` atau `list[list[ImageInput]]`) : Frame yang akan dipreprocess.
do_convert_rgb (`bool`, *kwargs*, *opsional*) : Apakah akan mengkonversi gambar ke RGB.
do_resize (`bool`, *kwargs*, *opsional*) : Apakah akan mengubah ukuran gambar.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Menjelaskan dimensi input maksimum ke model.
default_to_square (`bool`, *kwargs*, *opsional*) : Apakah secara default menggunakan gambar persegi saat mengubah ukuran, jika size berupa int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran gambar keluaran setelah menerapkan `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filter resampling yang digunakan saat mengubah ukuran gambar. Nilai ini dapat berupa salah satu enum `PILImageResampling`. Hanya berpengaruh jika `do_resize` diatur ke `True`.
do_rescale (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan penskalaan ulang pada gambar.
rescale_factor (`float`, *kwargs*, *opsional*) : Faktor penskalaan ulang untuk menskalakan ulang gambar jika `do_rescale` diatur ke `True`.
do_normalize (`bool`, *kwargs*, *opsional*) : Apakah akan menormalisasi gambar.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Rata-rata gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsional*) : Standar deviasi gambar yang digunakan untuk normalisasi. Hanya berpengaruh jika `do_normalize` diatur ke `True`.
do_pad (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan padding pada gambar. Padding dilakukan hingga ukuran terbesar dalam batch atau hingga ukuran persegi tetap per gambar. Strategi padding yang tepat bergantung pada model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Ukuran dalam `{"height": int, "width" int}` untuk melakukan padding pada gambar. Harus lebih besar dari ukuran gambar mana pun yang diberikan untuk pra-pemrosesan. Jika `pad_size` tidak diberikan, gambar akan di-pad hingga tinggi dan lebar terbesar dalam batch. Diterapkan hanya ketika `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opsional*) : Apakah akan melakukan center crop pada gambar.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Hanya `ChannelDimension.FIRST` yang didukung. Ditambahkan untuk kompatibilitas dengan prosesor lambat.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opsional*) : Format dimensi channel untuk gambar input. Jika tidak disetel, format dimensi channel akan disimpulkan dari gambar input. Bisa berupa salah satu dari: - `"channels_first"` atau `ChannelDimension.FIRST`: gambar dalam format (num_channels, height, width). - `"channels_last"` atau `ChannelDimension.LAST`: gambar dalam format (height, width, num_channels). - `"none"` atau `ChannelDimension.NONE`: gambar dalam format (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Perangkat untuk memproses video. Jika tidak disetel, perangkat akan disimpulkan dari video input.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Mengembalikan tensor yang ditumpuk jika disetel ke `'pt'`, selain itu mengembalikan daftar tensor.
disable_grouping (`bool`, *kwargs*, *opsional*) : Apakah akan menonaktifkan pengelompokan gambar berdasarkan ukuran untuk memprosesnya secara individual dan tidak dalam batch. Jika None, akan diset ke True jika gambar berada di CPU, dan False selain itu. Pilihan ini didasarkan pada pengamatan empiris, seperti yang dijelaskan di sini: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opsional*) : Jumlah token gambar yang akan digunakan untuk setiap gambar dalam input. Ditambahkan untuk kompatibilitas mundur, tetapi ini sebaiknya diatur sebagai atribut prosesor pada model-model mendatang.
do_flip_channel_order (`bool`, *kwargs*, *opsional*, defaultnya `self.do_flip_channel_order`) : Apakah akan membalik urutan channel gambar dari RGB ke BGR.
constant_values (`float`, *kwargs* atau `List[float]`, *opsional*, defaultnya `self.constant_values`) : Nilai yang digunakan untuk mengisi area padding ketika `pad_mode` adalah `'constant'`.
pad_mode (`str`, *kwargs*, *opsional*, defaultnya `self.pad_mode`) : Mode padding yang digunakan — `'constant'`, `'edge'`, `'reflect'`, atau `'symmetric'`.
**Mengembalikan:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Dictionary berisi list/array/tensor yang dikembalikan oleh metode __call__ ('pixel_values', dll.).
- **tensor_type** (`Union[None, str, TensorType]`, *opsional*) -- Anda dapat memberikan tensor_type di sini untuk mengonversi daftar bilangan bulat menjadi Tensor PyTorch/Numpy saat inisialisasi.
## TvpProcessor[[transformers.TvpProcessor]]
#### transformers.TvpProcessor[[transformers.TvpProcessor]]
```python
transformers.TvpProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/processing_tvp.py#L24)
**Parameter:**
image_processor (`TvpImageProcessor`) : Prosesor gambar adalah input yang wajib.
tokenizer (`BertTokenizer`) : Tokenizer adalah input yang wajib.
Membangun TvpProcessor yang membungkus image processor dan tokenizer menjadi satu processor.
[TvpProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpProcessor) menyediakan semua fungsionalitas dari [TvpImageProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpImageProcessor) dan [BertTokenizer](/docs/transformers/v5.23.0/id/model_doc/lxmert#transformers.BertTokenizer). Lihat [~TvpImageProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpImageProcessor) dan [~BertTokenizer](/docs/transformers/v5.23.0/id/model_doc/lxmert#transformers.BertTokenizer) untuk informasi lebih lanjut.
#### __call__[[transformers.TvpProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, videos: typing.Union[list['PIL.Image.Image'], numpy.ndarray, ForwardRef('torch.Tensor'), list[numpy.ndarray], list['torch.Tensor'], list[list['PIL.Image.Image']], list[list[numpy.ndarray]], list[list['torch.Tensor']], transformers.video_utils.URL, list[transformers.video_utils.URL], list[list[transformers.video_utils.URL]], transformers.video_utils.Path, list[transformers.video_utils.Path], list[list[transformers.video_utils.Path]], NoneType] = None, audio: typing.Union[numpy.ndarray, ForwardRef('torch.Tensor'), collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/processing_utils.py#L670)
**Parameter:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *opsional*) : Gambar untuk dipreprocess. Mengharapkan satu gambar atau batch gambar dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan gambar dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
text (`Union[str, list[str], list[list[str]]]`, *opsional*) : Urutan atau batch dari urutan yang akan dienkod. Setiap urutan dapat berupa string atau daftar string (string yang sudah dipretokenisasi). Jika Anda memasukkan input yang sudah dipretokenisasi, setel `is_split_into_words=True` untuk menghindari ambiguitas dengan input yang di-batch.
videos (`Union[list[PIL.Image.Image], numpy.ndarray, torch.Tensor, list[numpy.ndarray], list[torch.Tensor], list[list[PIL.Image.Image]], list[list[numpy.ndarray]], list[list[torch.Tensor]], ~video_utils.URL, list[~video_utils.URL], list[list[~video_utils.URL]], ~video_utils.Path, list[~video_utils.Path], list[list[~video_utils.Path]]]`, *opsional*) : Video yang akan dipreprocess. Mengharapkan satu video atau batch video dengan nilai piksel berkisar dari 0 hingga 255. Jika memasukkan video dengan nilai piksel antara 0 dan 1, atur `do_rescale=False`.
audio (`Union[numpy.ndarray, torch.Tensor, collections.abc.Sequence[numpy.ndarray], collections.abc.Sequence[torch.Tensor]]`, *opsional*) : Audio atau batch audio yang akan disiapkan. Setiap audio dapat berupa array NumPy atau tensor PyTorch. Jika berupa array NumPy/tensor PyTorch, setiap audio harus memiliki bentuk (C, T), di mana C adalah jumlah channel, dan T adalah panjang sampel audio.
return_mm_token_type_ids (`bool`, *kwargs*) : Apakah akan mengembalikan id tipe token multimodal yang menunjukkan posisi token placeholder multimodal.
return_text_replacement_offsets (`bool`, *kwargs*) : Apakah akan mengembalikan offset karakter untuk setiap placeholder multimodal dan pengantinya.
return_tensors (`str` atau [TensorType](/docs/transformers/v5.23.0/id/internal/file_utils#transformers.TensorType), *opsional*) : Jika diatur, akan mengembalikan tensor dari framework tertentu. Nilai yang dapat diterima adalah: - `'pt'`: Mengembalikan objek `torch.Tensor` PyTorch. - `'np'`: Mengembalikan objek `np.ndarray` NumPy.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/v5.23.0/id/main_classes/processors#transformers.ProcessingKwargs), *opsional*) : Opsi pemrosesan tambahan untuk setiap modalitas (teks, gambar, video, audio). Parameter spesifik model tercantum di atas; lihat kelas TypedDict untuk daftar lengkap argumen yang didukung.
## TvpModel[[transformers.TvpModel]]
#### transformers.TvpModel[[transformers.TvpModel]]
```python
transformers.TvpModel(config: TvpConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L684)
**Parameter:**
config ([TvpConfig](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Tvp polos yang menghasilkan objek BaseModelOutputWithPooling tanpa head spesifik di atasnya.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.TvpModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L707)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [TvpImageProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpImageProcessor). Lihat [TvpImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([TvpProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpProcessor) menggunakan [TvpImageProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpImageProcessor) untuk memproses gambar).
attention_mask (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/v5.23.0/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** [BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau `tuple(torch.Tensor)`
[BaseModelOutputWithPooling](/docs/transformers/v5.23.0/id/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) atau tuple dari `torch.Tensor` (jika `return_dict=False` diteruskan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([TvpConfig](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpConfig)) dan input.
Metode forward dari [TvpModel](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpModel) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **last_hidden_state** (`torch.Tensor` dengan bentuk `(batch_size, sequence_length, hidden_size)`) -- Urutan hidden-states pada keluaran lapisan terakhir model.
- **pooler_output** (`torch.Tensor` dengan bentuk `(batch_size, hidden_size)`) -- Hidden-state lapisan terakhir dari token pertama dalam urutan (token klasifikasi) setelah diproses lebih lanjut melalui lapisan yang digunakan untuk tugas pra-pelatihan tambahan. Misalnya, untuk keluarga model BERT, ini mengembalikan token klasifikasi setelah diproses melalui lapisan linear dan fungsi aktivasi tanh. Bobot lapisan linear dilatih dari tujuan prediksi kalimat berikutnya (klasifikasi) selama pra-pelatihan.
- **hidden_states** (`tuple(torch.Tensor)`, *opsional*, dikembalikan saat `output_hidden_states=True` dilewatkan atau saat `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Bobot perhatian setelah softmax perhatian, digunakan untuk menghitung rata-rata berbobot di kepala self-attention.
Contoh:
```python
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpModel
>>> model = TvpModel.from_pretrained("Jiqing/tiny-random-tvp")
>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")
>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
```
## TvpForVideoGrounding[[transformers.TvpForVideoGrounding]]
#### transformers.TvpForVideoGrounding[[transformers.TvpForVideoGrounding]]
```python
transformers.TvpForVideoGrounding(config: TvpConfig)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L801)
**Parameter:**
config ([TvpConfig](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpConfig)) : Kelas konfigurasi model dengan semua parameter model. Inisialisasi dengan file konfigurasi tidak memuat bobot yang terkait dengan model, hanya konfigurasinya. Lihat metode [from_pretrained()](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel.from_pretrained) untuk memuat bobot model.
Model Tvp dengan kepala grounding video di bagian atas yang menghitung loss IoU, jarak, dan durasi.
Model ini mewarisi dari [PreTrainedModel](/docs/transformers/v5.23.0/id/main_classes/model#transformers.PreTrainedModel). Periksa dokumentasi kelas induk untuk metode generik yang diimplementasikan oleh pustaka ini untuk semua model (seperti mengunduh atau menyimpan, mengubah ukuran input embeddings, memangkas heads, dll.)
Model ini juga merupakan subclass dari [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) PyTorch. Gunakan sebagai PyTorch Module biasa dan merujuk ke dokumentasi PyTorch untuk semua hal yang berkaitan dengan penggunaan dan perilaku umum.
#### forward[[transformers.TvpForVideoGrounding.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.LongTensor] = None, labels: tuple[torch.Tensor] | None = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, interpolate_pos_encoding: bool = False, **kwargs)
```
[Sumber](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/tvp/modeling_tvp.py#L810)
**Parameter:**
input_ids (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Indeks token dari urutan input dalam kosakata. Padding akan diabaikan secara default. Indeks dapat diperoleh menggunakan [AutoTokenizer](/docs/transformers/v5.23.0/id/model_doc/auto#transformers.AutoTokenizer). Lihat [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) dan [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/id/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) untuk detailnya. [Apa itu input IDs?](../glossary#input-ids)
pixel_values (`torch.Tensor` dengan bentuk `(batch_size, num_channels, image_size, image_size)`, *opsional*) : Tensor yang sesuai dengan gambar input. Nilai piksel dapat diperoleh menggunakan [TvpImageProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpImageProcessor). Lihat [TvpImageProcessor.__call__()](/docs/transformers/v5.23.0/id/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) untuk detailnya ([TvpProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpProcessor) menggunakan [TvpImageProcessor](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpImageProcessor) untuk memproses gambar).
attention_mask (`torch.LongTensor` dengan bentuk `(batch_size, sequence_length)`, *opsional*) : Mask untuk menghindari pelaksanaan attention pada indeks token padding. Nilai mask dipilih dalam `[0, 1]`: - 1 untuk token yang **tidak di-mask**, - 0 untuk token yang **di-mask**. [Apa itu attention masks?](../glossary#attention-mask)
labels (`torch.Tensor` dengan bentuk `(batch_size, 3)`, *opsional*) : Label berisi durasi, waktu mulai, dan waktu akhir video yang sesuai dengan teks.
output_attentions (`bool`, *opsional*) : Apakah akan mengembalikan tensor perhatian dari semua lapisan perhatian. Lihat `attentions` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
output_hidden_states (`bool`, *opsional*) : Apakah akan mengembalikan hidden states dari semua lapisan. Lihat `hidden_states` di bawah tensor yang dikembalikan untuk detail lebih lanjut.
return_dict (`bool`, *opsional*) : Apakah akan mengembalikan [ModelOutput](/docs/transformers/v5.23.0/id/main_classes/output#transformers.utils.ModelOutput) alih-alih tuple biasa.
interpolate_pos_encoding (`bool`, *opsional*, defaultnya `False`) : Apakah akan menginterpolasi enkoding posisi yang telah dilatih sebelumnya.
**Mengembalikan:** `TvpVideoGroundingOutput` atau `tuple(torch.Tensor)`
Sebuah `TvpVideoGroundingOutput` atau tuple dari `torch.Tensor` (jika `return_dict=False` dilewatkan atau ketika `config.return_dict=False`) yang terdiri dari berbagai elemen tergantung pada konfigurasi ([TvpConfig](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpConfig)) dan input.
Metode forward [TvpForVideoGrounding](/docs/transformers/v5.23.0/id/model_doc/tvp#transformers.TvpForVideoGrounding) menimpa metode khusus `__call__`.
Meskipun resep untuk forward pass perlu didefinisikan di dalam fungsi ini, sebaiknya panggil instance `Module` setelahnya alih-alih fungsi ini, karena yang pertama menangani langkah-langkah pra-pemrosesan dan pasca-pemrosesan, sedangkan yang kedua mengabaikannya secara diam-diam.
- **loss** (`torch.Tensor` dengan bentuk `(1,)`, *opsional*, dikembalikan ketika `return_loss` bernilai `True`) -- Temporal-Distance IoU loss untuk video grounding.
- **logits** (`torch.Tensor` dengan bentuk `(batch_size, 2)`) -- Berisi start_time/duration dan end_time/duration. Ini adalah slot waktu dari video yang sesuai dengan teks input.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *opsional*, dikembalikan ketika `output_hidden_states=True` dilewatkan atau ketika `config.output_hidden_states=True`) -- Tuple dari `torch.Tensor` (satu untuk output dari embeddings, jika model memiliki lapisan embedding, + satu untuk output dari setiap lapisan) dengan bentuk `(batch_size, sequence_length, hidden_size)`.
Hidden-states model pada output setiap layer ditambah output embedding awal yang opsional.
- **attentions** (`tuple(torch.Tensor)`, *opsional*, dikembalikan ketika `output_attentions=True` dilewatkan atau ketika `config.output_attentions=True`) -- Tuple dari `torch.Tensor` (satu untuk setiap layer) dengan bentuk `(batch_size, num_heads, sequence_length, sequence_length)`.
Contoh:
```python
>>> import torch
>>> from transformers import AutoConfig, AutoTokenizer, TvpForVideoGrounding
>>> model = TvpForVideoGrounding.from_pretrained("Jiqing/tiny-random-tvp")
>>> tokenizer = AutoTokenizer.from_pretrained("Jiqing/tiny-random-tvp")
>>> pixel_values = torch.rand(1, 1, 3, 448, 448)
>>> text_inputs = tokenizer("This is an example input", return_tensors="pt")
>>> output = model(text_inputs.input_ids, pixel_values, text_inputs.attention_mask)
```