# BEiT
## Tổng quan
Mô hình BEiT được đề xuất trong [BEiT: BERT Pre-Training of Image Transformers](https://huggingface.co/papers/2106.08254) bởi Hangbo Bao, Li Dong và Furu Wei. Lấy cảm hứng từ BERT, BEiT là bài báo đầu tiên cho thấy việc huấn luyện trước tự giám sát (self-supervised pre-training) cho Vision Transformers (ViTs) có hiệu suất vượt trội so với huấn luyện trước có giám sát (supervised pre-training). Thay vì huấn luyện trước mô hình để dự đoán lớp của một hình ảnh (như đã thực hiện trong [bài báo ViT gốc](https://huggingface.co/papers/2010.11929)), các mô hình BEiT được huấn luyện trước để dự đoán các token thị giác từ codebook của mô hình [DALL-E](https://huggingface.co/papers/2102.12092) của OpenAI dựa trên các patch bị che (masked patches).
Tóm tắt từ bài báo như sau:
*Chúng tôi giới thiệu BEiT, một mô hình biểu diễn thị giác tự giám sát, viết tắt của Bidirectional Encoder representation from Image Transformers. Theo mô hình BERT được phát triển trong lĩnh vực xử lý ngôn ngữ tự nhiên, chúng tôi đề xuất một tác vụ mô hình hóa ảnh có che (masked image modeling) để huấn luyện trước các Transformer thị giác. Cụ thể, mỗi ảnh trong quá trình huấn luyện trước của chúng tôi có hai góc nhìn, đó là các mảnh ảnh (image patches, chẳng hạn 16x16 pixel) và các token thị giác (tức là các token rời rạc). Trước tiên, chúng tôi "tokenize" ảnh gốc thành các token thị giác. Sau đó, chúng tôi ngẫu nhiên che một số mảnh ảnh và đưa chúng vào Transformer nền tảng (backbone). Mục tiêu huấn luyện trước là khôi phục các token thị giác gốc dựa trên các mảnh ảnh đã bị làm hỏng. Sau khi huấn luyện trước BEiT, chúng tôi trực tiếp tinh chỉnh các tham số mô hình trên các tác vụ hạ nguồn bằng cách thêm các lớp tác vụ lên phía trên bộ mã hóa đã được huấn luyện trước. Kết quả thực nghiệm trên phân loại ảnh và phân đoạn ngữ nghĩa cho thấy mô hình của chúng tôi đạt được kết quả cạnh tranh so với các phương pháp huấn luyện trước trước đó. Ví dụ, BEiT kích thước base đạt độ chính xác top-1 là 83,2% trên ImageNet-1K, vượt trội đáng kể so với việc huấn luyện DeiT từ đầu (81,8%) với cùng cấu hình. Hơn nữa, BEiT kích thước large đạt 86,3% chỉ sử dụng ImageNet-1K, thậm chí còn vượt qua ViT-L được huấn luyện trước có giám sát trên ImageNet-22K (85,2%).*
Mô hình này được đóng góp bởi [nielsr](https://huggingface.co/nielsr). Mã gốc có thể được tìm thấy [tại đây](https://github.com/microsoft/unilm/tree/master/beit).
## Mẹo sử dụng
- Mô hình BEiT là các Vision Transformer thông thường, nhưng được huấn luyện trước theo cách tự giám sát thay vì có giám sát. Chúng vượt trội hơn cả [mô hình gốc (ViT)](vit) lẫn [Data-efficient Image Transformers (DeiT)](deit) khi được tinh chỉnh trên ImageNet-1K và CIFAR-100. Bạn có thể xem các notebook demo về suy luận cũng như tinh chỉnh trên dữ liệu tùy chỉnh [tại đây](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer) (bạn chỉ cần thay [ViTImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/vit#transformers.ViTImageProcessor) bằng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor) và [ViTForImageClassification](/docs/transformers/v5.23.0/vi/model_doc/vit#transformers.ViTForImageClassification) bằng [BeitForImageClassification](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForImageClassification)).
- Ngoài ra, còn có một notebook demo giới thiệu cách kết hợp image tokenizer của DALL-E với BEiT để thực hiện masked image modeling. Bạn có thể tìm thấy nó [tại đây](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BEiT).
- Vì các mô hình BEiT yêu cầu mỗi ảnh phải có cùng kích thước (độ phân giải), bạn có thể sử dụng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor) để thay đổi kích thước (hoặc tỷ lệ) và chuẩn hóa ảnh cho mô hình.
- Cả độ phân giải patch và độ phân giải hình ảnh được sử dụng trong quá trình huấn luyện trước hoặc tinh chỉnh đều được phản ánh trong tên của mỗi checkpoint. Ví dụ, `microsoft/beit-base-patch16-224` chỉ đến kiến trúc có kích thước base với độ phân giải patch là 16x16 và độ phân giải tinh chỉnh là 224x224. Tất cả các checkpoint có thể được tìm thấy trên [hub](https://huggingface.co/models?search=microsoft/beit).
- Các checkpoint khả dụng thuộc một trong ba loại: (1) chỉ được huấn luyện trước trên [ImageNet-22k](http://www.image-net.org/) (bộ sưu tập gồm 14 triệu hình ảnh và 22k lớp), (2) được huấn luyện trước trên ImageNet-22k và sau đó tinh chỉnh trên ImageNet-22k, hoặc (3) được huấn luyện trước và tinh chỉnh trên [ImageNet-1k](http://www.image-net.org/challenges/LSVRC/2012/) (còn được gọi là ILSVRC 2012, bộ sưu tập gồm 1,3 triệu hình ảnh và 1.000 lớp).
- BEiT sử dụng nhúng vị trí tương đối, lấy cảm hứng từ mô hình T5. Trong quá trình huấn luyện trước, các tác giả đã chia sẻ độ chệch vị trí tương đối giữa nhiều lớp tự chú ý. Trong quá trình tinh chỉnh, độ chệch vị trí tương đối của mỗi lớp được khởi tạo bằng độ chệch vị trí tương đối chung thu được sau khi huấn luyện trước. Lưu ý rằng, nếu muốn huấn luyện trước một mô hình từ đầu, cần đặt thuộc tính `use_relative_position_bias` hoặc `use_relative_position_bias` của [BeitConfig](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitConfig) thành `True` để thêm nhúng vị trí.
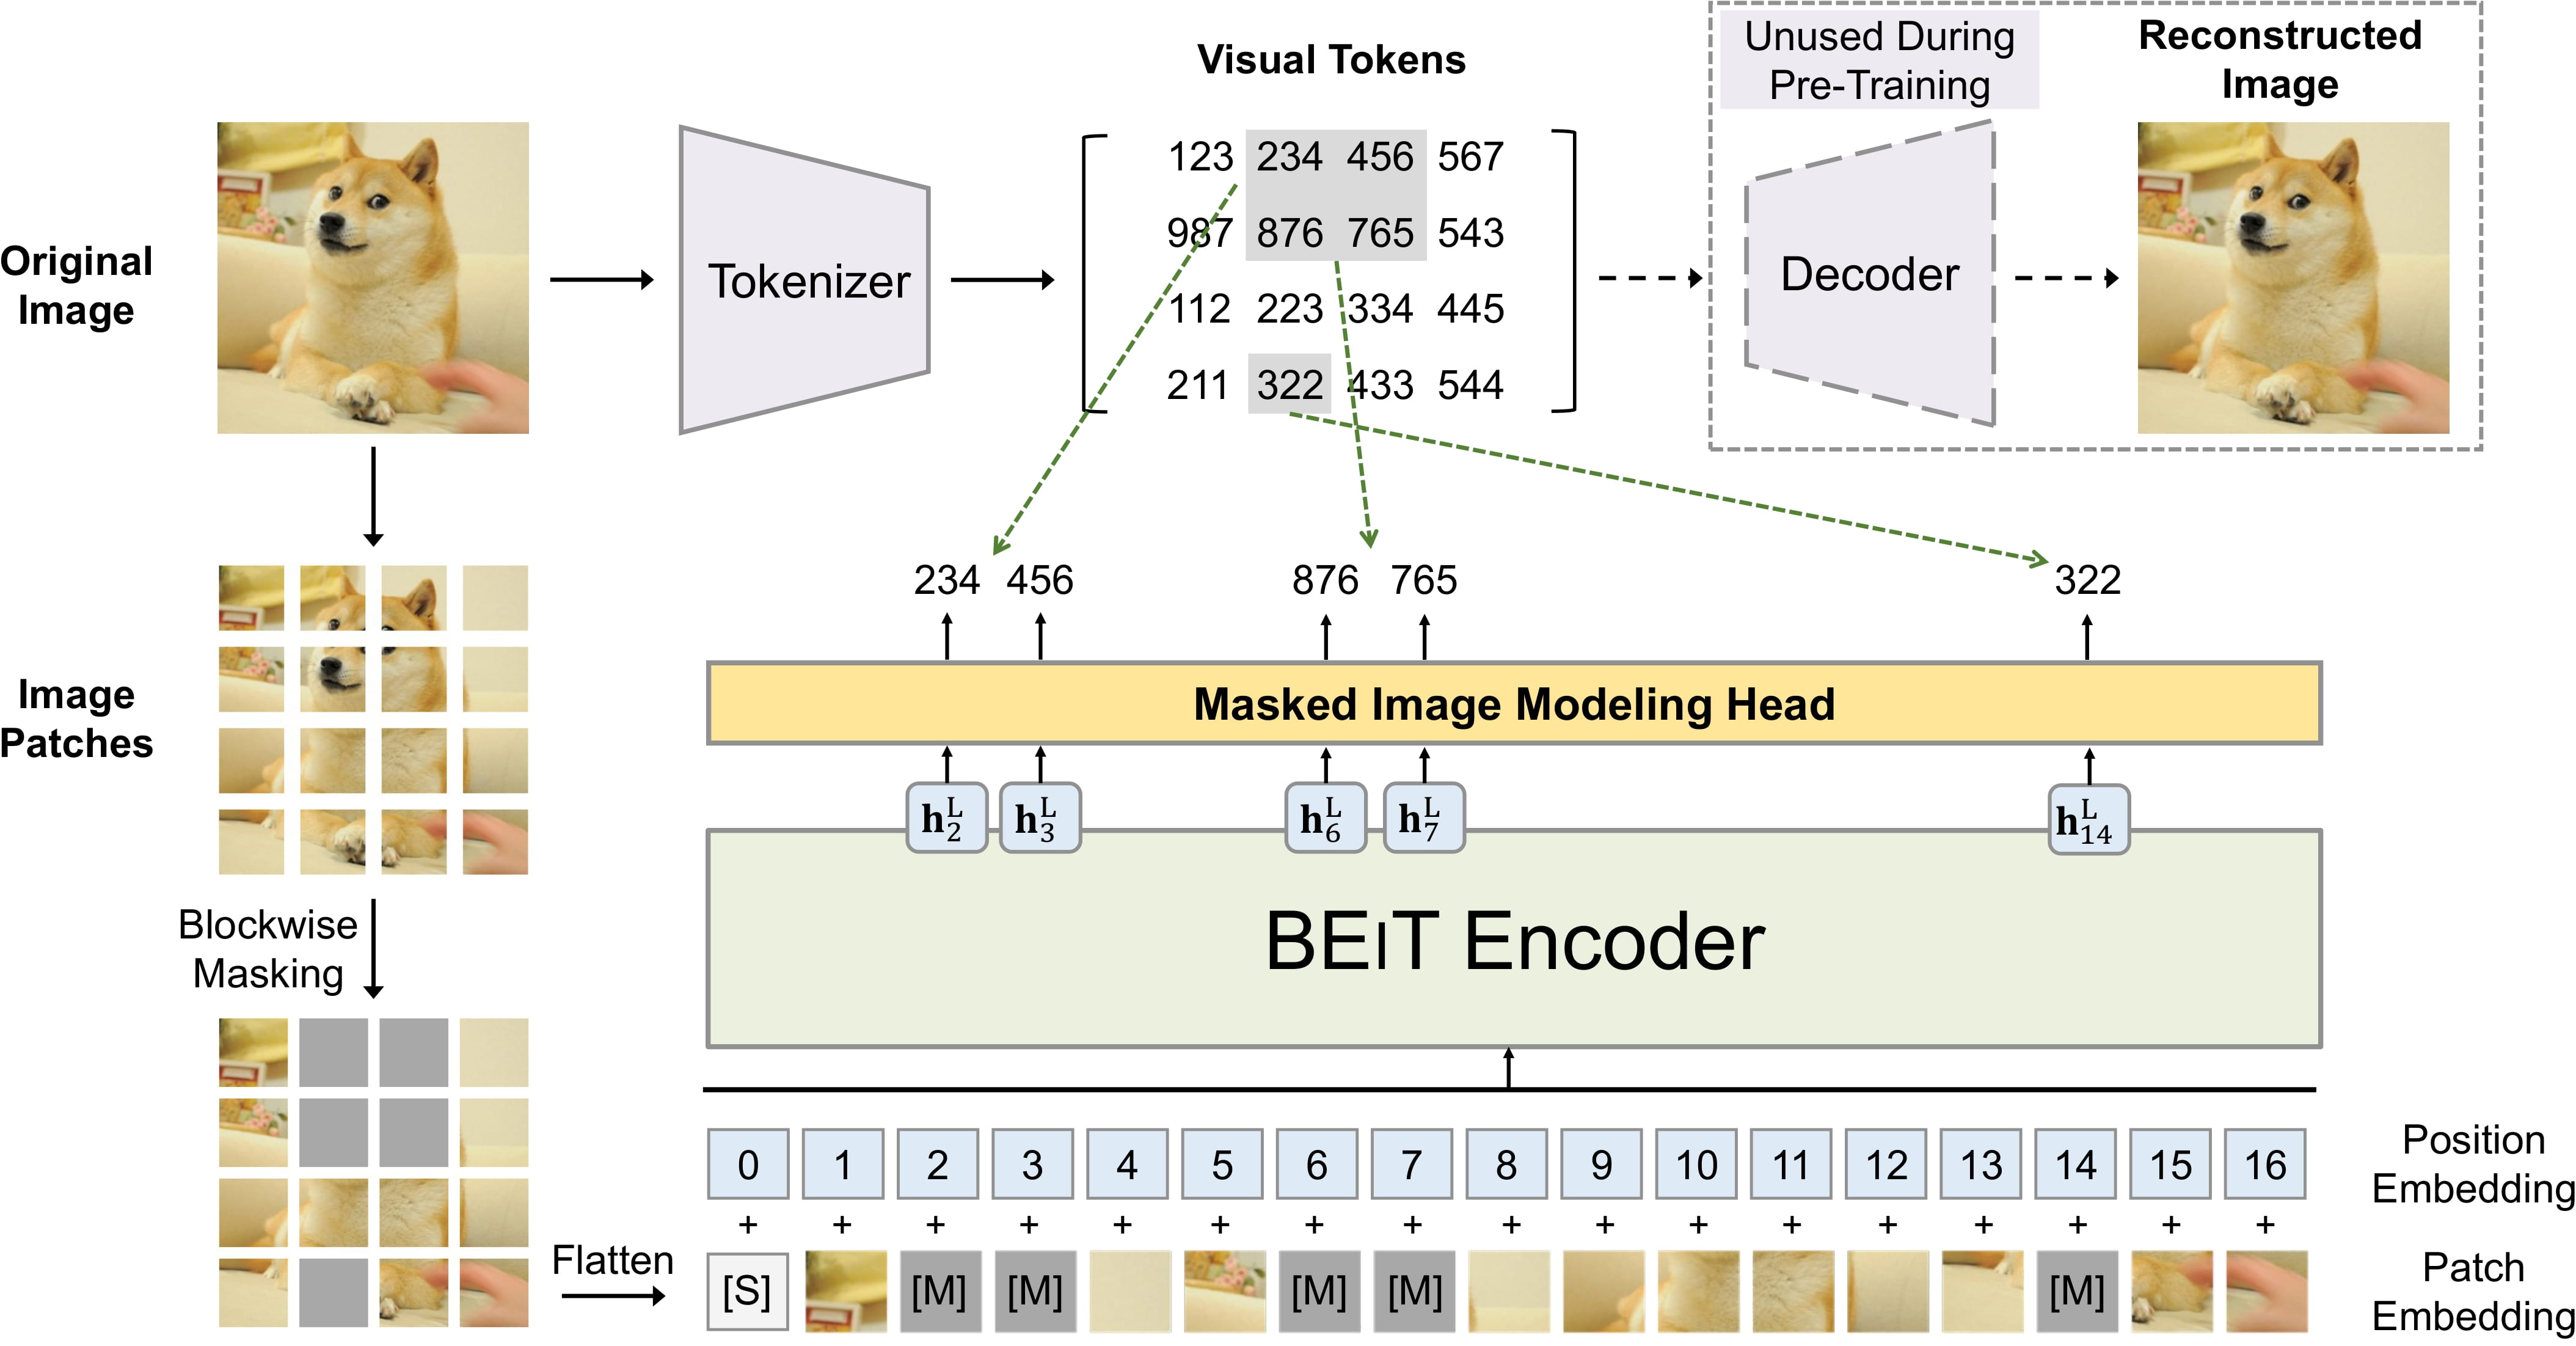 Tiền huấn luyện BEiT. Được trích từ bài báo gốc.
### Sử dụng Scaled Dot Product Attention (SDPA)
PyTorch bao gồm một toán tử scaled dot-product attention (SDPA) bản địa như một phần của `torch.nn.functional`. Hàm này bao gồm một số triển khai có thể được áp dụng tùy thuộc vào đầu vào và phần cứng đang sử dụng. Xem [tài liệu chính thức](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) hoặc trang [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) để biết thêm thông tin.
SDPA được sử dụng mặc định cho `torch>=2.1.1` khi có sẵn một bản triển khai, nhưng bạn cũng có thể đặt `attn_implementation="sdpa"` trong `from_pretrained()` để yêu cầu sử dụng SDPA một cách rõ ràng.
```python
from transformers import BeitForImageClassification
model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224", attn_implementation="sdpa", device_map="auto")
...
```
Để đạt được tốc độ tăng tốc tốt nhất, chúng tôi khuyến nghị nạp mô hình ở độ chính xác nửa (ví dụ: `torch.float16` hoặc `torch.bfloat16`).
Trên một benchmark cục bộ (NVIDIA GeForce RTX 2060-8GB, PyTorch 2.5.1, hệ điều hành Ubuntu 20.04) với `float16` và mô hình `microsoft/beit-base-patch16-224`, chúng tôi đã quan sát thấy những cải tiến sau trong quá trình huấn luyện và suy luận:
#### Huấn luyện
| num_training_steps | batch_size | image_size | is_cuda | Thời gian mỗi lô (eager - s) | Thời gian mỗi lô (sdpa - s) | Tốc độ tăng (%) | Bộ nhớ đỉnh Eager (MB) | Bộ nhớ đỉnh SDPA (MB) | Tiết kiệm bộ nhớ (%) |
|--------------------|------------|--------------|---------|----------------------------|---------------------------|-------------|----------------------|--------------------|----------------|
| 50 | 2 | (1048, 640) | True | 0.984 | 0.746 | 31.975 | 6738.915 | 4319.886 | 55.998 |
#### Suy luận
| Kích thước lô ảnh | Eager (giây/lần lặp) | Eager CI, % | Bộ nhớ Eager (MB) | SDPA (giây/lần lặp) | SDPA CI, % | Bộ nhớ SDPA (MB) | Tăng tốc SDPA | Bộ nhớ SDPA đã tiết kiệm (%) |
|-------------------:|-----------------:|:--------------|--------------------:|----------------:|:-------------|-------------------:|---------------:|----------------------:|
| 1 | 0.012 | ±0.3% | 3.76657e+08 | 0.011 | ±0.5% | 3.75739e+08 | 1.05 | 0.244 |
| 4 | 0.013 | ±0.1% | 4.03147e+08 | 0.011 | ±0.2% | 3.90554e+08 | 1.178 | 3.225 |
| 16 | 0.045 | ±0.1% | 4.96697e+08 | 0.035 | ±0.1% | 4.51232e+08 | 1.304 | 10.076 |
| 32 | 0.088 | ±0.1% | 6.24417e+08 | 0.066 | ±0.1% | 5.33488e+08 | 1.325 | 17.044 |
## Tài nguyên
Danh sách các tài nguyên chính thức của Hugging Face và cộng đồng (được đánh dấu bằng 🌎) để giúp bạn bắt đầu với BEiT.
- [BeitForImageClassification](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForImageClassification) được hỗ trợ bởi [notebook](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb) này.
- Xem thêm: [Hướng dẫn tác vụ phân loại hình ảnh](../tasks/image_classification)
**Phân đoạn ngữ nghĩa**
- [Hướng dẫn tác vụ phân đoạn ngữ nghĩa](../tasks/semantic_segmentation)
Nếu bạn quan tâm đến việc gửi một tài nguyên để được đưa vào đây, hãy thoải mái mở một Pull Request và chúng tôi sẽ xem xét! Lý tưởng nhất là tài nguyên nên minh họa một điều gì đó mới thay vì sao chép một tài nguyên hiện có.
## Đầu ra cụ thể của BEiT[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
#### transformers.models.beit.modeling_beit.BeitModelOutputWithPooling[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
```python
transformers.models.beit.modeling_beit.BeitModelOutputWithPooling(last_hidden_state: typing.Optional[torch.Tensor] = None, pooler_output: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor, ...] | None = None, attentions: tuple[torch.Tensor, ...] | None = None)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L54)
**Tham số:**
last_hidden_state (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) : Chuỗi các hidden-states tại đầu ra của lớp cuối cùng của mô hình.
pooler_output (`torch.Tensor` có shape `(batch_size, hidden_size)`) : Trung bình của các hidden states lớp cuối cùng của các patch tokens (không bao gồm token *[CLS]*) nếu *config.use_mean_pooling* được đặt thành True. Nếu đặt thành False, hidden state cuối cùng của token *[CLS]* sẽ được trả về.
hidden_states (`tuple(torch.Tensor)`, *tùy chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) : Tuple của `torch.Tensor` (một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`. Hidden-states của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
attentions (`tuple(torch.Tensor)`, *tùy chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) : Tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`. Trọng số chú ý sau softmax chú ý, được sử dụng để tính trung bình có trọng số trong các đầu chú ý tự (self-attention heads).
Lớp cho các đầu ra của [BeitModel](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitModel).
## BeitConfig[[transformers.BeitConfig]]
#### transformers.BeitConfig[[transformers.BeitConfig]]
```python
transformers.BeitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 8192, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, use_mask_token: bool = False, use_absolute_position_embeddings: bool = False, use_relative_position_bias: bool = False, use_shared_relative_position_bias: bool = False, layer_scale_init_value: float = 0.1, drop_path_rate: float | int = 0.1, use_mean_pooling: bool = True, pool_scales: list[int] | tuple[int, ...] = (1, 2, 3, 6), use_auxiliary_head: bool = True, auxiliary_loss_weight: float = 0.4, auxiliary_channels: int = 256, auxiliary_num_convs: int = 1, auxiliary_concat_input: bool = False, semantic_loss_ignore_index: int = 255, _out_features: list[str] | None = None, _out_indices: list[int] | None = None, add_fpn: bool = False, reshape_hidden_states: bool = True)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/configuration_beit.py#L25)
**Tham số:**
vocab_size (`int`, *tùy chọn*, mặc định là `8192`) : Kích thước từ vựng của mô hình. Xác định số lượng token khác nhau có thể được biểu diễn bởi `input_ids`.
hidden_size (`int`, *optional*, mặc định là `768`) : Kích thước của các biểu diễn ẩn.
num_hidden_layers (`int`, *tuỳ chọn*, mặc định là `12`) : Số lượng lớp ẩn trong bộ giải mã Transformer.
num_attention_heads (`int`, *tùy chọn*, mặc định là `12`) : Số lượng đầu chú ý cho mỗi lớp chú ý trong bộ giải mã Transformer.
intermediate_size (`int`, *tuỳ chọn*, mặc định là `3072`) : Kích thước của các biểu diễn MLP.
hidden_act (`str`, *tùy chọn*, mặc định là `gelu`) : Hàm kích hoạt phi tuyến (hàm hoặc chuỗi) trong bộ giải mã. Ví dụ, `"gelu"`, `"relu"`, `"silu"`, v.v.
hidden_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Xác suất dropout cho tất cả các lớp fully connected trong embeddings, encoder và pooler.
attention_probs_dropout_prob (`Union[float, int]`, *tùy chọn*, mặc định là `0.0`) : Tỷ lệ dropout cho các xác suất chú ý.
initializer_range (`float`, *optional*, mặc định là `0.02`) : Độ lệch chuẩn của truncated_normal_initializer để khởi tạo tất cả các ma trận trọng số.
layer_norm_eps (`float`, *tuỳ chọn*, mặc định là `1e-12`) : Epsilon được sử dụng bởi các lớp chuẩn hóa lớp (layer normalization).
image_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `224`) : Kích thước (độ phân giải) của mỗi hình ảnh.
patch_size (`Union[int, list[int], tuple[int, int]]`, *tùy chọn*, mặc định là `16`) : Kích thước (độ phân giải) của mỗi patch.
num_channels (`int`, *tuỳ chọn*, mặc định là `3`) : Số lượng kênh đầu vào.
use_mask_token (`bool`, *tùy chọn*, mặc định là `False`) : Có sử dụng token mặt nạ cho việc mô hình hóa hình ảnh có mặt nạ hay không.
use_absolute_position_embeddings (`bool`, *tùy chọn*, mặc định là `False`) : Có sử dụng nhúng vị trí tuyệt đối hay không.
use_relative_position_bias (`bool`, *tùy chọn*, mặc định là `False`) : Có sử dụng nhúng vị trí tương đối kiểu T5 trong các lớp tự chú ý hay không.
use_shared_relative_position_bias (`bool`, *tùy chọn*, mặc định là `False`) : Có sử dụng cùng các embedding vị trí tương đối cho tất cả các lớp self-attention của Transformer hay không.
layer_scale_init_value (`float`, *optional*, mặc định là `0.1`) : Hệ số tỷ lệ sử dụng trong các lớp self-attention. 0.1 cho base, 1e-6 cho large. Đặt 0 để vô hiệu hóa layer scale.
drop_path_rate (`Union[float, int]`, *tùy chọn*, mặc định là `0.1`) : Tỷ lệ drop path cho việc hợp nhất patch.
use_mean_pooling (`bool`, *tuỳ chọn*, mặc định là `True`) : Có nên lấy trung bình các trạng thái ẩn cuối cùng của các patch thay vì sử dụng trạng thái ẩn cuối cùng của token CLS, trước khi áp dụng đầu phân loại hay không.
pool_scales (`tuple[int]`, *optional*, mặc định là `[1, 2, 3, 6]`) : Các tỷ lệ pooling được sử dụng trong Pooling Pyramid Module áp dụng trên bản đồ đặc trưng cuối cùng.
use_auxiliary_head (`bool`, *tùy chọn*, mặc định là `True`) : Có sử dụng đầu phụ (auxiliary head) trong quá trình huấn luyện hay không.
auxiliary_loss_weight (`float`, *tuỳ chọn*, mặc định là 0.4) : Trọng số của tổn thất entropy chéo của đầu phụ trợ.
auxiliary_channels (`int`, *tuỳ chọn*, mặc định là 256) : Số lượng kênh được sử dụng trong đầu phụ trợ.
auxiliary_num_convs (`int`, *tuỳ chọn*, mặc định là 1) : Số lượng lớp tích chập cần sử dụng trong đầu phụ trợ.
auxiliary_concat_input (`bool`, *tùy chọn*, mặc định là `False`) : Có nối (concatenate) đầu ra của đầu phụ (auxiliary head) với đầu vào trước lớp phân loại hay không.
semantic_loss_ignore_index (`int`, *tuỳ chọn*, mặc định là `255`) : Chỉ số bị bỏ qua bởi hàm loss của mô hình phân đoạn ngữ nghĩa.
add_fpn (`bool`, *tùy chọn*, mặc định là `False`) : Có thêm FPN như một phần của backbone hay không. Chỉ liên quan đến `BeitBackbone`.
reshape_hidden_states (`bool`, *tùy chọn*, mặc định là `True`) : Có nên định dạng lại các bản đồ đặc trưng thành các tensor 4 chiều có hình dạng `(batch_size, hidden_size, height, width)` trong trường hợp mô hình được sử dụng làm backbone hay không. Nếu `False`, các bản đồ đặc trưng sẽ là các tensor 3 chiều có hình dạng `(batch_size, seq_len, hidden_size)`. Chỉ liên quan đến `BeitBackbone`.
Đây là lớp cấu hình để lưu trữ cấu hình của một BeitModel. Nó được sử dụng để khởi tạo một mô hình Beit theo các đối số được chỉ định, xác định kiến trúc của mô hình. Khởi tạo một cấu hình với các giá trị mặc định sẽ tạo ra một cấu hình tương tự như cấu hình của [microsoft/beit-base-patch16-224-pt22k](https://huggingface.co/microsoft/beit-base-patch16-224-pt22k)
Các đối tượng cấu hình kế thừa từ [PreTrainedConfig](/docs/transformers/v5.23.0/vi/main_classes/configuration#transformers.PreTrainedConfig) và có thể được sử dụng để kiểm soát đầu ra của mô hình. Đọc tài liệu từ [PreTrainedConfig](/docs/transformers/v5.23.0/vi/main_classes/configuration#transformers.PreTrainedConfig) để biết thêm thông tin.
Ví dụ:
```python
>>> from transformers import BeitConfig, BeitModel
>>> # Initializing a BEiT beit-base-patch16-224-pt22k style configuration
>>> configuration = BeitConfig()
>>> # Initializing a model (with random weights) from the beit-base-patch16-224-pt22k style configuration
>>> model = BeitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BeitImageProcessor[[transformers.BeitImageProcessor]]
#### transformers.BeitImageProcessor[[transformers.BeitImageProcessor]]
```python
transformers.BeitImageProcessor(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_beit.py#L50)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'height' : 224, 'width': 224}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'height' : 224, 'width': 224}`): Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `3`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, mặc định là `False`) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
do_reduce_labels (`bool`, *kwargs*, *optional*, mặc định là `self.do_reduce_labels`) : Có giảm tất cả các giá trị nhãn của các bản đồ phân đoạn xuống 1 hay không. Thường được sử dụng cho các bộ dữ liệu mà 0 được dùng cho nền, và bản thân nền không được bao gồm trong tất cả các lớp của bộ dữ liệu (ví dụ: ADE20k). Nhãn nền sẽ được thay thế bằng 255.
Tạo một bộ xử lý ảnh BeitImageProcessor.
#### preprocess[[transformers.BeitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_beit.py#L70)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
segmentation_maps (`ImageInput`, *tùy chọn*) : Các bản đồ phân đoạn cần tiền xử lý.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
do_reduce_labels (`bool`, *kwargs*, *optional*, mặc định là `self.do_reduce_labels`) : Có giảm tất cả các giá trị nhãn của các bản đồ phân đoạn xuống 1 hay không. Thường được sử dụng cho các bộ dữ liệu mà 0 được dùng cho nền, và bản thân nền không được bao gồm trong tất cả các lớp của bộ dữ liệu (ví dụ: ADE20k). Nhãn nền sẽ được thay thế bằng 255.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessor.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_beit.py#L183)
**Tham số:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Đầu ra thô của mô hình.
target_sizes (`list[Tuple]` có độ dài `batch_size`, *tùy chọn*) : Danh sách các bộ ba tương ứng với kích thước cuối cùng (chiều cao, chiều rộng) được yêu cầu của mỗi dự đoán. Nếu không được đặt, các dự đoán sẽ không được thay đổi kích thước.
return_segmentation_scores (`bool`, *tùy chọn*, mặc định là `False`) : Có nên trả về điểm phân đoạn cùng với bản đồ phân đoạn hay không. Khi `True`, mỗi phần tử của danh sách được trả về là một `SemanticSegmentationPostProcessorOutput` với các trường `segmentation` (ID lớp, hình dạng `(height, width)`) và `segmentation_scores` (hình dạng `(num_classes, height, width)`).
**Trả về:** `list[torch.Tensor]` hoặc `list[SemanticSegmentationPostProcessorOutput]`
Khi `return_segmentation_scores=False` (mặc định), một danh sách có độ dài `batch_size` trong đó mỗi phần tử là một bản đồ phân đoạn có hình dạng `(height, width)` với các ID lớp. Khi `return_segmentation_scores=True`, một danh sách `SemanticSegmentationPostProcessorOutput` với các trường `segmentation` (các ID lớp, hình dạng `(height, width)`) và `segmentation_scores` (hình dạng `(num_classes, height, width)`). Trong cả hai trường hợp, `(height, width)` tương ứng với kích thước đích (nếu `target_sizes` được chỉ định).
Chuyển đổi đầu ra của [BeitForSemanticSegmentation](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForSemanticSegmentation) thành các bản đồ phân đoạn ngữ nghĩa.
## BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
#### transformers.BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
```python
transformers.BeitImageProcessorPil(**kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_pil_beit.py#L53)
**Tham số:**
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'height' : 224, 'width': 224}`): Mô tả kích thước đầu vào tối đa cho mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có nên mặc định sử dụng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, mặc định là `{'height' : 224, 'width': 224}`): Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, mặc định là `3`) : Bộ lọc lấy mẫu lại (resampling filter) được sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các hằng số liệt kê (enum) của `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Xác định có nên điều chỉnh lại tỷ lệ ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*, mặc định là `0.00392156862745098`) : Hệ số để điều chỉnh lại kích thước ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*, mặc định là `True`) : Có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*, mặc định là `[0.5, 0.5, 0.5]`) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*, mặc định là `False`) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
do_reduce_labels (`bool`, *kwargs*, *optional*, mặc định là `self.do_reduce_labels`) : Có giảm tất cả các giá trị nhãn của các bản đồ phân đoạn xuống 1 hay không. Thường được sử dụng cho các bộ dữ liệu mà 0 được dùng cho nền, và bản thân nền không được bao gồm trong tất cả các lớp của bộ dữ liệu (ví dụ: ADE20k). Nhãn nền sẽ được thay thế bằng 255.
Tạo một bộ xử lý ảnh BeitImageProcessor.
#### preprocess[[transformers.BeitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_pil_beit.py#L73)
**Tham số:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ảnh cần tiền xử lý. Kỳ vọng một ảnh đơn hoặc một lô ảnh có giá trị pixel từ 0 đến 255. Nếu truyền vào các ảnh có giá trị pixel từ 0 đến 1, hãy đặt `do_rescale=False`.
segmentation_maps (`ImageInput`, *tùy chọn*) : Các bản đồ phân đoạn cần tiền xử lý.
do_convert_rgb (`bool`, *kwargs*, *optional*) : Có chuyển đổi hình ảnh sang RGB hay không.
do_resize (`bool`, *kwargs*, *optional*) : Xác định có nên thay đổi kích thước ảnh hay không.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*): Mô tả các kích thước đầu vào tối đa của mô hình.
default_to_square (`bool`, *kwargs*, *tuỳ chọn*) : Có mặc định dùng ảnh vuông khi thay đổi kích thước hay không, nếu size là một số nguyên.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước của ảnh đầu ra sau khi áp dụng `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Bộ lọc resampling để sử dụng khi thay đổi kích thước ảnh. Giá trị này có thể là một trong các enum `PILImageResampling`. Chỉ có hiệu lực khi `do_resize` được đặt thành `True`.
do_rescale (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có nên điều chỉnh lại tỷ lệ hình ảnh hay không.
rescale_factor (`float`, *kwargs*, *optional*) : Hệ số để thay đổi tỷ lệ ảnh nếu `do_rescale` được đặt thành `True`.
do_normalize (`bool`, *kwargs*, *tuỳ chọn*) : Xác định có chuẩn hóa hình ảnh hay không.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Giá trị trung bình của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *optional*) : Độ lệch chuẩn của ảnh để sử dụng cho việc chuẩn hóa. Chỉ có hiệu lực nếu `do_normalize` được đặt thành `True`.
do_pad (`bool`, *kwargs*, *optional*) : Xác định có chèn padding cho ảnh hay không. Padding được thực hiện đến kích thước lớn nhất trong batch hoặc đến một kích thước vuông cố định cho mỗi ảnh. Chiến lược padding cụ thể phụ thuộc vào model.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Kích thước ở dạng `{"height": int, "width" int}` để đệm (pad) các ảnh. Phải lớn hơn kích thước của bất kỳ ảnh nào được cung cấp cho tiền xử lý. Nếu `pad_size` không được cung cấp, các ảnh sẽ được đệm đến chiều cao và chiều rộng lớn nhất trong batch. Chỉ được áp dụng khi `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *optional*) : Có nên cắt ảnh theo kiểu căn giữa hay không.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *tuỳ chọn*) : Chỉ hỗ trợ `ChannelDimension.FIRST`. Được thêm vào để tương thích với các bộ xử lý chậm.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *optional*) : Định dạng chiều kênh cho ảnh đầu vào. Nếu không được đặt, định dạng chiều kênh sẽ được suy ra từ ảnh đầu vào. Có thể là một trong các giá trị sau: - `"channels_first"` hoặc `ChannelDimension.FIRST`: ảnh ở định dạng (num_channels, height, width). - `"channels_last"` hoặc `ChannelDimension.LAST`: ảnh ở định dạng (height, width, num_channels). - `"none"` hoặc `ChannelDimension.NONE`: ảnh ở định dạng (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Thiết bị để xử lý các video. Nếu không được đặt, thiết bị sẽ được suy ra từ các video đầu vào.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Trả về các tensor đã xếp chồng nếu được đặt thành `'pt'`, ngược lại trả về một danh sách các tensor.
disable_grouping (`bool`, *kwargs*, *optional*) : Xác định có vô hiệu hóa việc nhóm các hình ảnh theo kích thước để xử lý chúng riêng lẻ thay vì theo lô hay không. Nếu là None, giá trị sẽ được đặt thành True nếu các hình ảnh nằm trên CPU, và False trong các trường hợp khác. Lựa chọn này dựa trên các quan sát thực nghiệm, chi tiết tại đây: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *tuỳ chọn*) : Số lượng token hình ảnh sẽ được sử dụng cho mỗi hình ảnh trong đầu vào. Được thêm vào để đảm bảo tương thích ngược, nhưng trong các mô hình tương lai, giá trị này nên được đặt như một thuộc tính của bộ xử lý.
do_reduce_labels (`bool`, *kwargs*, *optional*, mặc định là `self.do_reduce_labels`) : Có giảm tất cả các giá trị nhãn của các bản đồ phân đoạn xuống 1 hay không. Thường được sử dụng cho các bộ dữ liệu mà 0 được dùng cho nền, và bản thân nền không được bao gồm trong tất cả các lớp của bộ dữ liệu (ví dụ: ADE20k). Nhãn nền sẽ được thay thế bằng 255.
**Trả về:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Từ điển chứa các danh sách/mảng/tensor được trả về bởi phương thức __call__ ('pixel_values', v.v.).
- **tensor_type** (`Union[None, str, TensorType]`, *tùy chọn*) -- Bạn có thể cung cấp tensor_type tại đây để chuyển đổi các danh sách số nguyên trong Tensor PyTorch/Numpy khi khởi tạo.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessorPil.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/image_processing_pil_beit.py#L169)
**Tham số:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Đầu ra thô của mô hình.
target_sizes (`list[Tuple]` có độ dài `batch_size`, *tùy chọn*) : Danh sách các bộ ba tương ứng với kích thước cuối cùng (chiều cao, chiều rộng) được yêu cầu của mỗi dự đoán. Nếu không được đặt, các dự đoán sẽ không được thay đổi kích thước.
return_segmentation_scores (`bool`, *tùy chọn*, mặc định là `False`) : Có nên trả về điểm phân đoạn cùng với bản đồ phân đoạn hay không. Khi `True`, mỗi phần tử của danh sách được trả về là một `SemanticSegmentationPostProcessorOutput` với các trường `segmentation` (ID lớp, hình dạng `(height, width)`) và `segmentation_scores` (hình dạng `(num_classes, height, width)`).
**Trả về:** `list[torch.Tensor]` hoặc `list[SemanticSegmentationPostProcessorOutput]`
Khi `return_segmentation_scores=False` (mặc định), một danh sách có độ dài `batch_size` trong đó mỗi phần tử là một bản đồ phân đoạn có hình dạng `(height, width)` với các ID lớp. Khi `return_segmentation_scores=True`, một danh sách `SemanticSegmentationPostProcessorOutput` với các trường `segmentation` (các ID lớp, hình dạng `(height, width)`) và `segmentation_scores` (hình dạng `(num_classes, height, width)`). Trong cả hai trường hợp, `(height, width)` tương ứng với kích thước đích (nếu `target_sizes` được chỉ định).
Chuyển đổi đầu ra của [BeitForSemanticSegmentation](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForSemanticSegmentation) thành các bản đồ phân đoạn ngữ nghĩa.
## BeitModel[[transformers.BeitModel]]
#### transformers.BeitModel[[transformers.BeitModel]]
```python
transformers.BeitModel(config: BeitConfig, add_pooling_layer: bool = True)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L486)
**Tham số:**
config ([BeitConfig](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
add_pooling_layer (`bool`, *tùy chọn*, mặc định là `True`) : Có thêm một lớp pooling hay không
Mô hình Beit cơ bản, xuất ra các hidden-state thô mà không có bất kỳ head cụ thể nào ở phía trên.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.BeitModel.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L512)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor). Xem [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết (`processor_class` sử dụng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor) để xử lý ảnh).
bool_masked_pos (`torch.BoolTensor` có shape `(batch_size, num_patches)`, *tùy chọn*) : Các vị trí bị mask dạng Boolean. Chỉ ra những patch nào bị mask (1) và những patch nào không bị mask (0).
interpolate_pos_encoding (`bool`, *tùy chọn*, mặc định là `False`) : Có nội suy các mã hóa vị trí được huấn luyện trước hay không.
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
**Trả về:** [BeitModelOutputWithPooling](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) hoặc `tuple(torch.Tensor)`
Một [BeitModelOutputWithPooling](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([BeitConfig](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitConfig)) và đầu vào.
Phương thức forward của [BeitModel](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitModel) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **last_hidden_state** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, hidden_size)`) -- Chuỗi các hidden-state tại đầu ra của lớp cuối cùng của mô hình.
- **pooler_output** (`torch.Tensor` có shape `(batch_size, hidden_size)`) -- Trung bình của các hidden states lớp cuối cùng của các patch tokens (không bao gồm token *[CLS]*) nếu *config.use_mean_pooling* được đặt thành True. Nếu đặt thành False, hidden state cuối cùng của token *[CLS]* sẽ được trả về.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
```
## BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
#### transformers.BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
```python
transformers.BeitForMaskedImageModeling(config: BeitConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L583)
**Tham số:**
config ([BeitConfig](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Model transformer Beit với đầu 'language' modeling phía trên. BEiT thực hiện masked image modeling bằng cách dự đoán các visual token của Vector-Quantize Variational Autoencoder (VQ-VAE), trong khi các model thị giác khác như ViT và DeiT dự đoán giá trị pixel RGB. Do đó, class này không tương thích với [AutoModelForMaskedImageModeling](/docs/transformers/v5.23.0/vi/model_doc/auto#transformers.AutoModelForMaskedImageModeling), vì vậy bạn sẽ cần sử dụng trực tiếp [BeitForMaskedImageModeling](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForMaskedImageModeling) nếu muốn thực hiện masked image modeling với BEiT.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.BeitForMaskedImageModeling.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L600)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor). Xem [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết (`processor_class` sử dụng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor) để xử lý ảnh).
bool_masked_pos (`torch.BoolTensor` có hình dạng `(batch_size, num_patches)`) : Các vị trí bị che bằng Boolean. Chỉ ra những patch nào bị che (1) và những patch nào không bị che (0).
labels (`torch.LongTensor` có hình dạng `(batch_size,)`, *tùy chọn*) : Nhãn để tính toán tổn thất phân loại/hồi quy hình ảnh. Chỉ số phải nằm trong `[0, ..., config.num_labels - 1]`. Nếu `config.num_labels == 1`, tổn thất hồi quy sẽ được tính toán (tổn thất Mean-Square). Nếu `config.num_labels > 1`, tổn thất phân loại sẽ được tính toán (Cross-Entropy).
interpolate_pos_encoding (`bool`, *tùy chọn*, mặc định là `False`) : Có nội suy các mã hóa vị trí được huấn luyện trước hay không.
attention_mask (`torch.Tensor` có hình dạng `(batch_size, sequence_length)`, *tùy chọn*) : Mặt nạ để tránh thực hiện chú ý trên các chỉ số token đệm. Các giá trị mặt nạ được chọn trong `[0, 1]`: - 1 cho các token **không bị che**, - 0 cho các token **bị che**. [Mặt nạ chú ý là gì?](../glossary#attention-mask)
**Trả về:** [MaskedLMOutput](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) hoặc `tuple(torch.Tensor)`
Một [MaskedLMOutput](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([BeitConfig](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitConfig)) và đầu vào.
Phương thức forward của [BeitForMaskedImageModeling](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForMaskedImageModeling) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có hình dạng `(1,)`, *tùy chọn*, được trả về khi `labels` được cung cấp) -- Tổn thất mô hình hóa ngôn ngữ có mặt nạ (MLM).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, sequence_length, config.vocab_size)`) -- Điểm dự đoán của đầu mô hình hóa ngôn ngữ (điểm cho mỗi token từ vựng trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của các embedding, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, sequence_length, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, sequence_length, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoImageProcessor, BeitForMaskedImageModeling
>>> import torch
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForMaskedImageModeling.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> num_patches = (model.config.image_size // model.config.patch_size) ** 2
>>> pixel_values = image_processor(images=image, return_tensors="pt").pixel_values
>>> # create random boolean mask of shape (batch_size, num_patches)
>>> bool_masked_pos = torch.randint(low=0, high=2, size=(1, num_patches)).bool()
>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss, logits = outputs.loss, outputs.logits
>>> list(logits.shape)
[1, 196, 8192]
```
## BeitForImageClassification[[transformers.BeitForImageClassification]]
#### transformers.BeitForImageClassification[[transformers.BeitForImageClassification]]
```python
transformers.BeitForImageClassification(config: BeitConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L675)
**Tham số:**
config ([BeitConfig](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Model transformer Beit với đầu phân loại hình ảnh phía trên (một lớp tuyến tính phía trên trung bình của các trạng thái ẩn cuối cùng của các token patch), ví dụ cho ImageNet.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.BeitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L688)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor). Xem [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết (`processor_class` sử dụng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor) để xử lý ảnh).
labels (`torch.LongTensor` có hình dạng `(batch_size,)`, *tùy chọn*) : Nhãn để tính toán tổn thất phân loại/hồi quy hình ảnh. Chỉ số phải nằm trong `[0, ..., config.num_labels - 1]`. Nếu `config.num_labels == 1`, tổn thất hồi quy sẽ được tính toán (tổn thất Mean-Square). Nếu `config.num_labels > 1`, tổn thất phân loại sẽ được tính toán (Cross-Entropy).
interpolate_pos_encoding (`bool`, *tùy chọn*, mặc định là `False`) : Có nội suy các mã hóa vị trí được huấn luyện trước hay không.
**Trả về:** [ImageClassifierOutput](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) hoặc `tuple(torch.Tensor)`
Một [ImageClassifierOutput](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([BeitConfig](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitConfig)) và đầu vào.
Phương thức forward của [BeitForImageClassification](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForImageClassification) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss phân loại (hoặc hồi quy nếu config.num_labels==1).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, config.num_labels)`) -- Điểm phân loại (hoặc hồi quy nếu config.num_labels==1) (trước SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi giai đoạn) có hình dạng `(batch_size, sequence_length, hidden_size)`. Hidden-states (còn gọi là feature maps) của mô hình tại đầu ra của mỗi giai đoạn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, patch_size, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoImageProcessor, BeitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
#### transformers.BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
```python
transformers.BeitForSemanticSegmentation(config: BeitConfig)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L978)
**Tham số:**
config ([BeitConfig](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitConfig)) : Lớp cấu hình mô hình chứa tất cả các tham số của mô hình. Khởi tạo bằng tệp cấu hình sẽ không tải trọng số liên quan đến mô hình, chỉ tải cấu hình. Xem phương thức [from_pretrained()](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel.from_pretrained) để tải trọng số mô hình.
Mô hình Beit với đầu phân đoạn ngữ nghĩa phía trên, ví dụ cho ADE20K, CityScapes.
Mô hình này kế thừa từ [PreTrainedModel](/docs/transformers/v5.23.0/vi/main_classes/model#transformers.PreTrainedModel). Xem tài liệu của lớp cha để biết các phương thức chung mà thư viện triển khai cho tất cả các mô hình của nó (chẳng hạn như tải xuống hoặc lưu trữ, thay đổi kích thước các nhúng đầu vào, cắt tỉa các đầu ra, v.v.)
Mô hình này cũng là một lớp con của [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) trong PyTorch. Hãy sử dụng nó như một Module PyTorch thông thường và tham khảo tài liệu PyTorch cho mọi vấn đề liên quan đến cách sử dụng và hành vi chung.
#### forward[[transformers.BeitForSemanticSegmentation.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Nguồn](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/beit/modeling_beit.py#L1000)
**Tham số:**
pixel_values (`torch.Tensor` có shape `(batch_size, num_channels, image_size, image_size)`, *tùy chọn*) : Các tensor tương ứng với các ảnh đầu vào. Giá trị pixel có thể được lấy bằng cách sử dụng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor). Xem [BeitImageProcessor.__call__()](/docs/transformers/v5.23.0/vi/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) để biết chi tiết (`processor_class` sử dụng [BeitImageProcessor](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitImageProcessor) để xử lý ảnh).
labels (`torch.LongTensor` có shape `(batch_size, height, width)`, *tùy chọn*) : Bản đồ phân đoạn ngữ nghĩa ground truth để tính toán loss. Các chỉ số nên nằm trong `[0, ..., config.num_labels - 1]`. Nếu `config.num_labels > 1`, một loss phân loại sẽ được tính toán (Cross-Entropy).
interpolate_pos_encoding (`bool`, *tùy chọn*, mặc định là `False`) : Có nội suy các mã hóa vị trí được huấn luyện trước hay không.
**Trả về:** [SemanticSegmenterOutput](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) hoặc `tuple(torch.Tensor)`
Một [SemanticSegmenterOutput](/docs/transformers/v5.23.0/vi/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) hoặc một tuple của `torch.Tensor` (nếu `return_dict=False` được truyền hoặc khi `config.return_dict=False`) bao gồm các phần tử khác nhau tùy thuộc vào cấu hình ([BeitConfig](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitConfig)) và đầu vào.
Phương thức forward của [BeitForSemanticSegmentation](/docs/transformers/v5.23.0/vi/model_doc/beit#transformers.BeitForSemanticSegmentation) ghi đè lên phương thức đặc biệt `__call__`.
Mặc dù công thức cho bước truyền tiến cần được định nghĩa bên trong hàm này, bạn nên gọi instance của `Module` sau đó thay vì gọi hàm này, vì instance `Module` sẽ đảm nhận việc thực hiện các bước tiền xử lý và hậu xử lý, trong khi hàm này sẽ bỏ qua chúng một cách im lặng.
- **loss** (`torch.Tensor` có shape `(1,)`, *optional*, được trả về khi `labels` được cung cấp) -- Loss phân loại (hoặc hồi quy nếu config.num_labels==1).
- **logits** (`torch.Tensor` có hình dạng `(batch_size, config.num_labels, logits_height, logits_width)`) -- Điểm phân loại cho từng pixel.
Các logits được trả về không nhất thiết có cùng kích thước với `pixel_values` được truyền vào. Điều này nhằm tránh thực hiện hai lần nội suy và mất một phần chất lượng khi người dùng cần điều chỉnh kích thước logits về kích thước ảnh gốc như một bước xử lý hậu kỳ. Bạn luôn nên kiểm tra hình dạng của logits và điều chỉnh kích thước khi cần.
- **hidden_states** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_hidden_states=True` được truyền vào hoặc khi `config.output_hidden_states=True`) -- Bộ tuple của `torch.Tensor` (một cho đầu ra của embeddings, nếu mô hình có lớp embedding, + một cho đầu ra của mỗi lớp) có hình dạng `(batch_size, patch_size, hidden_size)`.
Trạng thái ẩn của mô hình tại đầu ra của mỗi lớp cùng với các đầu ra embedding ban đầu tùy chọn.
- **attentions** (`tuple(torch.Tensor)`, *tuỳ chọn*, được trả về khi `output_attentions=True` được truyền vào hoặc khi `config.output_attentions=True`) -- Bộ tuple của `torch.Tensor` (một cho mỗi lớp) có hình dạng `(batch_size, num_heads, patch_size, sequence_length)`.
Trọng số chú ý sau softmax của attention, được sử dụng để tính trung bình có trọng số trong các đầu self-attention.
Ví dụ:
```python
>>> from transformers import AutoImageProcessor, BeitForSemanticSegmentation
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> model = BeitForSemanticSegmentation.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # logits are of shape (batch_size, num_labels, height, width)
>>> logits = outputs.logits
```