
Transformers documentation
GLM-5.3-Flash
Эта модель была добавлена в Hugging Face Transformers 26.08.2026.
GLM-5.3-Flash
Обзор
Модель GLM-5.3-Flash использует этот класс. Реализация в transformers не включает слой MTP.
GLM-5.3-Flash
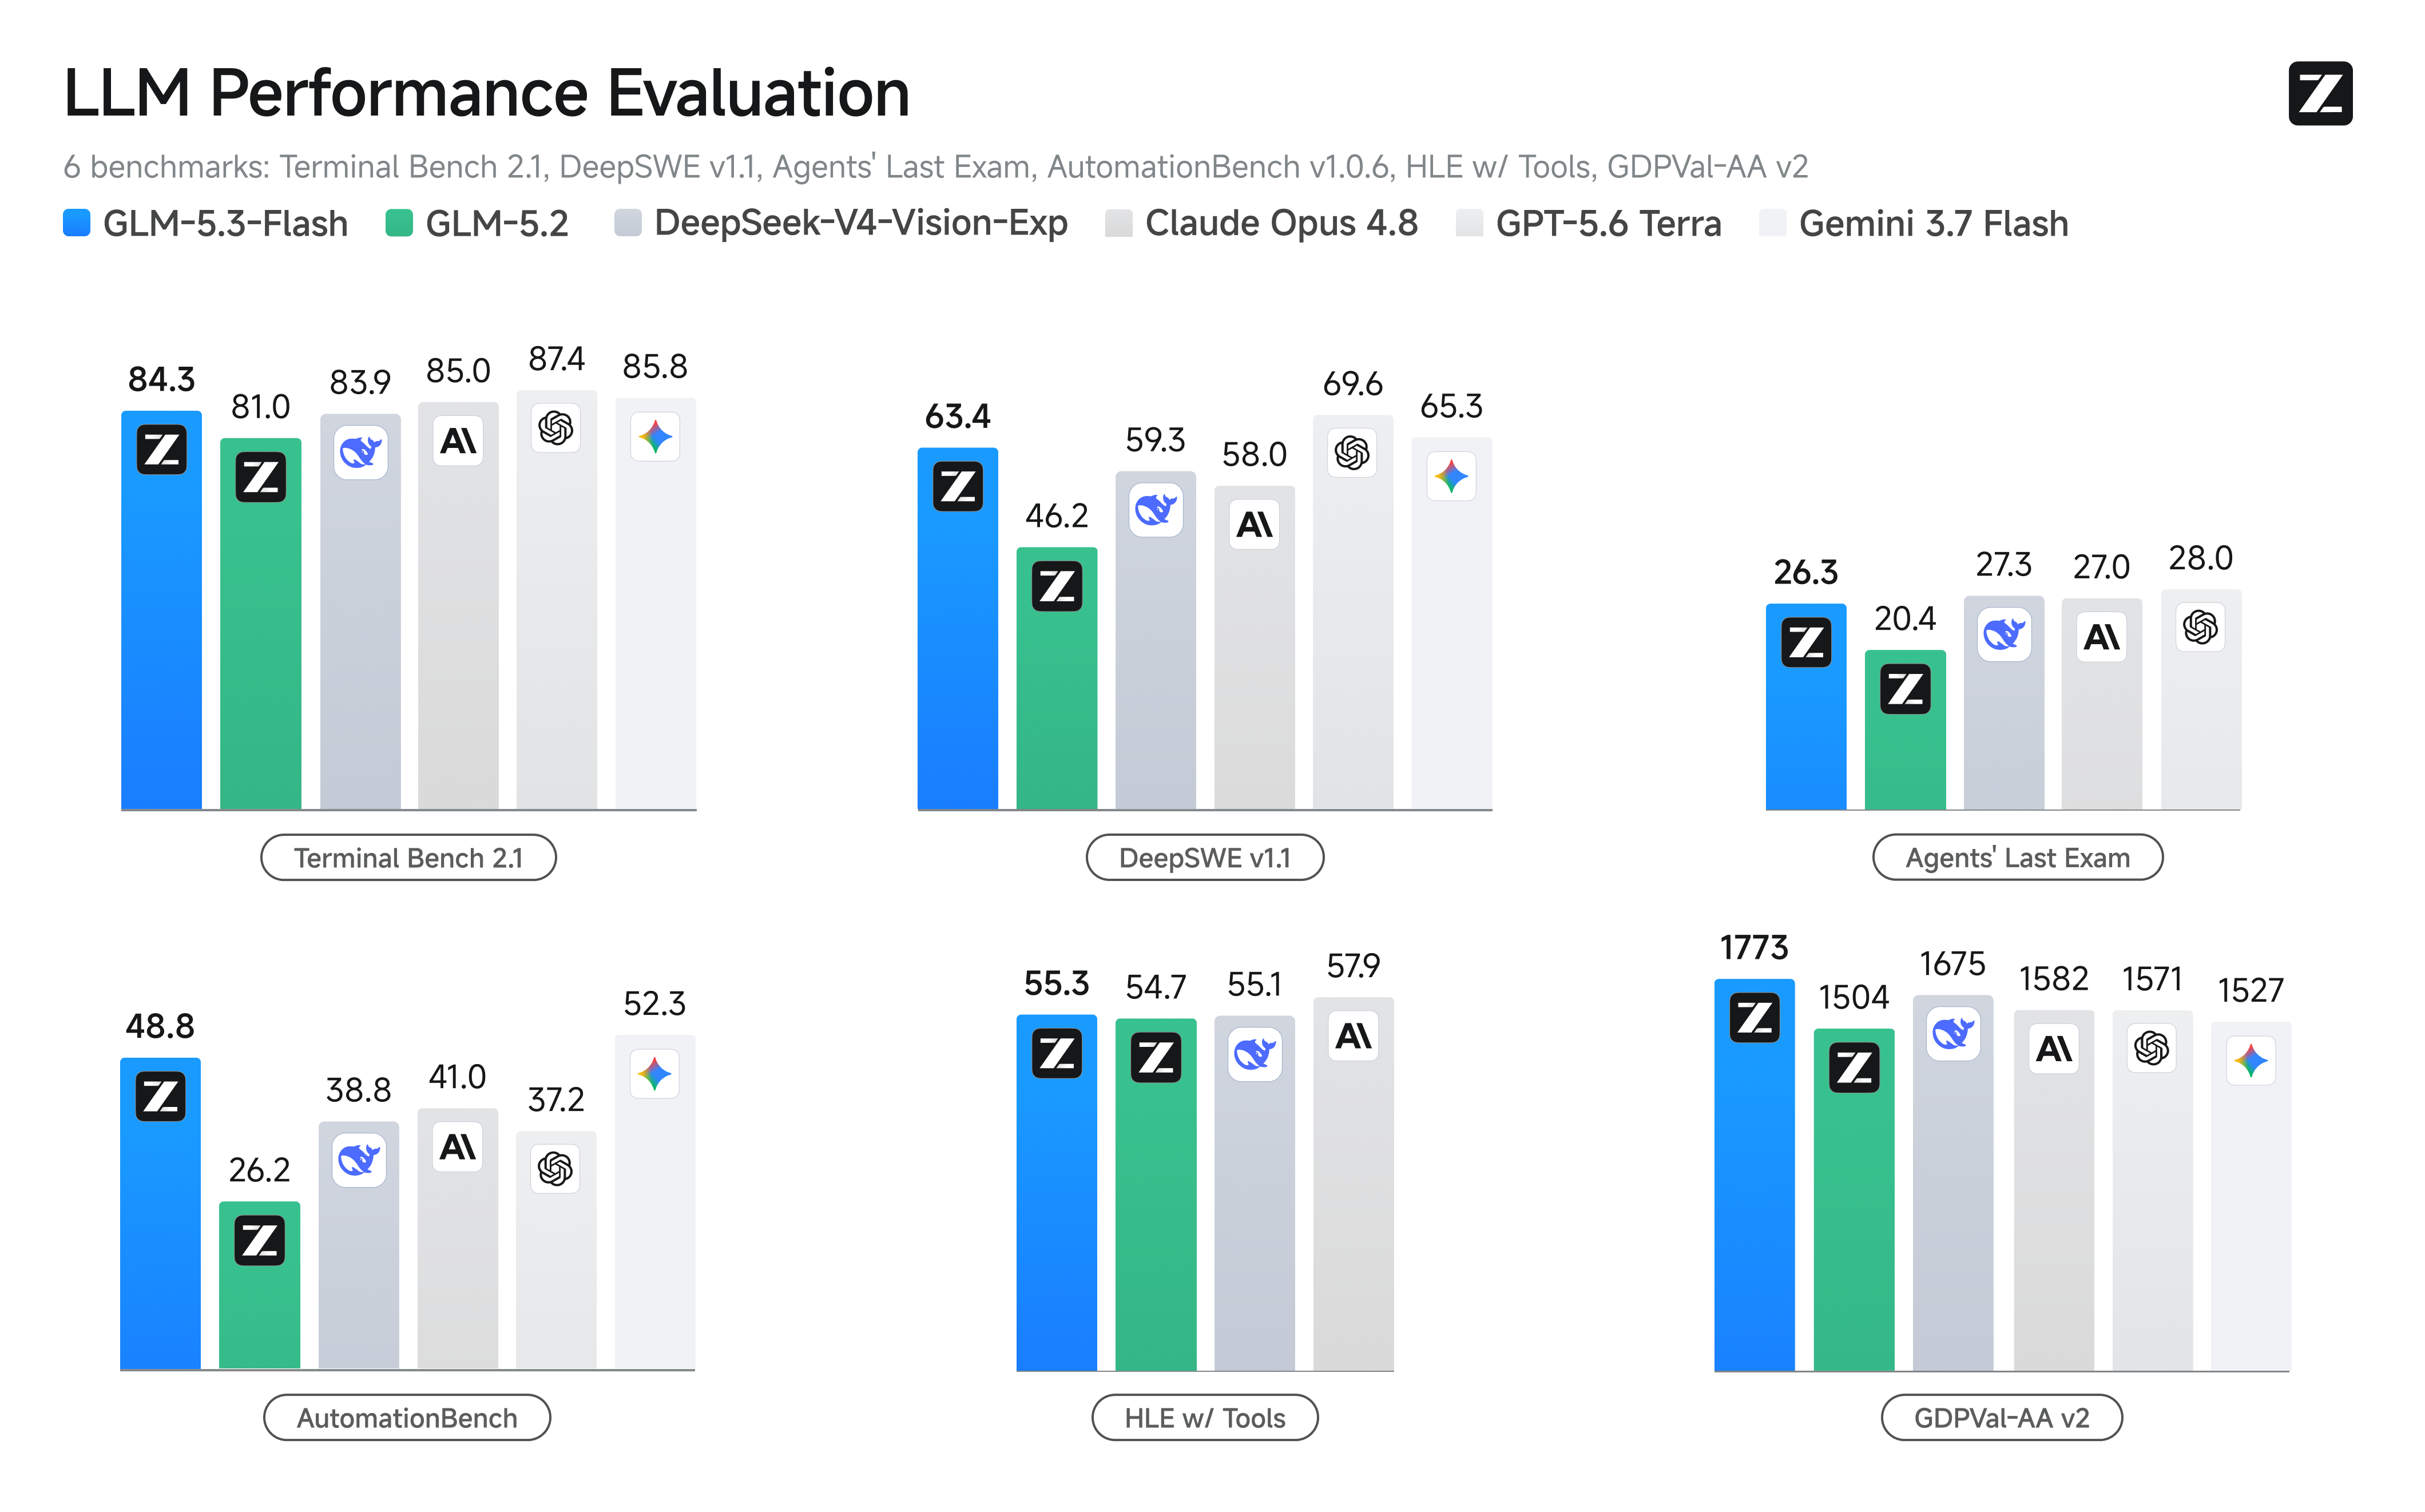
GLM-5.3-Flash — первая мультимодальная модель в серии GLM-5, работающая нативно. При общем количестве параметров 320B и лишь 18B активных параметров она превосходит GLM-5.2 по результатам бенчмарков и в реальных сценариях использования, будучи при этом в десять раз дешевле, и приближается к Claude Opus 4.8 по бенчмаркам в области программирования и агентных задач.
GLM-5.3-Flash основан на новой базовой модели, архитектура и методика обучения которой были переработаны с акцентом на возможности и эффективность. Впервые в серии GLM мы внедряем гибридную архитектуру, сочетающую разреженное и линейное внимание, что резко снижает затраты на обслуживание длинного контекста при сохранении точной работы с длинными последовательностями. Модель также использует Manifold-Constrained Hyper-Connections (mHC) для дальнейшего повышения эффективности масштабирования. В сочетании с нашим новейшим 30T-token мультимодальным корпусом для предобучения эти изменения позволяют GLM-5.3-Flash обеспечивать более высокий уровень интеллекта при меньших вычислительных затратах.
Примечания
- Используйте левое выравнивание (left padding) для пакетной генерации. См. Сторона выравнивания.
Glm5NextConfig
класс transformers.Glm5NextConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonetext_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Noneimage_token_id: int = 154854video_token_id: int = 154855image_start_token_id: int = 154830image_end_token_id: int = 154831video_start_token_id: int = 154832video_end_token_id: int = 154833tie_word_embeddings: bool = False )
Параметры
- text_config (
Union[dict, ~configuration_utils.PreTrainedConfig], необязательный) — Объект конфигурации или словарь конфигурации текстового бэкбона. - vision_config (
Union[dict, ~configuration_utils.PreTrainedConfig], необязательный) — Объект конфигурации или словарь конфигурации визуального бэкбона. - image_token_id (
int, необязательный, по умолчанию 154854) — Индекс токена изображения для кодирования изображения-запроса. - video_token_id (
int, необязательный, по умолчанию 154855) — Индекс токена видео для кодирования видеопромпта. - image_start_token_id (
int, необязательный, по умолчанию 154830) — Индекс токена начала изображения для кодирования начала изображения. - image_end_token_id (
int, необязательный, по умолчанию 154831) — Индекс токена, кодирующего конец изображения. - video_start_token_id (
int, необязательный, по умолчанию 154832) — Индекс токена начала видео для кодирования начала видео. - video_end_token_id (
int, необязательный, по умолчанию 154833) — Индекс токена конца видео, используемый для кодирования окончания видео. - tie_word_embeddings (
bool, необязательный, по умолчаниюFalse) — Определяет, следует ли связывать веса эмбеддингов согласно маппингуtied_weights_keysмодели.
Это класс конфигурации для хранения настроек модели Glm5NextModel. Он используется для создания модели Glm5 Next в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации zai-org/GLM-5.3-Flash
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Glm5NextTextConfig
класс transformers.Glm5NextTextConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonevocab_size: int = 154880hidden_size: int = 4096intermediate_size: int = 12288moe_intermediate_size: int = 2048num_hidden_layers: int = 45num_attention_heads: int = 64num_key_value_heads: int = 64n_shared_experts: int = 1n_routed_experts: int = 288output_router_logits: bool = Falserouted_scaling_factor: float = 2.5kv_lora_rank: int = 512q_lora_rank: int = 1536qk_rope_head_dim: int = 0v_head_dim: int = 256qk_nope_head_dim: int = 256n_group: int = 1topk_group: int = 1num_experts_per_tok: int = 8norm_topk_prob: bool = Truehidden_act: str = 'silu'max_position_embeddings: int = 1048576initializer_range: float = 0.02rms_norm_eps: float = 1e-05use_cache: bool = Truepad_token_id: int | None = 154820bos_token_id: int | None = Noneeos_token_id: int | list[int] | None = Nonetie_word_embeddings: bool = Falsemlp_layer_types: list[str] | None = Noneattention_bias: bool = Falseattention_dropout: float | int = 0.0index_topk: int = 2048index_head_dim: int = 128index_n_heads: int = 32head_dim: int = 0layer_types: list[str] | None = Noneindexer_types: list[str] | None = Noneswiglu_limit: float = 10.0linear_head_dim: int = 128linear_num_heads: int = 64linear_conv_kernel_dim: int = 4linear_lower_bound: float | None = -5.0hc_mult: int = 4hc_eps: float = 1e-06hc_sinkhorn_iters: int = 20router_aux_loss_coef: float = 0.001index_kpool: int = 16index_kpool_always_select_tail: bool = True )
Параметры
- vocab_size (
int, необязательный, по умолчанию154880) — Размер словаря модели. Определяет количество различных токенов, которые могут быть представлены вinput_ids. - hidden_size (
int, необязательный, по умолчанию4096) — Размерность скрытых представлений. - intermediate_size (
int, необязательный, по умолчанию12288) — Размерность представлений MLP. - moe_intermediate_size (
int, необязательный, по умолчанию2048) — Промежуточный размер MLP маршрутизированных экспертов. - num_hidden_layers (
int, необязательный, по умолчанию45) — Количество скрытых слоев в декодере Transformer. - num_attention_heads (
int, необязательный, по умолчанию64) — Количество головок внимания в каждом слое внимания декодера Transformer. - num_key_value_heads (
int, необязательный, по умолчанию64) — Это количество ключевых и value-голов, используемых для реализации Grouped Query Attention. Еслиnum_key_value_heads=num_attention_heads, модель использует Multi Head Attention (MHA); еслиnum_key_value_heads=1— Multi Query Attention (MQA); в остальных случаях используется GQA. При конвертации мультиголовного чекпоинта в GQA-чекпоинт каждая групповая ключевая и value-голова должна конструироваться путем усреднения (meanpooling) всех исходных голов в этой группе. Дополнительные подробности см. в этой статье. Если значение не указано, по умолчанию используетсяnum_attention_heads. - n_shared_experts (
int, необязательный, по умолчанию1) — Количество общих экспертов. - n_routed_experts (
int, необязательный, по умолчанию288) — Количество маршрутизируемых экспертов. - output_router_logits (
bool, необязательный, по умолчаниюFalse) — Определяет, следует ли модели возвращать логиты роутера. Включение этого параметра также позволит модели выводить вспомогательную потерю, включая потерю балансировки нагрузки и z-потерю роутера. - routed_scaling_factor (
float, необязательный, по умолчанию2.5) — Коэффициент масштабирования для маршрутизированных экспертов. - kv_lora_rank (
int, необязательный, по умолчанию512) — Ранг матриц LoRA для проекций ключей и значений. - q_lora_rank (
int, необязательный, по умолчанию1536) — Ранг матриц LoRA для проекций запросов. - qk_rope_head_dim (
int, необязательный, по умолчанию0) — Размерность заголовков запроса/ключа, для которых используются вращающиеся позиционные эмбеддинги. - v_head_dim (
int, необязательный, по умолчанию256) — Размерность heads значений. - qk_nope_head_dim (
int, необязательный, по умолчанию256) — Размерность заголовков запроса/ключа, для которых не используются вращающиеся позиционные эмбеддинги. - n_group (
int, необязательный, по умолчанию 1) — Количество групп маршрутизируемых экспертов. - topk_group (
int, необязательный, по умолчанию1) — Количество выбранных групп для каждого токена (для каждого токена, чтобы выбранные эксперты находились только в пределахtopk_groupгрупп). - num_experts_per_tok (
int, необязательный, по умолчанию8) — Количество экспертов, к которым маршрутизируется каждый токен. Это значение top-k для маршрутизации по выбору токена. - norm_topk_prob (
bool, необязательный, по умолчаниюTrue) — Определяет, следует ли нормализовать веса маршрутизированных экспертов. - hidden_act (
str, необязательный, по умолчаниюsilu) — Нелинейная функция активации (функция или строка) в декодере. Например,"gelu","relu","silu"и т. д. - max_position_embeddings (
int, необязательный, по умолчанию1048576) — Максимальная длина последовательности, с которой может использоваться эта модель. - initializer_range (
float, необязательный, по умолчанию0.02) — Стандартное отклонение truncated_normal_initializer, используемое для инициализации всех матриц весов. - rms_norm_eps (
float, необязательный, по умолчанию1e-05) — Значение epsilon, используемое слоями нормализации rms. - use_cache (
bool, необязательный, по умолчаниюTrue) — Указывает, должен ли модель возвращать последние ключи/значения внимания (не используется во всех моделях). Актуально только еслиconfig.is_decoder=Trueили если модель является генеративной моделью только с декодером. - pad_token_id (
int, необязательный, по умолчанию154820) — Идентификатор токена, используемого для выравнивания в словаре. - bos_token_id (
int, необязательный) — Идентификатор токена, используемого для обозначения начала потока в словаре. - eos_token_id (
Union[int, list[int]], необязательный) — Идентификатор токена, используемого для обозначения конца потока в словаре. - tie_word_embeddings (
bool, необязательный, по умолчаниюFalse) — Определяет, следует ли связывать веса эмбеддингов согласно маппингуtied_weights_keysмодели. - mlp_layer_types (
list[str], необязательный) — Послойная схема полносвязных слоёв. Значения:"dense"или"sparse". - attention_bias (
bool, необязательный, по умолчаниюFalse) — Использовать ли смещение (bias) в слоях проекции query, key, value и output при само-внимании. - attention_dropout (
Union[float, int], необязательный, по умолчанию0.0) — Коэффициент dropout для вероятностей внимания. - index_topk (
int, необязательный, по умолчанию 2048) — Количество позиций разреженного внимания, выбираемых индексатором DSA. - index_head_dim (
int, необязательный, по умолчанию 128) — размерность проекции head для индексирующего модуля DSA. - index_n_heads (
int, необязательный, по умолчанию 32) — Количество голов индексирующего механизма DSA. - head_dim (
int, необязательный, по умолчанию0) — Размер измерения головы внимания. Если значение равно None, по умолчанию используется hidden_size // num_attention_heads - layer_types (
list[str], необязательный) — План кэширования внимания для каждого слоя. Значения"linear_attention"для слоёв KDA и"indexed_attention"для слоёв MLA (DSA). - indexer_types (
list[str], необязательный) — Режим индексатора DSA для каждого слоя. Допустимые значения:"full"(запустить индексатор) или"shared"(использовать выбор top-k из предыдущего полного слоя). - swiglu_limit (
float, необязательный, по умолчанию 10.0) — Предел ограничения, применяемый к проекциям gate/up в SwiGLU. - linear_head_dim (
int, необязательный, по умолчанию 128) — Размерность каждого head в линейном внимании. - linear_num_heads (
int, необязательный, по умолчанию 64) — Количество головок, используемых в слоях линейного внимания. - linear_conv_kernel_dim (
int, необязательный, по умолчанию 4) — Размер ядра свёртки, используемой в слоях линейного внимания. - linear_lower_bound (
float, необязательный, по умолчанию -5.0) — Указывает, имеет ли forget gate нижнюю границу, применяемую к затуханию. - hc_mult (
int, необязательный, по умолчанию 4) — Количество остаточных потоков MHC. - hc_eps (
float, необязательный, по умолчанию 1e-6) — Нижняя граница, используемая в нормализации MHC Sinkhorn. - hc_sinkhorn_iters (
int, необязательный, по умолчанию 20) — Количество итераций Sinkhorn, используемых маршрутизацией MHC. - router_aux_loss_coef (
float, необязательный, по умолчанию0.001) — Коэффициент вспомогательной функции потерь для балансировки нагрузки. Используется для штрафования неравномерного маршрутизирования запросов к экспертам в MoE-моделях. - index_kpool (
int, необязательный, по умолчанию 16) — Размер пула сжатых групп токенов, выбранных индексатором DSA. - index_kpool_always_select_tail (
bool, необязательный, по умолчаниюTrue) — Определяет, всегда ли неполный хвост KPool включается в разреженное внимание.
Это класс конфигурации для хранения настроек модели Glm5NextModel. Он используется для создания модели Glm5 Next в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации zai-org/GLM-5.3-Flash
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Glm5NextVisionConfig
класс transformers.Glm5NextVisionConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonedepth: int = 24hidden_size: int = 1024hidden_act: str = 'silu'attention_bias: bool = Trueattention_dropout: float | int = 0.0num_heads: int = 16in_channels: int = 3image_size: int | list[int] | tuple[int, int] = 336patch_size: int | list[int] | tuple[int, int] = 14rms_norm_eps: float = 1e-05spatial_merge_size: int = 2temporal_patch_size: int | list[int] | tuple[int, int] = 2out_hidden_size: int = 1536intermediate_size: int = 4096initializer_range: float = 0.02rope_parameters: dict | None = Noneprojection_intermediate_size: int = 10240swiglu_limit: float = 10.0 )
Параметры
- depth (
int, необязательный, по умолчанию24) — Количество слоёв Transformer в визуальном энкодере. - hidden_size (
int, необязательный, по умолчанию1024) — Размерность скрытых представлений. - hidden_act (
str, необязательный, по умолчаниюsilu) — Нелинейная функция активации (функция или строка) в декодере. Например,"gelu","relu","silu"и т. д. - attention_bias (
bool, необязательный, по умолчаниюTrue) — Использовать ли смещение (bias) в слоях проекции query, key, value и output при само-внимании. - attention_dropout (
Union[float, int], необязательный, по умолчанию0.0) — Коэффициент dropout для вероятностей внимания. - num_heads (
int, необязательный, по умолчанию16) — Количество головок внимания в каждом слое внимания декодера Transformer. - in_channels (
int, необязательный, по умолчанию3) — Количество входных каналов. - image_size (
Union[int, list[int], tuple[int, int]], необязательный, по умолчанию336) — Размер (разрешение) каждого изображения. - patch_size (
Union[int, list[int], tuple[int, int]], необязательный, по умолчанию14) — Размер (разрешение) каждого патча. - rms_norm_eps (
float, необязательный, по умолчанию1e-05) — Значение epsilon, используемое слоями нормализации rms. - spatial_merge_size (
int, необязательный, по умолчанию2) — Размер пространственного окна слияния, используемого для уменьшения количества визуальных токенов путём объединения соседних патчей. - temporal_patch_size (
Union[int, list[int], tuple[int, int]], необязательный, по умолчанию2) — Размер временного патча, используемого в 3D-эмбеддинге патчей для видеовходов. - out_hidden_size (
int, необязательный, по умолчанию 1536) — Размер выходного скрытого слоя визуальной модели. - intermediate_size (
int, необязательный, по умолчанию4096) — Размерность представлений MLP. - initializer_range (
float, необязательный, по умолчанию0.02) — Стандартное отклонение truncated_normal_initializer, используемое для инициализации всех матриц весов. - rope_parameters (
dict, необязательный) — Словарь, содержащий параметры конфигурации для эмбеддингов RoPE. В словаре должно быть указано значение дляrope_thetaи, при необходимости, параметры, используемые для масштабирования, если вы хотите использовать RoPE с более длиннымиmax_position_embeddings. - projection_intermediate_size (
int, необязательный, по умолчанию 10240) — Размер projection_intermediate_size для vision patch merger. - swiglu_limit (
float, необязательный, по умолчанию 10.0) — Предел ограничения, применяемый к проекциям gate/up в SwiGLU для визуального модуля.
Это класс конфигурации для хранения настроек модели Glm5NextModel. Он используется для создания модели Glm5 Next в соответствии с указанными аргументами, определяя архитектуру модели. Создание конфигурации с параметрами по умолчанию даст конфигурацию, аналогичную конфигурации zai-org/GLM-5.3-Flash
Объекты конфигурации наследуются от PreTrainedConfig и могут использоваться для управления выводами модели. Подробнее читайте в документации PreTrainedConfig.
Glm5NextPreTrainedModel
класс transformers.Glm5NextPreTrainedModel
< source >( config: PreTrainedConfig*inputs**kwargs )
Параметры
- config (PreTrainedConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Чтобы загрузить веса модели, используйте метод from_pretrained().
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
Мок-значение для пути с точками (например, torch.float32): цепочки доступа к атрибутам и вызовы работают как пропускные декораторы, repr возвращает путь с точками, а использование в качестве базового класса подставляет обычный базовый класс type (PEP 560 __mro_entries__), благодаря чему реальные дочерние классы сохраняют обычный метакласс, а inspect.signature читает их реальный __init__, а не мок-объект.
Glm5NextTextModel
класс transformers.Glm5NextTextModel
< source >( config: Glm5NextTextConfig )
Параметры
- config (Glm5NextTextConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Чтобы загрузить веса модели, используйте метод from_pretrained().
Модель Glm5 Next Text, выводящая необработанные скрытые состояния без какого-либо специализированного слоя на выходе.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeModelOutputWithPast or tuple(torch.Tensor)
Параметры
- input_ids (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Индексы токенов входной последовательности в словаре. По умолчанию токены отсечки (padding) игнорируются.Индексы можно получить с помощью AutoTokenizer. Подробности см. в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call().
- attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- position_ids (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, необязательный) — Предвычисленные скрытые состояния (ключи и значения в блоках само-внимания и кросс-внимания), которые можно использовать для ускорения последовательного декодирования. Обычно этоpast_key_values, возвращённые моделью на предыдущем этапе декодирования, когдаuse_cache=Trueилиconfig.use_cache=True.В качестве входного параметра допускается только экземпляр Cache, см. наше руководство по кэшу KV. Если
past_key_valuesне переданы, по умолчанию будет инициализирован DynamicCache.Модель будет выводить тот же формат кэша, который был передан на вход.
Если используются
past_key_values, ожидается, что пользователь передаст только необработанныеinput_ids(те, для которых в этой модели ещё не заданы состояния прошлых ключей и значений) формы(batch_size, unprocessed_length), а не всеinput_idsформы(batch_size, sequence_length). - inputs_embeds (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — При необходимости, вместо передачиinput_idsможно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексыinput_idsпреобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели. - use_cache (
bool, необязательный) — Если установлено вTrue, возвращаются состояния ключей и значенийpast_key_values, которые можно использовать для ускорения декодирования (см.past_key_values).
Возвращает
MoeModelOutputWithPast или tuple(torch.Tensor)
MoeModelOutputWithPast или кортеж из
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (Glm5NextConfig) и входных данных.
Метод forward модели Glm5NextTextModel переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
last_hidden_state (
torch.Tensorформы(batch_size, sequence_length, hidden_size)) — Последовательность скрытых состояний на выходе последнего слоя модели.past_key_values (
Cache, необязательный, возвращается при передачеuse_cache=Trueили когдаconfig.use_cache=True) — это экземпляр Cache. Подробнее см. в нашем руководстве по кэшу kv.Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания и, при необходимости, если
config.is_encoder_decoder=True, в блоках кросс-внимания), которые можно использовать (см. входной параметрpast_key_values) для ускорения последовательного декодирования.hidden_states (
tuple(torch.Tensor), optional, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple(torch.Tensor), необязательный, возвращается при передачеoutput_attentions=Trueили приconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
router_logits (
tuple(torch.Tensor), необязательный, возвращается, если переданыoutput_router_probs=Trueиconfig.add_router_probs=Trueили еслиconfig.output_router_probs=True) — Кортежtorch.Tensor(по одному для каждого слоя) формы(batch_size, sequence_length, num_experts).Сырые логиты роутера (после softmax), вычисляемые роутерами MoE; эти значения используются для вычисления вспомогательной функции потерь в моделях Mixture of Experts.
Glm5NextModel
Glm5NextVisionModel
класс transformers.Glm5NextVisionModel
< source >( config: Glm5NextVisionConfig )
Параметры
- config (Glm5NextVisionConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация с помощью файла конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Модель Glm5 Next без дополнительных компонентов, выводящая необработанные скрытые состояния (hidden-states) без какого-либо специализированного слоя (head) сверху.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( hidden_states: Tensorgrid_thw: Tensor**kwargs ) → torch.Tensor
Метод Glm5NextVisionModel forward переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
класс transformers.Glm5NextModel
< source >( config: Glm5NextConfig )
Параметры
- config (Glm5NextConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация по файлу конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Модель Glm5 Next без дополнительных компонентов, выводящая необработанные скрытые состояния (hidden-states) без какого-либо специализированного слоя (head) сверху.
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Noneuse_cache: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = Nonepixel_values_videos: typing.Optional[torch.Tensor] = Noneimage_grid_thw: typing.Optional[torch.LongTensor] = Nonevideo_grid_thw: typing.Optional[torch.LongTensor] = Nonemm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → BaseModelOutputWithPast or tuple(torch.Tensor)
Параметры
- input_ids (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Индексы токенов входной последовательности в словаре. По умолчанию токены отсечки (padding) игнорируются.Индексы можно получить с помощью AutoTokenizer. Подробности см. в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call().
- attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- position_ids (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, необязательный) — Предвычисленные скрытые состояния (ключи и значения в блоках само-внимания и кросс-внимания), которые можно использовать для ускорения последовательного декодирования. Обычно этоpast_key_values, возвращённые моделью на предыдущем этапе декодирования, когдаuse_cache=Trueилиconfig.use_cache=True.В качестве входного параметра допускается только экземпляр Cache, см. наше руководство по кэшу KV. Если
past_key_valuesне переданы, по умолчанию будет инициализирован DynamicCache.Модель будет выводить тот же формат кэша, который был передан на вход.
Если используются
past_key_values, ожидается, что пользователь передаст только необработанныеinput_ids(те, для которых в этой модели ещё не заданы состояния прошлых ключей и значений) формы(batch_size, unprocessed_length), а не всеinput_idsформы(batch_size, sequence_length). - inputs_embeds (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — При необходимости, вместо передачиinput_idsможно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексыinput_idsпреобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели. - use_cache (
bool, необязательный) — Если установлено вTrue, возвращаются состояния ключей и значенийpast_key_values, которые можно использовать для ускорения декодирования (см.past_key_values). - pixel_values (
torch.Tensorформы(batch_size, num_channels, image_size, image_size), необязательный) — Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью Glm5NextImageProcessor. Подробности см. в Glm5NextImageProcessor.call() (Glm5NextProcessor использует Glm5NextImageProcessor для обработки изображений). - pixel_values_videos (
torch.Tensorформы(batch_size, num_frames, num_channels, frame_size, frame_size), необязательный) — Тензоры, соответствующие входному видео. Пиксельные значения для видео можно получить с помощью Glm5NextVideoProcessor. Подробности см. в Glm5NextVideoProcessor.call() (Glm5NextProcessor использует Glm5NextVideoProcessor для обработки видео). - image_grid_thw (
torch.LongTensorформы(num_images, 3), необязательный) — Временное, высотное и широтное размеры формы признаков каждого изображения в LLM. - video_grid_thw (
torch.LongTensorформы(num_videos, 3), необязательный) — Временное, вертикальное и горизонтальное размеры формы признаков каждого видео в LLM. - mm_encoder_outputs (
dict[str, ~modeling_outputs.BaseModelOutputWithPooling], необязательный) — Словарь, где ключами являются поддерживаемые модальности, а значениями — закодированные результаты для соответствующей модальности. Каждый закодированный результат представляет собой кортеж вида (pooler_output, необязательный:last_hidden_states, необязательный:hidden_states, необязательный:attentions)pooler_outputформы(batch_size, sequence_length, hidden_size), необязательный) — последовательность мультимодальных признаков энкодера, объединённых с текстовыми эмбеддингами.
Возвращает
BaseModelOutputWithPast или tuple(torch.Tensor)
Объект BaseModelOutputWithPast или кортеж
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (Glm5NextConfig) и входных данных.
Метод Glm5NextModel forward переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
last_hidden_state (
torch.Tensorформы(batch_size, sequence_length, hidden_size)) — Последовательность скрытых состояний на выходе последнего слоя модели.Если используется
past_key_values, выводится только последнее скрытое состояние последовательностей формы(batch_size, 1, hidden_size).past_key_values (
Cache, необязательный, возвращается при передачеuse_cache=Trueили когдаconfig.use_cache=True) — это экземпляр Cache. Подробнее см. в нашем руководстве по кэшу kv.Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания и, при необходимости, если
config.is_encoder_decoder=True, в блоках кросс-внимания), которые можно использовать (см. входной параметрpast_key_values) для ускорения последовательного декодирования.hidden_states (
tuple(torch.Tensor), optional, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple(torch.Tensor), необязательный, возвращается при передачеoutput_attentions=Trueили приconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Glm5NextForConditionalGeneration
класс transformers.Glm5NextForConditionalGeneration
< source >( config: Glm5NextConfig )
Параметры
- config (Glm5NextConfig) — Класс конфигурации модели, содержащий все параметры модели. Инициализация по файлу конфигурации не загружает веса, связанные с моделью, а только конфигурацию. Используйте метод from_pretrained() для загрузки весов модели.
Модель Glm5 Next для генерации токенов с условием на другие модальности (например, генерация текста из изображения и текста).
Эта модель наследуется от PreTrainedModel. См. документацию родительского класса для общих методов, которые библиотека реализует для всех своих моделей (например, загрузка или сохранение, изменение размера входных эмбеддингов, обрезка голов и т. д.)
Эта модель также является подклассом torch.nn.Module в PyTorch. Используйте её как обычный модуль PyTorch и обращайтесь к документации PyTorch по всем вопросам, связанным с общим использованием и поведением.
forward
< source >( input_ids: typing.Optional[torch.LongTensor] = Noneattention_mask: typing.Optional[torch.Tensor] = Noneposition_ids: typing.Optional[torch.LongTensor] = Nonepast_key_values: transformers.cache_utils.Cache | None = Noneinputs_embeds: typing.Optional[torch.Tensor] = Nonelabels: typing.Optional[torch.LongTensor] = Noneuse_cache: bool | None = Nonepixel_values: typing.Optional[torch.Tensor] = Nonepixel_values_videos: typing.Optional[torch.Tensor] = Noneimage_grid_thw: typing.Optional[torch.LongTensor] = Nonevideo_grid_thw: typing.Optional[torch.LongTensor] = Noneoutput_router_logits: bool | None = Nonemm_token_type_ids: typing.Optional[torch.IntTensor] = Nonelogits_to_keep: typing.Union[int, torch.Tensor] = 0mm_encoder_outputs: dict[str, transformers.modeling_outputs.BaseModelOutputWithPooling] | None = None**kwargs: *<class 'transformers.utils.generic.TransformersKwargs'> ) → MoeCausalLMOutputWithPast or tuple(torch.Tensor)
Параметры
- input_ids (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Индексы токенов входной последовательности в словаре. По умолчанию токены отсечки (padding) игнорируются.Индексы можно получить с помощью AutoTokenizer. Подробности см. в PreTrainedTokenizer.encode() и PreTrainedTokenizer.call().
- attention_mask (
torch.Tensorформы(batch_size, sequence_length), , необязательный) — Маска для исключения токенов-заполнителей из внимания. Значения маски из диапазона[0, 1]:- 1 для токенов, которые не замаскированы,
- 0 для токенов, которые замаскированы.
- position_ids (
torch.LongTensorформы(batch_size, sequence_length), , необязательный) — Индексы позиций токенов каждого входного последовательности в позиционных эмбеддингах. Выбираются из диапазона[0, config.n_positions - 1]. - past_key_values (
~cache_utils.Cache, необязательный) — Предвычисленные скрытые состояния (ключи и значения в блоках само-внимания и кросс-внимания), которые можно использовать для ускорения последовательного декодирования. Обычно этоpast_key_values, возвращённые моделью на предыдущем этапе декодирования, когдаuse_cache=Trueилиconfig.use_cache=True.В качестве входного параметра допускается только экземпляр Cache, см. наше руководство по кэшу KV. Если
past_key_valuesне переданы, по умолчанию будет инициализирован DynamicCache.Модель будет выводить тот же формат кэша, который был передан на вход.
Если используются
past_key_values, ожидается, что пользователь передаст только необработанныеinput_ids(те, для которых в этой модели ещё не заданы состояния прошлых ключей и значений) формы(batch_size, unprocessed_length), а не всеinput_idsформы(batch_size, sequence_length). - inputs_embeds (
torch.Tensorформы(batch_size, sequence_length, hidden_size), необязательный) — При необходимости, вместо передачиinput_idsможно напрямую передать встроенное представление. Это полезно, если требуется больший контроль над тем, как индексыinput_idsпреобразуются в соответствующие векторы, чем это обеспечивает внутренняя матрица поиска встраиваний модели. - labels (
torch.LongTensorформы(batch_size, sequence_length), необязательный) — Метки для вычисления потерь маскированного языкового моделирования. Индексы должны находиться в диапазоне[0, ..., config.vocab_size]или быть равны -100 (см. docstringinput_ids). Токены с индексами, установленными в-100, игнорируются (маскируются); потери вычисляются только для токенов с метками в диапазоне[0, ..., config.vocab_size]. - use_cache (
bool, необязательный) — Если установлено вTrue, возвращаются состояния ключей и значенийpast_key_values, которые можно использовать для ускорения декодирования (см.past_key_values). - pixel_values (
torch.Tensorформы(batch_size, num_channels, image_size, image_size), необязательный) — Тензоры, соответствующие входным изображениям. Значения пикселей можно получить с помощью Glm5NextImageProcessor. Подробности см. в Glm5NextImageProcessor.call() (Glm5NextProcessor использует Glm5NextImageProcessor для обработки изображений). - pixel_values_videos (
torch.Tensorформы(batch_size, num_frames, num_channels, frame_size, frame_size), необязательный) — Тензоры, соответствующие входному видео. Пиксельные значения для видео можно получить с помощью Glm5NextVideoProcessor. Подробности см. в Glm5NextVideoProcessor.call() (Glm5NextProcessor использует Glm5NextVideoProcessor для обработки видео). - image_grid_thw (
torch.LongTensorформы(num_images, 3), необязательный) — Временное, высотное и широтное размеры формы признаков каждого изображения в LLM. - video_grid_thw (
torch.LongTensorформы(num_videos, 3), необязательный) — Временное, вертикальное и горизонтальное размеры формы признаков каждого видео в LLM. - output_router_logits (
bool, необязательный) — Указывает, следует ли возвращать логиты всех роутеров. Они полезны для вычисления потерь роутера и не должны возвращаться во время инференса. - mm_token_type_ids (
torch.IntTensorформы(batch_size, sequence_length), необязательный) — Индексы токенов входной последовательности, соответствующие каждой модальности. Например, текст (0), изображение (1), видео (2). Мультимодальные идентификаторы типов токенов можно получить с помощью AutoProcessor. Подробности см. в ProcessorMixin.call(). - logits_to_keep (
Union[int, torch.Tensor], необязательный, по умолчанию0) — Если передано значение типаint, вычисляет logits для последнихlogits_to_keepтокенов. Если указано0, logits вычисляются для всехinput_ids(особый случай). Для генерации нужны logits только последнего токена, и вычисление их только для этого токена позволяет сэкономить память, что становится весьма значимым для длинных последовательностей или большого размера словаря. Если передано значение типаtorch.Tensor, оно должно быть одномерным и соответствовать индексам, которые нужно сохранить в измерении длины последовательности. Это полезно при использовании упакованного формата тензоров (один размер для batch и длины последовательности). - mm_encoder_outputs (
dict[str, ~modeling_outputs.BaseModelOutputWithPooling], необязательный) — Словарь, где ключами являются поддерживаемые модальности, а значениями — закодированные результаты для соответствующей модальности. Каждый закодированный результат представляет собой кортеж вида (pooler_output, необязательный:last_hidden_states, необязательный:hidden_states, необязательный:attentions)pooler_outputформы(batch_size, sequence_length, hidden_size), необязательный) — последовательность мультимодальных признаков энкодера, объединённых с текстовыми эмбеддингами.
Возвращает
MoeCausalLMOutputWithPast или tuple(torch.Tensor)
MoeCausalLMOutputWithPast или кортеж из
torch.Tensor (если передано return_dict=False или если config.return_dict=False), содержащий различные
элементы в зависимости от конфигурации (Glm5NextConfig) и входных данных.
Метод forward класса Glm5NextForConditionalGeneration переопределяет специальный метод __call__.
Хотя рецепт для прямого прохода должен быть определён внутри этой функции, после этого следует вызывать экземпляр
Module, а не эту функцию, поскольку первый вариант обеспечивает выполнение шагов предварительной и последующей обработки, тогда как второй молча их игнорирует.
loss (
torch.Tensorформы(1,), необязательный, возвращается, если заданlabels) — Потери языковой модели (для предсказания следующего токена).logits (
torch.Tensorформы(batch_size, sequence_length, config.vocab_size)) — Оценки предсказаний языковой модели (оценки для каждого токена словаря до применения SoftMax).aux_loss (
torch.Tensor, необязательный, возвращается при передачеoutput_router_logits=Trueили приconfig.output_router_logits=True, если модель обучает свой роутер с потерей балансировки нагрузки) — вспомогательная потеря балансировки нагрузки для разреженных модулей. Модели, которые балансируют своих экспертов с помощью смещения роутера (DeepSeek-V3 и архитектуры, производные от него), возвращают здесьNone, но при этом всё равно возвращаютrouter_logits.router_logits (
tuple(torch.Tensor), необязательный, возвращается при передачеoutput_router_logits=Trueили когдаconfig.output_router_logits=True) — Кортежtorch.Tensor(по одному для каждого разреженного слоя) формы(batch_size * sequence_length, num_experts).Сырые логиты маршрутизатора, вычисленные маршрутизаторами MoE. Их можно использовать для вычисления потерь сбалансированности нагрузки или для анализа того, как токены распределяются между экспертами.
past_key_values (
Cache, необязательный, возвращается при передачеuse_cache=Trueили когдаconfig.use_cache=True) — это экземпляр Cache. Подробнее см. в нашем руководстве по кэшу kv.Содержит предварительно вычисленные скрытые состояния (ключи и значения в блоках само-внимания), которые можно использовать (см. вход
past_key_values) для ускорения последовательного декодирования.hidden_states (
tuple(torch.Tensor), optional, возвращается, если переданоoutput_hidden_states=Trueили еслиconfig.output_hidden_states=True) — кортеж изtorch.Tensor(один для вывода слоя встраиваний, если модель имеет слой встраиваний, + один для вывода каждого слоя) формы(batch_size, sequence_length, hidden_size).Скрытые состояния модели на выходе каждого слоя, а также необязательные выходные значения начального слоя встраивания.
attentions (
tuple(torch.Tensor), необязательный, возвращается при передачеoutput_attentions=Trueили приconfig.output_attentions=True) — Кортежtorch.Tensor(по одному на каждый слой) формы(batch_size, num_heads, sequence_length, sequence_length).Веса внимания после softmax в механизме внимания, используемые для вычисления взвешенного среднего в головах само-внимания.
Пример:
>>> from transformers import AutoProcessor, Glm5NextForConditionalGeneration
>>> import torch

>>> model = Glm5NextForConditionalGeneration.from_pretrained("zai-org/GLM-5.3-Flash")
>>> processor = AutoProcessor.from_pretrained("zai-org/GLM-5.3-Flash")

>>> messages = [
...     {
...         "role": "user",
...         "content": [
...             {"type": "image", "image": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/pipeline-cat-chonk.jpeg"},
...             {"type": "text", "text": "Describe the image."},
...         ],
...     }
... ]
>>> inputs = processor.apply_chat_template(
...     messages, tokenize=True, add_generation_prompt=True, return_dict=True, return_tensors="pt"
... )
>>> inputs = {k: v.to(model.device) if isinstance(v, torch.Tensor) else v for k, v in inputs.items()}
>>> generated_ids = model.generate(**inputs, max_new_tokens=64)
Glm5NextProcessor
класс transformers.Glm5NextProcessor
< source >( image_processor = Nonetokenizer = Nonevideo_processor = Nonechat_template = None**kwargs )
Параметры
- image_processor (
Glm5NextImageProcessor) — Обработчик изображений является обязательным входным параметром. - tokenizer (
tokenizer_class) — Токенизатор является обязательным входным параметром. - video_processor (
Glm5NextVideoProcessor) — Обработчик видео является обязательным входным параметром. - chat_template (
str) — Jinja-шаблон для преобразования списков сообщений в чате в строку, пригодную для токенизации.
Создаёт Glm5NextProcessor, который объединяет процессор изображений, токенизатор и процессор видео в единый процессор.
Glm5NextProcessor предоставляет все возможности Glm5NextImageProcessor, tokenizer_class и Glm5NextVideoProcessor. Подробнее см. в ~Glm5NextImageProcessor, ~tokenizer_class и ~Glm5NextVideoProcessor.
post_process_image_text_to_text
< source >( generated_outputsskip_special_tokens = Trueclean_up_tokenization_spaces = False**kwargs ) → list[str]
Параметры
- generated_outputs (
torch.Tensorornp.ndarray) — Результат выполнения функцииgenerateмодели. Ожидается, что вывод представляет собой тензор формы(batch_size, sequence_length)или(sequence_length,). - skip_special_tokens (
bool, необязательный, по умолчаниюTrue) — Указывает, следует ли удалять специальные токены в выводе. Аргумент, передаваемый в методbatch_decodeтокенизатора. - clean_up_tokenization_spaces (
bool, необязательный, по умолчаниюFalse) — Указывает, следует ли очищать пробелы токенизации. Аргумент, передаваемый в методbatch_decodeтокенизатора. - **kwargs —
Дополнительные аргументы, передаваемые в метод
batch_decode methodтокенизатора.
Возвращает
list[str]
Раскодированный текст.
Выполните постобработку вывода модели для декодирования текста.
Glm5NextImageProcessor
класс transformers.Glm5NextImageProcessor
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
Параметры
- do_convert_rgb (
bool, kwargs, optional, по умолчаниюTrue) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, нужно ли изменять размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, по умолчанию{'longest_edge' -- 1}): Определяет максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional, по умолчаниюFalse) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задано как int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, по умолчанию3) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли выполнять рескейлинг изображения. - rescale_factor (
float, kwargs, optional, по умолчанию0.00392156862745098) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.48145466, 0.4578275, 0.40821073]) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.26862954, 0.26130258, 0.27577711]) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора. - Returns stacked tensors if set to
'pt', otherwise returns a list of tensors. —
Создаёт процессор изображений Glm5NextImageProcessor.
disable_grouping (bool, kwargs, optional):
Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками.
Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на
эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157 image_seq_length (int, kwargs, optional):
Количество токенов изображения, используемых для каждого изображения во входных данных.
Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
get_number_of_image_patches
< source >( height: intwidth: intimages_kwargs: dict | None = None ) → int
Утилита, возвращающая количество патчей изображения для заданного размера изображения.
Преобразует каждое изображение в плоскую структуру с формой (seq_len, patch_dim), чтобы можно было объединять пиксели с динамической формой.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.glm5_next.image_processing_glm5_next.Glm5NextImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Параметры
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Изображение для предобработки. Ожидается одно изображение или батч изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установитеdo_rescale=False. - do_convert_rgb (
bool, kwargs, optional) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional) — Указывает, нужно ли изменить размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Описывает максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size является целым числом. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional) — Нужно ли перемасштабировать изображение. - rescale_factor (
float, kwargs, optional) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional) — Нужно ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора. - patch_size (
int, kwargs, optional, по умолчанию 14) — Пространственный размер патча в визуальном энкодере. - temporal_patch_size (
int, kwargs, optional, по умолчанию 2) — Размер временного патча в визуальном энкодере. - merge_size (
int, kwargs, optional, по умолчанию 2) — Размер слияния (merge size) для визуального энкодера и энкодера LLM. - patch_expand_factor (
int, kwargs, optional, по умолчанию 1) — Коэффициент расширения патчей (patch_expand_factor) для перехода от визуального энкодера к энкодеру LLM. - min_image_tokens (
int, kwargs) — Минимальное количество токенов на изображение. - max_image_tokens (
int, kwargs) — Максимальное количество токенов на изображение.
Возвращает
~image_processing_base.BatchFeature
- data (
dict) — Словарь списков/массивов/тензоров, возвращаемый методом call (‘pixel_values’ и т. д.). - tensor_type (
Union[None, str, TensorType], необязательный) — Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
resize
< source >( images: torch.Tensorresample: PILImageResampling | tvF.InterpolationMode | int | Nonefactor: inttemporal_factor: intmin_image_tokens: intmax_image_tokens: int**kwargs )
Масштабирование динамически на основе соотношения сторон входного изображения.
Glm5NextImageProcessorPil
класс transformers.Glm5NextImageProcessorPil
< source >( **kwargs: *<class 'transformers.processing_utils.ImagesKwargs'> )
Параметры
- do_convert_rgb (
bool, kwargs, optional, по умолчаниюTrue) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, нужно ли изменять размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs, по умолчанию{'longest_edge' -- 1}): Определяет максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional, по умолчаниюFalse) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size задано как int. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs, по умолчанию3) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли выполнять рескейлинг изображения. - rescale_factor (
float, kwargs, optional, по умолчанию0.00392156862745098) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional, по умолчаниюTrue) — Указывает, следует ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.48145466, 0.4578275, 0.40821073]) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional, по умолчанию[0.26862954, 0.26130258, 0.27577711]) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, однако в будущих моделях это значение следует задавать как атрибут процессора. Если установлено в'pt', возвращает стопку тензоров, иначе — список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора. - Returns stacked tensors if set to
'pt', otherwise returns a list of tensors. —
Создаёт процессор изображений Glm5NextImageProcessor.
disable_grouping (bool, kwargs, optional):
Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками.
Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на
эмпирических наблюдениях, подробно описанных здесь: https://github.com/huggingface/transformers/pull/38157 image_seq_length (int, kwargs, optional):
Количество токенов изображения, используемых для каждого изображения во входных данных.
Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора.
get_number_of_image_patches
< source >( height: intwidth: intimages_kwargs: dict | None = None ) → int
Утилита, возвращающая количество патчей изображения для заданного размера изображения.
Преобразует каждое изображение в плоскую структуру с формой (seq_len, patch_dim), чтобы можно было объединять пиксели с динамической формой.
preprocess
< source >( images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']]**kwargs: *<class 'transformers.models.glm5_next.image_processing_pil_glm5_next.Glm5NextImageProcessorKwargs'> ) → ~image_processing_base.BatchFeature
Параметры
- images (
Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]) — Изображение для предобработки. Ожидается одно изображение или батч изображений со значениями пикселей в диапазоне от 0 до 255. Если передаются изображения со значениями пикселей в диапазоне от 0 до 1, установитеdo_rescale=False. - do_convert_rgb (
bool, kwargs, optional) — Следует ли преобразовать изображение в RGB. - do_resize (
bool, kwargs, optional) — Указывает, нужно ли изменить размер изображения. - size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Описывает максимальные размеры входных данных для модели. - default_to_square (
bool, kwargs, optional) — Определяет, следует ли по умолчанию использовать квадратное изображение при изменении размера, если size является целым числом. - crop_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер выходного изображения после примененияcenter_crop. - resample (
Annotated[Union[int, PILImageResampling, NoneType], None], kwargs) — Фильтр ресемплинга, используемый при изменении размера изображения. Может быть одним из значений перечисленияPILImageResampling. Влияет только в том случае, еслиdo_resizeустановлено вTrue. - do_rescale (
bool, kwargs, optional) — Нужно ли перемасштабировать изображение. - rescale_factor (
float, kwargs, optional) — Коэффициент масштабирования, применяемый к изображению, еслиdo_rescaleустановлен вTrue. - do_normalize (
bool, kwargs, optional) — Нужно ли нормализовать изображение. - image_mean (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Среднее значение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - image_std (
Union[float, list[float], tuple[float, ...]], kwargs, optional) — Стандартное отклонение изображения, используемое для нормализации. Влияет только в том случае, еслиdo_normalizeустановлено вTrue. - do_pad (
bool, kwargs, optional) — Определяет, нужно ли выравнивать изображение. Выравнивание выполняется либо до максимального размера в батче, либо до фиксированного квадратного размера для каждого изображения. Точная стратегия выравнивания зависит от модели. - pad_size (
Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None], kwargs) — Размер в формате{"height": int, "width" int}, до которого следует дополнить изображения. Должен быть больше любого размера изображения, предоставленного для предобработки. Еслиpad_sizeне указан, изображения будут дополнены до наибольшей высоты и ширины в батче. Применяется только приdo_pad=True. - do_center_crop (
bool, kwargs, optional) — Выполнять ли центрированную обрезку изображения. - data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, optional) — Поддерживается толькоChannelDimension.FIRST. Добавлено для совместимости с медленными процессорами. - input_data_format (
Union[str, ~image_utils.ChannelDimension], kwargs, необязательный) — Формат размерности каналов для входного изображения. Если не задан, формат размерности каналов выводится из входного изображения. Может быть одним из:"channels_first"илиChannelDimension.FIRST: изображение в формате (num_channels, height, width)."channels_last"илиChannelDimension.LAST: изображение в формате (высота, ширина, число каналов)."none"илиChannelDimension.NONE: изображение в формате (height, width).
- device (
Annotated[Union[str, torch.device, NoneType], None], kwargs) — Устройство, на котором будут обрабатываться видео. Если не задано, устройство определяется на основе входных видео. - return_tensors (
Annotated[str | ~utils.generic.TensorType | None, None], kwargs) — Возвращает стопку тензоров, если установлено значение'pt', иначе возвращает список тензоров. - disable_grouping (
bool, kwargs, optional) — Определяет, следует ли отключить группировку изображений по размеру для их индивидуальной обработки, а не пачками. Если значение равно None, оно будет установлено в True, если изображения находятся на CPU, и в False в противном случае. Этот выбор основан на эмпирических наблюдениях, описанных здесь: https://github.com/huggingface/transformers/pull/38157 - image_seq_length (
int, kwargs, optional) — Количество токенов изображения, используемых для каждого изображения во входных данных. Добавлено для обратной совместимости, но в будущих моделях это значение следует задавать как атрибут процессора. - patch_size (
int, kwargs, optional, по умолчанию 14) — Пространственный размер патча в визуальном энкодере. - temporal_patch_size (
int, kwargs, optional, по умолчанию 2) — Размер временного патча в визуальном энкодере. - merge_size (
int, kwargs, optional, по умолчанию 2) — Размер слияния (merge size) для визуального энкодера и энкодера LLM. - patch_expand_factor (
int, kwargs, optional, по умолчанию 1) — Коэффициент расширения патчей (patch_expand_factor) для перехода от визуального энкодера к энкодеру LLM. - min_image_tokens (
int, kwargs) — Минимальное количество токенов на изображение. - max_image_tokens (
int, kwargs) — Максимальное количество токенов на изображение.
Возвращает
~image_processing_base.BatchFeature
- data (
dict) — Словарь списков/массивов/тензоров, возвращаемый методом call (‘pixel_values’ и т. д.). - tensor_type (
Union[None, str, TensorType], необязательный) — Здесь можно указать tensor_type, чтобы при инициализации преобразовать списки целых чисел в тензоры PyTorch/Numpy.
resize
< source >( image: ndarrayresample: PILImageResampling | int | Nonefactor: inttemporal_factor: intmin_image_tokens: intmax_image_tokens: int**kwargs )
Масштабирование динамически на основе соотношения сторон входного изображения.
Glm5NextVideoProcessor
класс transformers.Glm5NextVideoProcessor
< source >( **kwargs: *<class 'transformers.models.glm5_next.video_processing_glm5_next.Glm5NextVideoProcessorInitKwargs'> )
Создает видео-процессор Glm5NextVideoProcessor.
get_num_of_video_patches
< source >( num_frames: intheight: intwidth: intvideos_kwargs = None ) → int
Параметры
- num_frames (
int) — Количество кадров во входном видео. - height (
int) — Высота входного видео. - width (
int) — Ширина входного видео. - videos_kwargs (
dict, необязательный) — Любые kwargs для переопределения значений по умолчанию в видео-процессоре.
Возвращает
int
Количество видеопатчей на видео.
Утилита, возвращающая количество видеопатчей для заданного размера видео.
Преобразует каждое видео в плоскую структуру с формой (seq_len, patch_dim), чтобы можно было объединять пиксели с динамической формой.
resize
< source >( videos: torch.Tensorresample: PILImageResampling | tvF.InterpolationMode | int | Nonefactor: inttemporal_factor: intmin_image_tokens: intmax_image_tokens: int**kwargs )
Динамически изменять размер в зависимости от соотношения сторон входного видео.
sample_frames
< source >( metadata: VideoMetadatafps: int | float | None = None**kwargs ) → np.ndarray
Параметры
- metadata (
VideoMetadata) — Метаданные видео, содержащие информацию о общей длительности, частоте кадров (fps) и общем количестве кадров. - fps (
intилиfloat, необязательный) — Целевое количество кадров для выборки в секунду. По умолчаниюself.fps.
Возвращает
np.ndarray
Индексы для выборки кадров видео.