
Transformers documentation
FastSpeech2Conformer
이 모델은 2020-10-26에 HF papers에 게시되었으며, 2024-01-03에 Hugging Face Transformers에 기여되었습니다.
FastSpeech2Conformer
개요
FastSpeech2Conformer 모델은 Pengcheng Guo, Florian Boyer, Xuankai Chang, Tomoki Hayashi, Yosuke Higuchi, Hirofumi Inaguma, Naoyuki Kamo, Chenda Li, Daniel Garcia-Romero, Jiatong Shi, Jing Shi, Shinji Watanabe, Kun Wei, Wangyou Zhang, Yuekai Zhang가 발표한 Recent Developments On Espnet Toolkit Boosted By Conformer 논문에서 제안되었습니다.
원본 FastSpeech2 논문의 초록은 다음과 같습니다:
FastSpeech(Ren et al., 2019)와 같은 비자기회귀(non-autoregressive) 텍스트 음성 변환(TTS) 모델은 이전의 자기회귀 모델과 동등한 품질을 유지하면서 훨씬 더 빠르게 음성을 합성할 수 있습니다. FastSpeech 모델의 학습은 지속 시간 예측(입력으로 더 많은 정보를 제공하기 위해)과 지식 증류(출력에서 데이터 분포를 단순화하기 위해)를 위해 자기회귀 교사 모델을 의존하며, 이를 통해 TTS의 1대 다수 매핑 문제(즉, 동일한 텍스트에 여러 음성 변이가 대응하는 문제)를 완화할 수 있습니다. 그러나 FastSpeech에는 몇 가지 단점이 있습니다. 1) 교사-학생 증류 파이프라인이 복잡하고 시간이 많이 소요되며, 2) 교사 모델에서 추출된 지속 시간이 충분히 정확하지 않고, 교사 모델에서 증류된 대상 멜 스펙트로그램은 데이터 단순화로 인해 정보 손실을 겪어, 이 두 가지 모두 음성 품질을 제한합니다. 본 논문에서는 FastSpeech 2를 제안하며, 이는 1) 단순화된 교사 출력 대신 ground-truth target으로 모델을 직접 학습시키고, 2) 음성의 더 많은 변이 정보(예: 피치, 에너지 및 더 정확한 지속 시간)를 조건 입력으로 도입함으로써 FastSpeech의 문제를 해결하고 TTS의 1대 다수 매핑 문제를 더 잘 해결합니다. 구체적으로, 우리는 음성 웨이브폼에서 지속 시간, 피치, 에너지를 추출하여 학습 시 이를 조건 입력으로 직접 사용하고, 추론 시에는 예측된 값을 사용합니다. 또한, 우리는 텍스트에서 음성 웨이브폼을 병렬로 직접 생성하는 최초의 시도인 FastSpeech 2s를 설계하여, 완전한 end-to-end 추론의 이점을 누립니다. 실험 결과는 1) FastSpeech 2가 FastSpeech 대비 3배의 학습 속도 향상을 달성하고, FastSpeech 2s는 더 빠른 추론 속도를 누린다는 것, 2) FastSpeech 2와 2s가 음성 품질에서 FastSpeech보다 우수하며, FastSpeech 2는 심지어 자기회귀 모델보다도 우수하다는 것을 보여줍니다. 오디오 샘플은 https://speechresearch.github.io/fastspeech2/에서 확인할 수 있습니다.
이 모델은 Connor Henderson님이 기여했습니다. 원본 코드는 여기에서 찾을 수 있습니다.
🤗 모델 아키텍처
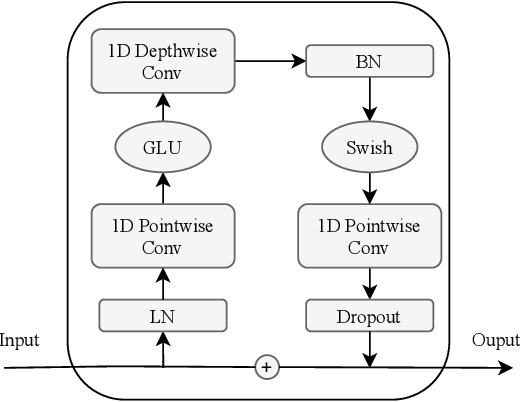
FastSpeech2의 Mel-spectrogram 디코더를 포함한 일반적인 구조를 구현하고, ESPnet 라이브러리에서 수행한 것처럼 기존 transformer 블록을 conformer 블록으로 대체했습니다.
FastSpeech2 모델 아키텍처

Conformer 블록

컨볼루션 모듈
🤗 Transformers 사용
🤗 Transformers 라이브러리를 사용하여 FastSpeech2Conformer를 로컬에서 실행할 수 있습니다.
- 먼저 🤗 Transformers 라이브러리와 g2p-en을 설치하세요:
pip install --upgrade pip
pip install --upgrade transformers g2p-en
- Transformers 모델링 코드를 사용하여 모델과 hifigan을 각각 실행하여 추론을 수행합니다
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerModel, FastSpeech2ConformerTokenizer


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer", device_map="auto")
output_dict = model(input_ids, return_dict=True)
spectrogram = output_dict["spectrogram"]

hifigan = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
waveform = hifigan(spectrogram)

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- Transformers 모델링 코드를 사용하여 모델과 hifigan을 결합하여 추론을 실행합니다
import soundfile as sf

from transformers import FastSpeech2ConformerTokenizer, FastSpeech2ConformerWithHifiGan


tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
inputs = tokenizer("Hello, my dog is cute.", return_tensors="pt").to(model.device)
input_ids = inputs["input_ids"]

model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
output_dict = model(input_ids, return_dict=True)
waveform = output_dict["waveform"]

sf.write("speech.wav", waveform.squeeze().detach().numpy(), samplerate=22050)- pipeline로 추론을 실행하고 사용할 vocoder를 지정합니다
import soundfile as sf

from transformers import FastSpeech2ConformerHifiGan, pipeline


vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
synthesiser = pipeline(model="espnet/fastspeech2_conformer", vocoder=vocoder)

speech = synthesiser("Hello, my dog is cooler than you!")

sf.write("speech.wav", speech["audio"].squeeze(), samplerate=speech["sampling_rate"])
FastSpeech2ConformerConfig
클래스 transformers.FastSpeech2ConformerConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0id2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Noneis_encoder_decoder: bool = Truehidden_size: int = 384vocab_size: int = 78num_mel_bins: int = 80encoder_num_attention_heads: int = 2encoder_layers: int = 4encoder_linear_units: int = 1536decoder_layers: int = 4decoder_num_attention_heads: int = 2decoder_linear_units: int = 1536speech_decoder_postnet_layers: int = 5speech_decoder_postnet_units: int = 256speech_decoder_postnet_kernel: int = 5positionwise_conv_kernel_size: int = 3encoder_normalize_before: bool = Falsedecoder_normalize_before: bool = Falseencoder_concat_after: bool = Falsedecoder_concat_after: bool = Falsereduction_factor: int = 1speaking_speed: float = 1.0use_macaron_style_in_conformer: bool = Trueuse_cnn_in_conformer: bool = Trueencoder_kernel_size: int = 7decoder_kernel_size: int = 31duration_predictor_layers: int = 2duration_predictor_channels: int = 256duration_predictor_kernel_size: int = 3energy_predictor_layers: int = 2energy_predictor_channels: int = 256energy_predictor_kernel_size: int = 3energy_predictor_dropout: float | int = 0.5energy_embed_kernel_size: int = 1energy_embed_dropout: float | int = 0.0stop_gradient_from_energy_predictor: bool = Falsepitch_predictor_layers: int = 5pitch_predictor_channels: int = 256pitch_predictor_kernel_size: int = 5pitch_predictor_dropout: float | int = 0.5pitch_embed_kernel_size: int = 1pitch_embed_dropout: float | int = 0.0stop_gradient_from_pitch_predictor: bool = Trueencoder_dropout_rate: float | int = 0.2encoder_positional_dropout_rate: float | int = 0.2encoder_attention_dropout_rate: float | int = 0.2decoder_dropout_rate: float | int = 0.2decoder_positional_dropout_rate: float | int = 0.2decoder_attention_dropout_rate: float | int = 0.2duration_predictor_dropout_rate: float | int = 0.2speech_decoder_postnet_dropout: float | int = 0.5max_source_positions: int = 5000use_masking: bool = Trueuse_weighted_masking: bool = Falsenum_speakers: int | None = Nonenum_languages: int | None = Nonespeaker_embed_dim: int | None = Noneconvolution_bias: bool = True )
매개변수
- is_encoder_decoder (
bool, 선택 사항, 기본값True) — 모델이 인코더/디코더로 사용되는지 여부를 나타냅니다. - hidden_size (
int, 선택 사항, 기본값384) — 숨겨진 표현의 차원입니다. - vocab_size (
int, 선택 사항, 기본값78) — 모델의 어휘 크기입니다.input_ids로 표현할 수 있는 서로 다른 토큰의 수를 정의합니다. - num_mel_bins (
int, 선택 사항, 기본값80) — 입력 프레임당 사용되는 mel 특징의 수입니다.AutoFeatureExtractor클래스에서 사용된 값과 일치해야 합니다. - encoder_num_attention_heads (
int, 선택 사항, 기본값 2) — 인코더의 어텐션 헤드 수입니다. - encoder_layers (
int, 선택 사항, 기본값4) — Transformer 인코더의 숨겨진 레이어 수입니다. 설정하지 않으면num_layers와 동일한 값을 사용합니다. - encoder_linear_units (
int, 선택 사항, 기본값 1536) — 인코더의 선형 레이어에 있는 유닛 수입니다. - decoder_layers (
int, 선택 사항, 기본값4) — Transformer decoder의 숨겨진 레이어 수입니다. 설정하지 않으면num_layers와 동일한 값을 사용합니다. - decoder_num_attention_heads (
int, 선택 사항, 기본값2) — Transformer decoder의 각 attention layer에 사용할 attention head 수입니다. - decoder_linear_units (
int, 선택 사항, 기본값 1536) — 디코더의 선형 레이어에 포함된 유닛 수입니다. - speech_decoder_postnet_layers (
int, 선택 사항, 기본값 5) — 음성 디코더의 post-net 레이어 수입니다. - speech_decoder_postnet_units (
int, 선택 사항, 기본값 256) — 음성 디코더의 post-net 레이어에 있는 유닛 수입니다. - speech_decoder_postnet_kernel (
int, 선택 사항, 기본값 5) — 음성 디코더의 post-net에서 사용되는 커널 크기입니다. - positionwise_conv_kernel_size (
int, 선택 사항, 기본값 3) — 위치별 레이어에서 사용되는 컨볼루션 커널의 크기입니다. - encoder_normalize_before (
bool, 선택 사항, 기본값False) — 인코더 레이어를 적용하기 전에 정규화를 수행할지 여부를 지정합니다. - decoder_normalize_before (
bool, 선택 사항, 기본값False) — decoder 레이어를 적용하기 전에 정규화를 수행할지 여부를 지정합니다. - encoder_concat_after (
bool, 선택 사항, 기본값False) — 인코더 레이어 이후에 연결할지 여부를 지정합니다. - decoder_concat_after (
bool, 선택 사항, 기본값False) — decoder 레이어 이후에 연결할지 여부를 지정합니다. - reduction_factor (
int, 선택 사항, 기본값 1) — 음성 프레임 레이트를 줄이는 배율입니다. - speaking_speed (
float, 선택 사항, 기본값 1.0) — 생성되는 음성 속도를 지정합니다. - use_macaron_style_in_conformer (
bool, 선택 사항, 기본값True) — conformer에서 macaron 스타일을 사용할지 여부를 지정합니다. - use_cnn_in_conformer (
bool, 선택 사항, 기본값True) — conformer에서 합성곱 신경망을 사용할지 여부를 지정합니다. - encoder_kernel_size (
int, 선택 사항, 기본값 7) — 인코더에서 사용되는 커널 크기입니다. - decoder_kernel_size (
int, 선택 사항, 기본값 31) — 디코더에서 사용되는 커널 크기입니다. - duration_predictor_layers (
int, 선택 사항, 기본값 2) — duration predictor의 레이어 수입니다. - duration_predictor_channels (
int, 선택 사항, 기본값 256) — duration predictor의 채널 수입니다. - duration_predictor_kernel_size (
int, 선택 사항, 기본값 3) — duration predictor에서 사용되는 커널 크기입니다. - energy_predictor_layers (
int, 선택 사항, 기본값 2) — 에너지 예측기의 레이어 수입니다. - energy_predictor_channels (
int, 선택 사항, 기본값 256) — 에너지 예측기의 채널 수입니다. - energy_predictor_kernel_size (
int, 선택 사항, 기본값 3) — 에너지 예측기에 사용되는 커널 크기입니다. - energy_predictor_dropout (
float, 선택 사항, 기본값 0.5) — 에너지 예측기에서 사용할 dropout 비율입니다. - energy_embed_kernel_size (
int, 선택 사항, 기본값 1) — energy embed 레이어에서 사용되는 커널 크기입니다. - energy_embed_dropout (
float, 선택 사항, 기본값 0.0) — energy embed 레이어의 dropout rate입니다. - stop_gradient_from_energy_predictor (
bool, 선택 사항, 기본값False) — 에너지 예측기로부터의 그래디언트를 중단할지 여부를 지정합니다. - pitch_predictor_layers (
int, 선택 사항, 기본값 5) — 피치 예측기의 레이어 수입니다. - pitch_predictor_channels (
int, 선택 사항, 기본값 256) — pitch predictor의 채널 수입니다. - pitch_predictor_kernel_size (
int, 선택 사항, 기본값 5) — 피치 예측기에 사용되는 커널 크기입니다. - pitch_predictor_dropout (
float, 선택 사항, 기본값 0.5) — 피치 예측기에서 사용할 dropout 비율입니다. - pitch_embed_kernel_size (
int, 선택 사항, 기본값 1) — pitch embed 레이어에서 사용되는 커널 크기입니다. - pitch_embed_dropout (
float, 선택 사항, 기본값 0.0) — 피치 임베드 레이어의 드롭아웃 비율입니다. - stop_gradient_from_pitch_predictor (
bool, 선택 사항, 기본값True) — pitch predictor에서 그래디언트를 차단할지 여부를 지정합니다. - encoder_dropout_rate (
float, 선택 사항, 기본값 0.2) — 인코더의 dropout rate입니다. - encoder_positional_dropout_rate (
float, 선택 사항, 기본값 0.2) — 인코더의 위치 dropout 비율입니다. - encoder_attention_dropout_rate (
float, 선택 사항, 기본값 0.2) — 인코더의 어텐션 드롭아웃 비율입니다. - decoder_dropout_rate (
float, 선택 사항, 기본값 0.2) — 디코더의 dropout rate입니다. - decoder_positional_dropout_rate (
float, 선택 사항, 기본값 0.2) — 디코더의 위치 dropout 비율입니다. - decoder_attention_dropout_rate (
float, 선택 사항, 기본값 0.2) — 디코더의 어텐션 드롭아웃 비율입니다. - duration_predictor_dropout_rate (
float, 선택 사항, 기본값 0.2) — duration predictor의 dropout rate입니다. - speech_decoder_postnet_dropout (
float, 선택 사항, 기본값 0.5) — 음성 디코더 postnet의 dropout 비율입니다. - max_source_positions (
int, 선택 사항, 기본값 5000) —"relative"위치 임베딩을 사용하는 경우, 최대 소스 입력 위치를 정의합니다. - use_masking (
bool, 선택 사항, 기본값True) — 모델에서 마스킹을 사용할지 여부를 지정합니다. - use_weighted_masking (
bool, 선택 사항, 기본값False) — 모델에서 가중치 마스킹을 사용할지 여부를 지정합니다. - num_speakers (
int, 선택) — 화자 수입니다. 1보다 큰 값으로 설정하면, 화자 ID가 입력으로 제공된다고 가정하고 화자 ID 임베딩 레이어를 사용합니다. - num_languages (
int, 선택 사항) — 언어의 수입니다. 1보다 큰 값으로 설정하면 언어 ID가 입력으로 제공된다고 가정하고 언어 ID 임베딩 레이어를 사용합니다. - speaker_embed_dim (
int, 선택) — Speaker embedding의 차원입니다. 0보다 큰 값으로 설정하면, speaker_embedding이 입력으로 제공된다고 가정합니다. - convolution_bias (
bool, 선택 사항, 기본값True) — conformer의 convolution module에서 convolution에 bias를 사용할지 여부를 지정합니다.
이것은 FastSpeech2ConformerModel의 설정을 저장하기 위한 설정 클래스입니다. 지정된 인자에 따라 Fastspeech2 Conformer 모델을 인스턴스화하고 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 설정을 인스턴스화하면 espnet/fastspeech2_conformer와 유사한 설정이 생성됩니다.
Configuration 객체는 PreTrainedConfig를 상속하며 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 PreTrainedConfig의 문서를 참고하세요.
예:
>>> from transformers import FastSpeech2ConformerModel, FastSpeech2ConformerConfig

>>> # Initializing a FastSpeech2Conformer style configuration
>>> configuration = FastSpeech2ConformerConfig()

>>> # Initializing a model from the FastSpeech2Conformer style configuration
>>> model = FastSpeech2ConformerModel(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerHifiGanConfig
클래스 transformers.FastSpeech2ConformerHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_in_dim: int = 80upsample_initial_channel: int = 512upsample_rates: list[int] | tuple[int, ...] = (8, 8, 2, 2)upsample_kernel_sizes: list[int] | tuple[int, ...] = (16, 16, 4, 4)resblock_kernel_sizes: list[int] | tuple[int, ...] = (3, 7, 11)resblock_dilation_sizes: list | tuple | None = Noneinitializer_range: float = 0.01leaky_relu_slope: float = 0.1normalize_before: bool = True )
매개변수
- model_in_dim (
int, 선택 사항, 기본값 80) — 입력 log-mel spectrogram의 주파수 빈(bin) 수입니다. - upsample_initial_channel (
int, 선택 사항, 기본값 512) — 업샘플링 네트워크의 입력 채널 수입니다. - upsample_rates (
tuple[int]또는list[int], 선택 사항, 기본값[8, 8, 2, 2]) — 업샘플링 네트워크의 각 1D 합성곱 계층의 스트라이드를 정의하는 정수 튜플입니다. upsample_rates의 길이는 합성곱 계층의 수를 정의하며, upsample_kernel_sizes의 길이와 일치해야 합니다. - upsample_kernel_sizes (
tuple[int]또는list[int], 선택 사항, 기본값[16, 16, 4, 4]) — 업샘플링 네트워크의 각 1D 컨볼루션 레이어의 커널 크기를 정의하는 정수 튜플입니다. upsample_kernel_sizes의 길이는 컨볼루션 레이어의 수를 정의하며, upsample_rates의 길이와 일치해야 합니다. - resblock_kernel_sizes (
tuple[int]또는list[int], 선택 사항, 기본값[3, 7, 11]) — 멀티 리셉티브 필드 퓨전(MRF) 모듈 내 1D 컨볼루션 레이어의 커널 크기를 정의하는 정수 튜플입니다. - resblock_dilation_sizes (
tuple[tuple[int]]또는list[list[int]], 선택 사항, 기본값[[1, 3, 5], [1, 3, 5], [1, 3, 5]]) — 멀티 리셉티브 필드 퓨전(MRF) 모듈 내의 확장 1D 합성곱 계층의 확장 비율(dilation rate)을 정의하는 정수의 중첩 튜플입니다. - initializer_range (
float, 선택 사항, 기본값0.01) — 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다. - leaky_relu_slope (
float, 선택 사항, 기본값 0.1) — leaky ReLU 활성화 함수에서 사용되는 음의 기울기의 각도입니다. - normalize_before (
bool, 선택 사항, 기본값True) — vocoder의 학습된 평균과 분산을 사용하여 vocoding 전에 스펙트로그램을 정규화할지 여부입니다.
이것은 FastSpeech2ConformerModel의 설정을 저장하기 위한 설정 클래스입니다. 지정된 인자에 따라 Fastspeech2 Conformer 모델을 인스턴스화하고 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 설정을 인스턴스화하면 espnet/fastspeech2_conformer_with_hifigan의 설정과 유사한 설정이 생성됩니다.
Configuration 객체는 PreTrainedConfig를 상속하며 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 PreTrainedConfig의 문서를 참고하세요.
예:
>>> from transformers import FastSpeech2ConformerHifiGan, FastSpeech2ConformerHifiGanConfig

>>> # Initializing a FastSpeech2ConformerHifiGan configuration
>>> configuration = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a model (with random weights) from the configuration
>>> model = FastSpeech2ConformerHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerWithHifiGanConfig
클래스 transformers.FastSpeech2ConformerWithHifiGanConfig
< source >( transformers_version: str | None = Nonearchitectures: list[str] | None = Noneoutput_hidden_states: bool | None = Falsereturn_dict: bool | None = Truedtype: str | torch.dtype | None = Nonechunk_size_feed_forward: int = 0is_encoder_decoder: bool = Falseid2label: dict[int, str] | dict[str, str] | None = Nonelabel2id: dict[str, int] | dict[str, str] | None = Noneproblem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = Nonemodel_config: dict | transformers.configuration_utils.PreTrainedConfig | None = Nonevocoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None )
이것은 FastSpeech2ConformerModel의 설정을 저장하기 위한 설정 클래스입니다. 지정된 인자에 따라 Fastspeech2 Conformer 모델을 인스턴스화하고 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 설정을 인스턴스화하면 espnet/fastspeech2_conformer_with_hifigan의 설정과 유사한 설정이 생성됩니다.
Configuration 객체는 PreTrainedConfig를 상속하며 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 PreTrainedConfig의 문서를 참고하세요.
예:
>>> from transformers import (
...     FastSpeech2ConformerConfig,
...     FastSpeech2ConformerHifiGanConfig,
...     FastSpeech2ConformerWithHifiGanConfig,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> # Initializing FastSpeech2ConformerWithHifiGan sub-modules configurations.
>>> model_config = FastSpeech2ConformerConfig()
>>> vocoder_config = FastSpeech2ConformerHifiGanConfig()

>>> # Initializing a FastSpeech2ConformerWithHifiGan module style configuration
>>> configuration = FastSpeech2ConformerWithHifiGanConfig(model_config.to_dict(), vocoder_config.to_dict())

>>> # Initializing a model (with random weights)
>>> model = FastSpeech2ConformerWithHifiGan(configuration)

>>> # Accessing the model configuration
>>> configuration = model.config
FastSpeech2ConformerTokenizer
class transformers.FastSpeech2ConformerTokenizer
< source >( vocab_filebos_token = '<sos/eos>'eos_token = '<sos/eos>'pad_token = '<blank>'unk_token = '<unk>'should_strip_spaces = False**kwargs )
매개변수
- vocab_file (
str) — 어휘 파일의 경로입니다. - bos_token (
str, 선택 사항, 기본값"<sos/eos>") — 시퀀스 시작 토큰입니다. FastSpeech2의 경우eos_token과 동일합니다. - eos_token (
str, 선택 사항, 기본값"<sos/eos>") — 시퀀스 종료 토큰입니다. FastSpeech2의 경우bos_token과 동일합니다. - pad_token (
str, 선택 사항, 기본값"<blank>") — 패딩에 사용되는 토큰입니다. 예를 들어, 길이가 다른 시퀀스를 배치(batching)할 때 사용됩니다. - unk_token (
str, 선택 사항, 기본값"<unk>") — 미지의 토큰입니다. 어휘에 없는 토큰은 ID로 변환할 수 없으므로, 대신 이 토큰으로 설정됩니다. - should_strip_spaces (
bool, 선택 사항, 기본값False) — 토큰 목록에서 공백을 제거할지 여부.
FastSpeech2Conformer 토크나이저를 구성합니다.
__call__
< source >( text: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Nonetext_pair_target: TextInput | PreTokenizedInput | list[TextInput] | list[PreTokenizedInput] | None = Noneadd_special_tokens: bool = Truepadding: bool | str | PaddingStrategy = Falsetruncation: bool | str | TruncationStrategy | None = Nonemax_length: int | None = Nonestride: int = 0is_split_into_words: bool = Falsepad_to_multiple_of: int | None = Nonepadding_side: str | None = Nonereturn_tensors: str | TensorType | None = Nonereturn_token_type_ids: bool | None = Nonereturn_attention_mask: bool | None = Nonereturn_overflowing_tokens: bool = Falsereturn_special_tokens_mask: bool = Falsereturn_offsets_mapping: bool = Falsereturn_length: bool = Falseverbose: bool = Truetokenizer_kwargs: dict[str, Any] | None = None**kwargs ) → BatchEncoding
매개변수
- text (
str,list[str],list[list[str]], 선택 사항) — 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 시퀀스가 문자열 목록(사전 토큰화)로 제공되는 경우,is_split_into_words=True를 설정해야 합니다(시퀀스 배치와의 모호성을 제거하기 위함). - text_pair (
str,list[str],list[list[str]], 선택 사항) — 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 시퀀스가 문자열 목록(사전 토큰화)로 제공되는 경우,is_split_into_words=True를 설정해야 합니다(시퀀스 배치와의 모호성을 제거하기 위함). - text_target (
str,list[str],list[list[str]], 선택 사항) — 타겟 텍스트로 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 시퀀스가 문자열 목록(사전 토큰화)로 제공되는 경우,is_split_into_words=True를 설정해야 합니다(시퀀스 배치와의 모호성을 제거하기 위함). - text_pair_target (
str,list[str],list[list[str]], 선택 사항) — 타겟 텍스트로 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 시퀀스가 문자열 목록(사전 토큰화)로 제공되는 경우,is_split_into_words=True를 설정해야 합니다(시퀀스 배치와의 모호성을 제거하기 위해). - tokenizer_kwargs (
dict[str, Any], 선택) — 토크나이저에 전달할 추가 kwargs입니다. 이들은 명시적 매개변수 및 기타 kwargs와 병합되며, 명시적 매개변수가 우선합니다. - add_special_tokens (
bool, 선택 사항, 기본값True) — 시퀀스를 인코딩할 때 특수 토큰을 추가할지 여부입니다. 이는 입력 ID에 자동으로 추가되는 토큰을 정의하는 기반 함수인PretrainedTokenizerBase.build_inputs_with_special_tokens를 사용합니다.bos또는eos토큰을 자동으로 추가하려는 경우 유용합니다. - padding (
bool,str또는 PaddingStrategy, 선택 사항, 기본값은False) — 패딩을 활성화하고 제어합니다. 다음 값을 허용합니다:True또는'longest': 배치 내 가장 긴 시퀀스 길이에 맞게 패딩을 수행합니다(단일 시퀀스만 제공된 경우 패딩을 하지 않음).'max_length':max_length인수로 지정된 최대 길이로 패딩하거나, 해당 인수가 제공되지 않으면 모델이 허용하는 최대 입력 길이로 패딩합니다.False또는'do_not_pad'(기본값): 패딩을 하지 않습니다(즉, 서로 다른 길이의 시퀀스로 구성된 배치로 출력할 수 있습니다).
- truncation (
bool,str또는 TruncationStrategy, 선택 사항, 기본값은False) — 잘림을 활성화하고 제어합니다. 다음 값을 허용합니다:True또는'longest_first':max_length인수로 지정된 최대 길이로 잘라내거나, 해당 인수가 제공되지 않으면 모델이 허용하는 최대 입력 길이로 잘라냅니다. 이 경우 토큰 단위로 잘라내며, 시퀀스 쌍(또는 쌍의 배치)이 제공되면 쌍 중 가장 긴 시퀀스에서 토큰을 하나씩 제거합니다.'only_first':max_length인수로 지정된 최대 길이 또는 해당 인수가 제공되지 않은 경우 모델이 허용하는 최대 입력 길이로 잘립니다. 이 옵션은 시퀀스 쌍(또는 쌍의 배치)이 제공된 경우 쌍의 첫 번째 시퀀스만 잘립니다.'only_second':max_length인수로 지정된 최대 길이로 잘라내거나, 해당 인수가 제공되지 않은 경우 모델이 허용하는 최대 입력 길이로 잘라냅니다. 이 옵션은 시퀀스 쌍(또는 쌍의 배치)이 제공된 경우에만 쌍의 두 번째 시퀀스를 잘라냅니다.False또는'do_not_truncate'(기본값): 잘라내기 없음 (즉, 모델이 허용하는 최대 입력 크기보다 긴 시퀀스 길이를 가진 배치 출력 가능).
- max_length (
int, 선택 사항) — truncation/padding 파라미터 중 하나가 사용할 최대 길이를 제어합니다.설정하지 않거나
None으로 설정하면, truncation/padding 파라미터 중 하나가 최대 길이를 요구할 경우 미리 정의된 모델 최대 길이를 사용합니다. 모델에 특정 최대 입력 길이가 없는 경우(XLNet 등) 최대 길이로 truncation/padding하는 기능이 비활성화됩니다. - stride (
int, 선택 사항, 기본값 0) —max_length와 함께 숫자로 설정하면,return_overflowing_tokens=True일 때 반환되는 오버플로 토큰에는 잘린 시퀀스의 끝부분에서 가져온 일부 토큰이 포함됩니다. 이를 통해 잘린 시퀀스와 오버플로 시퀀스 사이에 일부 중복이 생깁니다. 이 인수의 값은 중복되는 토큰의 수를 정의합니다. - is_split_into_words (
bool, 선택 사항, 기본값False) — 입력이 이미 사전 토큰화(예: 단어 단위로 분리)되었는지 여부입니다.True로 설정하면 토크나이저는 입력이 이미 단어 단위로 분리되어 있다고 가정하고(예: 공백 기준으로 분리) 이를 토큰화합니다. 이는 NER 또는 토큰 분류에 유용합니다. - pad_to_multiple_of (
int, 선택 사항) — 설정하면 시퀀스를 제공된 값의 배수로 패딩합니다.padding이 활성화되어 있어야 합니다. 이는 Volta에서>= 7.5의 컴퓨트 기능을 가진 NVIDIA 하드웨어에서 Tensor Cores 사용을 활성화하는 데 특히 유용합니다. - padding_side (
str, 선택 사항) — 모델에 패딩을 적용할 쪽입니다. [‘right’, ‘left’] 중에서 선택해야 합니다. 기본값은 동일한 이름의 클래스 속성에서 가져옵니다. - return_tensors (
str또는 TensorType, 선택 사항) — 설정된 경우, Python 정수 목록 대신 텐서를 반환합니다. 허용되는 값은 다음과 같습니다:'pt': PyTorchtorch.Tensor객체를 반환합니다.'np': Numpynp.ndarray객체를 반환합니다.
- return_token_type_ids (
bool, 선택 사항) — 토큰 타입 ID를 반환할지 여부. 기본값으로 두면, 해당 토크나이저의 기본값에 따라 토큰 타입 ID를 반환합니다. 이 기본값은return_outputs속성으로 정의됩니다. - return_attention_mask (
bool, 선택 사항) — attention mask를 반환할지 여부. 기본값으로 두면,return_outputs속성에 의해 정의된 해당 tokenizer의 기본값에 따라 attention mask를 반환합니다. - return_overflowing_tokens (
bool, 선택 사항, 기본값False) — 넘치는 토큰 시퀀스를 반환할지 여부입니다. 입력 ID의 시퀀스 쌍(또는 쌍의 배치)이truncation_strategy = longest_first또는True와 함께 제공되면, 넘치는 토큰을 반환하는 대신 오류가 발생합니다. - return_special_tokens_mask (
bool, 선택 사항, 기본값False) — 특수 토큰 마스크 정보를 반환할지 여부. - return_offsets_mapping (
bool, 선택 사항, 기본값은False) — 각 토큰에 대해(char_start, char_end)를 반환할지 여부입니다.이 기능은 PreTrainedTokenizerFast를 상속하는 빠른 토크나이저에서만 사용할 수 있으며, Python의 토크나이저를 사용하는 경우 이 메서드는
NotImplementedError를 발생시킵니다. - return_length (
bool, 선택 사항, 기본값False) — 인코딩된 입력의 길이를 반환할지 여부. - verbose (
bool, 선택 사항, 기본값True) — 추가 정보와 경고를 출력할지 여부. - **kwargs —
self.tokenize()메서드에 전달됩니다
반환값
다음 필드를 가진 BatchEncoding:
-
input_ids — 모델에 입력할 토큰 ID 목록.
-
token_type_ids — 모델에 입력할 토큰 유형 ID 목록 (
return_token_type_ids=True인 경우 또는self.model_input_names에 “token_type_ids”가 포함된 경우). -
attention_mask — 모델이 어떤 토큰에 주의를 기울여야 하는지 지정하는 인덱스 목록 (
return_attention_mask=True이거나self.model_input_names에 “attention_mask”가 포함된 경우). -
overflowing_tokens — 넘친 토큰 시퀀스 목록(
max_length이 지정되고return_overflowing_tokens=True인 경우). -
num_truncated_tokens — 잘림된 토큰의 개수(
max_length가 지정되고return_overflowing_tokens=True인 경우). -
special_tokens_mask — 0과 1의 목록으로, 1은 추가된 특수 토큰을, 0은 일반 시퀀스 토큰을 나타냅니다(
add_special_tokens=True이고return_special_tokens_mask=True인 경우). -
length — 입력의 길이 (
return_length=True인 경우)
하나 이상의 시퀀스 또는 하나 이상의 시퀀스 쌍을 토큰화하여 모델에 맞게 준비하는 주요 메서드입니다.
save_vocabulary
< source >( save_directory: strfilename_prefix: str | None = None ) → Tuple(str)
어휘 및 특수 토큰 파일을 디렉토리에 저장합니다.
batch_decode
< source >( sequences: list[int] | list[list[int]] | np.ndarray | torch.Tensorskip_special_tokens: bool = Falseclean_up_tokenization_spaces: bool | None = None**kwargs ) → list[str]
매개변수
- sequences (
Union[list[int], list[list[int]], np.ndarray, torch.Tensor]) — 토큰화된 입력 ID 목록입니다.__call__메서드를 사용하여 얻을 수 있습니다. - skip_special_tokens (
bool, 선택 사항, 기본값False) — 디코딩 과정에서 특수 토큰을 제거할지 여부입니다. - clean_up_tokenization_spaces (
bool, 선택) — 토큰화 공백을 정리할지 여부입니다.None인 경우 기본값으로self.clean_up_tokenization_spaces를 사용합니다. - kwargs (추가 키워드 인자, 선택 사항) — 기저 모델의 특정 decode 메서드에 전달됩니다.
반환값
list[str]
디코딩된 문장의 목록입니다.
decode를 호출하여 토큰 ID의 리스트로 된 리스트를 문자열의 리스트로 변환합니다.
이 메서드는 하위 호환성을 위해 제공됩니다. decode 메서드가 이제 배치 입력을 네이티브로 처리하므로, batch_decode 대신 decode를 직접 사용할 수 있습니다.
FastSpeech2ConformerModel
class transformers.FastSpeech2ConformerModel
< source >( config: FastSpeech2ConformerConfig )
매개변수
- config (FastSpeech2ConformerConfig) — 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 연관된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 from_pretrained() 메서드를 확인하세요.
FastSpeech2Conformer 모델.
이 모델은 PreTrainedModel에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대한 세부 사항은 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch torch.nn.Module의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법 및 동작과 관련된 모든 사항은 PyTorch 문서를 참조하세요.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
매개변수
- input_ids (
torch.LongTensor, shape(batch_size, sequence_length)) — 입력 텍스트 벡터 시퀀스입니다. - attention_mask (
torch.LongTensor형상이(batch_size, sequence_length), 선택 사항) — 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 하는 마스크. [0, 1]에서 선택된 마스크 값: 마스크되지 않은 토큰은 1, 마스크된 토큰은 0. attention mask란 무엇인가요?[0, 1]:- 마스크되지 않은 토큰에 대해 1
- 마스크된 토큰에 대해 0
- spectrogram_labels (
torch.Tensor, shape(batch_size, max_spectrogram_length, num_mel_bins), 선택 사항, 기본값None) — 패딩된 대상 특징(batch)입니다. - duration_labels (
torch.LongTensor, shape(batch_size, sequence_length + 1), 선택 사항, 기본값None) — 패딩된 duration 배치입니다. - pitch_labels (
torch.Tensor, shape(batch_size, sequence_length + 1, 1), 선택 사항, 기본값None) — 패딩된 토큰 평균 피치의 배치입니다. - energy_labels (
torch.Tensor, shape(batch_size, sequence_length + 1, 1), 선택 사항, 기본값None) — 패딩된 토큰 평균 에너지 배치입니다. - speaker_ids (
torch.LongTensor, shape(batch_size, 1), 선택 사항, 기본값None) — 모델이 음성 출력의 특징을 조건화하는 데 사용하는 화자 ID입니다. - lang_ids (
torch.LongTensor, shape(batch_size, 1), 선택, 기본값None) — 모델이 음성 출력의 특징을 조건화하는 데 사용하는 언어 ID입니다. - speaker_embedding (
torch.Tensor, shape(batch_size, embedding_dim), 선택 사항, 기본값None) — 음성 특징에 대한 조건부 신호를 포함하는 임베딩입니다. - return_dict (
bool, 선택) — 일반 튜플 대신 ModelOutput를 반환할지 여부. - output_attentions (
bool, 선택 사항) — 모든 attention 레이어의 attentions 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의attentions항목을 참조하세요. - output_hidden_states (
bool, 선택 사항) — 모든 레이어의 hidden states를 반환할지 여부입니다. 자세한 내용은 반환되는 텐서 중hidden_states항목을 참고하세요.
반환값
FastSpeech2ConformerModelOutput 또는 tuple(torch.Tensor)
FastSpeech2ConformerModelOutput 또는 torch.Tensor의 튜플(return_dict=False이 전달되거나 config.return_dict=False인 경우)로, 구성(FastSpeech2ConformerConfig)과 입력에 따라 다양한 요소를 포함합니다.
FastSpeech2ConformerModel의 forward 메서드는 __call__ 특수 메서드를 오버라이드합니다.
이 함수 내에서 forward pass의 레시피를 정의해야 하지만, 이후에는 이 함수 대신
Module인스턴스를 호출해야 합니다. 전자는 전처리 및 후처리 단계를 실행하는 것을 처리하는 반면, 후자는 이를 조용히 무시하기 때문입니다.
loss (
torch.Tensor, shape(1,), 선택 사항,labels이 제공될 때 반환됨) — 스펙트로그램 생성 손실.spectrogram (
torch.Tensor, shape(batch_size, sequence_length, num_bins), 선택 사항) — 예측된 스펙트로그램.encoder_last_hidden_state (
torch.Tensor, shape(batch_size, sequence_length, hidden_size), 선택 사항) — 모델 인코더의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.encoder_hidden_states (
tuple[torch.Tensor], 선택 사항,output_hidden_states=True가 전달되었거나config.output_hidden_states=True인 경우 반환됨) —torch.Tensor의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩의 출력에 대한 것 1개 + 각 레이어의 출력에 대한 것 1개)로, 모양은(batch_size, sequence_length, hidden_size)입니다.각 레이어의 출력에서 인코더의 Hidden-states와 초기 임베딩 출력을 더한 값.
encoder_attentions (
tuple[torch.Tensor], 선택 사항,output_attentions=True가 전달되었거나config.output_attentions=True인 경우 반환됨) — 각 레이어마다 하나씩 포함된torch.Tensor의 튜플로, 모양은(batch_size, num_heads, sequence_length, sequence_length)입니다.self-attention 헤드에서 가중 평균을 계산하는 데 사용되는, attention softmax 이후의 인코더 attention 가중치입니다.
decoder_hidden_states (
tuple[torch.Tensor], 선택 사항,output_hidden_states=True가 전달되거나config.output_hidden_states=True인 경우 반환됨) —torch.Tensor의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩의 출력에 대한 것 1개 + 각 레이어의 출력에 대한 것 1개)로, 모양은(batch_size, sequence_length, hidden_size)입니다.각 레이어의 출력에서 디코더의 Hidden-states와 초기 임베딩 출력을 더한 값.
decoder_attentions (
tuple[torch.Tensor], 선택 사항,output_attentions=True가 전달되거나config.output_attentions=True인 경우 반환됨) — 각 레이어마다 하나씩 포함된torch.Tensor의 튜플로, 모양은(batch_size, num_heads, sequence_length, sequence_length)입니다.self-attention 헤드에서 가중 평균을 계산하는 데 사용되는, attention softmax 이후의 decoder의 attention 가중치입니다.
duration_outputs (
torch.LongTensor, shape(batch_size, max_text_length + 1), 선택 사항) — duration predictor의 출력입니다.pitch_outputs (
torch.Tensor, shape(batch_size, max_text_length + 1, 1), 선택 사항) — 피치 예측기의 출력입니다.energy_outputs (
torch.Tensor, shape(batch_size, max_text_length + 1, 1), 선택 사항) — 에너지 예측기의 출력입니다.
예:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerModel,
...     FastSpeech2ConformerHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerModel.from_pretrained("espnet/fastspeech2_conformer")
>>> output_dict = model(input_ids, return_dict=True)
>>> spectrogram = output_dict["spectrogram"]

>>> vocoder = FastSpeech2ConformerHifiGan.from_pretrained("espnet/fastspeech2_conformer_hifigan")
>>> waveform = vocoder(spectrogram)
>>> print(waveform.shape)
torch.Size([1, 49664])
FastSpeech2ConformerHifiGan
클래스 transformers.FastSpeech2ConformerHifiGan
< source >( config: FastSpeech2ConformerHifiGanConfig )
매개변수
- config (FastSpeech2ConformerHifiGanConfig) — 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 연관된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 from_pretrained() 메서드를 확인하세요.
HiFi-GAN 보코더.
이 모델은 PreTrainedModel에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대한 세부 사항은 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch torch.nn.Module의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법 및 동작과 관련된 모든 사항은 PyTorch 문서를 참조하세요.
forward
< source >( spectrogram: Tensor**kwargs ) → torch.Tensor
매개변수
- spectrogram (
torch.Tensor) — 로그 멜 스펙트로그램을 포함하는 텐서입니다. 배치 형태일 경우(batch_size, sequence_length, config.model_in_dim)형태를, 배치되지 않은 형태일 경우(sequence_length, config.model_in_dim)형태를 가질 수 있습니다.
반환값
torch.Tensor
음성 웨이브포름을 포함하는 Tensor입니다. 입력 스펙트로그램이 배치된 경우, 형태는 (batch_size, num_frames,)입니다. 배치되지 않은 경우, 형태는 (num_frames,)입니다.
log-mel spectrogram을 음성 waveform으로 변환합니다. log-mel spectrogram의 batch를 전달하면 음성 waveform의 batch가 반환됩니다. 단일, 비-batch log-mel spectrogram을 전달하면 단일, 비-batch 음성 waveform이 반환됩니다.
FastSpeech2ConformerWithHifiGan
class transformers.FastSpeech2ConformerWithHifiGan
< source >( config: FastSpeech2ConformerWithHifiGanConfig )
매개변수
- config (FastSpeech2ConformerWithHifiGanConfig) — 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 연관된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 from_pretrained() 메서드를 확인하세요.
FastSpeech2ConformerHifiGan 보코더 헤드를 갖춘 FastSpeech2ConformerModel은 텍스트를 음성(웨이브폼)으로 변환하는 작업을 수행합니다.
이 모델은 PreTrainedModel에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대한 세부 사항은 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch torch.nn.Module의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법 및 동작과 관련된 모든 사항은 PyTorch 문서를 참조하세요.
forward
< source >( input_ids: LongTensorattention_mask: typing.Optional[torch.LongTensor] = Nonespectrogram_labels: typing.Optional[torch.Tensor] = Noneduration_labels: typing.Optional[torch.LongTensor] = Nonepitch_labels: typing.Optional[torch.Tensor] = Noneenergy_labels: typing.Optional[torch.Tensor] = Nonespeaker_ids: typing.Optional[torch.LongTensor] = Nonelang_ids: typing.Optional[torch.LongTensor] = Nonespeaker_embedding: typing.Optional[torch.Tensor] = Nonereturn_dict: bool | None = Noneoutput_attentions: bool | None = Noneoutput_hidden_states: bool | None = None**kwargs ) → FastSpeech2ConformerModelOutput or tuple(torch.Tensor)
매개변수
- input_ids (
torch.LongTensor, shape(batch_size, sequence_length)) — 입력 텍스트 벡터 시퀀스입니다. - attention_mask (
torch.LongTensor형상이(batch_size, sequence_length), 선택 사항) — 패딩 토큰 인덱스에 대한 attention을 수행하지 않도록 하는 마스크. [0, 1]에서 선택된 마스크 값: 마스크되지 않은 토큰은 1, 마스크된 토큰은 0. attention mask란 무엇인가요?[0, 1]:- 마스크되지 않은 토큰에 대해 1
- 마스크된 토큰에 대해 0
- spectrogram_labels (
torch.Tensor, shape(batch_size, max_spectrogram_length, num_mel_bins), 선택 사항, 기본값None) — 패딩된 대상 특징(batch)입니다. - duration_labels (
torch.LongTensor, shape(batch_size, sequence_length + 1), 선택 사항, 기본값None) — 패딩된 duration 배치입니다. - pitch_labels (
torch.Tensor, shape(batch_size, sequence_length + 1, 1), 선택 사항, 기본값None) — 패딩된 토큰 평균 피치의 배치입니다. - energy_labels (
torch.Tensor, shape(batch_size, sequence_length + 1, 1), 선택 사항, 기본값None) — 패딩된 토큰 평균 에너지 배치입니다. - speaker_ids (
torch.LongTensor, shape(batch_size, 1), 선택 사항, 기본값None) — 모델이 음성 출력의 특징을 조건화하는 데 사용하는 화자 ID입니다. - lang_ids (
torch.LongTensor, shape(batch_size, 1), 선택, 기본값None) — 모델이 음성 출력의 특징을 조건화하는 데 사용하는 언어 ID입니다. - speaker_embedding (
torch.Tensor, shape(batch_size, embedding_dim), 선택 사항, 기본값None) — 음성 특징에 대한 조건부 신호를 포함하는 임베딩입니다. - return_dict (
bool, 선택) — 일반 튜플 대신 ModelOutput를 반환할지 여부. - output_attentions (
bool, 선택 사항) — 모든 attention 레이어의 attentions 텐서를 반환할지 여부. 자세한 내용은 반환 텐서 섹션의attentions항목을 참조하세요. - output_hidden_states (
bool, 선택 사항) — 모든 레이어의 hidden states를 반환할지 여부입니다. 자세한 내용은 반환되는 텐서 중hidden_states항목을 참고하세요.
반환값
FastSpeech2ConformerModelOutput 또는 tuple(torch.Tensor)
FastSpeech2ConformerModelOutput 또는 torch.Tensor의 튜플(return_dict=False이 전달되거나 config.return_dict=False인 경우)로, 구성(FastSpeech2ConformerConfig)과 입력에 따라 다양한 요소를 포함합니다.
FastSpeech2ConformerWithHifiGan의 forward 메서드는 __call__ 특수 메서드를 오버라이드합니다.
이 함수 내에서 forward pass의 레시피를 정의해야 하지만, 이후에는 이 함수 대신
Module인스턴스를 호출해야 합니다. 전자는 전처리 및 후처리 단계를 실행하는 것을 처리하는 반면, 후자는 이를 조용히 무시하기 때문입니다.
loss (
torch.Tensor, shape(1,), 선택 사항,labels이 제공될 때 반환됨) — 스펙트로그램 생성 손실.spectrogram (
torch.Tensor, shape(batch_size, sequence_length, num_bins), 선택 사항) — 예측된 스펙트로그램.encoder_last_hidden_state (
torch.Tensor, shape(batch_size, sequence_length, hidden_size), 선택 사항) — 모델 인코더의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.encoder_hidden_states (
tuple[torch.Tensor], 선택 사항,output_hidden_states=True가 전달되었거나config.output_hidden_states=True인 경우 반환됨) —torch.Tensor의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩의 출력에 대한 것 1개 + 각 레이어의 출력에 대한 것 1개)로, 모양은(batch_size, sequence_length, hidden_size)입니다.각 레이어의 출력에서 인코더의 Hidden-states와 초기 임베딩 출력을 더한 값.
encoder_attentions (
tuple[torch.Tensor], 선택 사항,output_attentions=True가 전달되었거나config.output_attentions=True인 경우 반환됨) — 각 레이어마다 하나씩 포함된torch.Tensor의 튜플로, 모양은(batch_size, num_heads, sequence_length, sequence_length)입니다.self-attention 헤드에서 가중 평균을 계산하는 데 사용되는, attention softmax 이후의 인코더 attention 가중치입니다.
decoder_hidden_states (
tuple[torch.Tensor], 선택 사항,output_hidden_states=True가 전달되거나config.output_hidden_states=True인 경우 반환됨) —torch.Tensor의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩의 출력에 대한 것 1개 + 각 레이어의 출력에 대한 것 1개)로, 모양은(batch_size, sequence_length, hidden_size)입니다.각 레이어의 출력에서 디코더의 Hidden-states와 초기 임베딩 출력을 더한 값.
decoder_attentions (
tuple[torch.Tensor], 선택 사항,output_attentions=True가 전달되거나config.output_attentions=True인 경우 반환됨) — 각 레이어마다 하나씩 포함된torch.Tensor의 튜플로, 모양은(batch_size, num_heads, sequence_length, sequence_length)입니다.self-attention 헤드에서 가중 평균을 계산하는 데 사용되는, attention softmax 이후의 decoder의 attention 가중치입니다.
duration_outputs (
torch.LongTensor, shape(batch_size, max_text_length + 1), 선택 사항) — duration predictor의 출력입니다.pitch_outputs (
torch.Tensor, shape(batch_size, max_text_length + 1, 1), 선택 사항) — 피치 예측기의 출력입니다.energy_outputs (
torch.Tensor, shape(batch_size, max_text_length + 1, 1), 선택 사항) — 에너지 예측기의 출력입니다.
예:
>>> from transformers import (
...     FastSpeech2ConformerTokenizer,
...     FastSpeech2ConformerWithHifiGan,
... )

>>> tokenizer = FastSpeech2ConformerTokenizer.from_pretrained("espnet/fastspeech2_conformer")
>>> inputs = tokenizer("some text to convert to speech", return_tensors="pt")
>>> input_ids = inputs["input_ids"]

>>> model = FastSpeech2ConformerWithHifiGan.from_pretrained("espnet/fastspeech2_conformer_with_hifigan")
>>> output_dict = model(input_ids, return_dict=True)
>>> waveform = output_dict["waveform"]
>>> print(waveform.shape)
torch.Size([1, 49664])